NadirClaw: ahorro en solicitudes de LLM con enrutamiento inteligente de prompts
Los desarrolladores ahora pueden usar NadirClaw para el enrutamiento inteligente de solicitudes de LLM. El sistema clasifica automáticamente los prompts simples a modelos de menor costo y los complejos a modelos más capaces. Funciona localmente mediante CLI o como biblioteca de Python, reduciendo los costos de API.
Procesado por IA desde MarkTechPost; editado por Hamidun News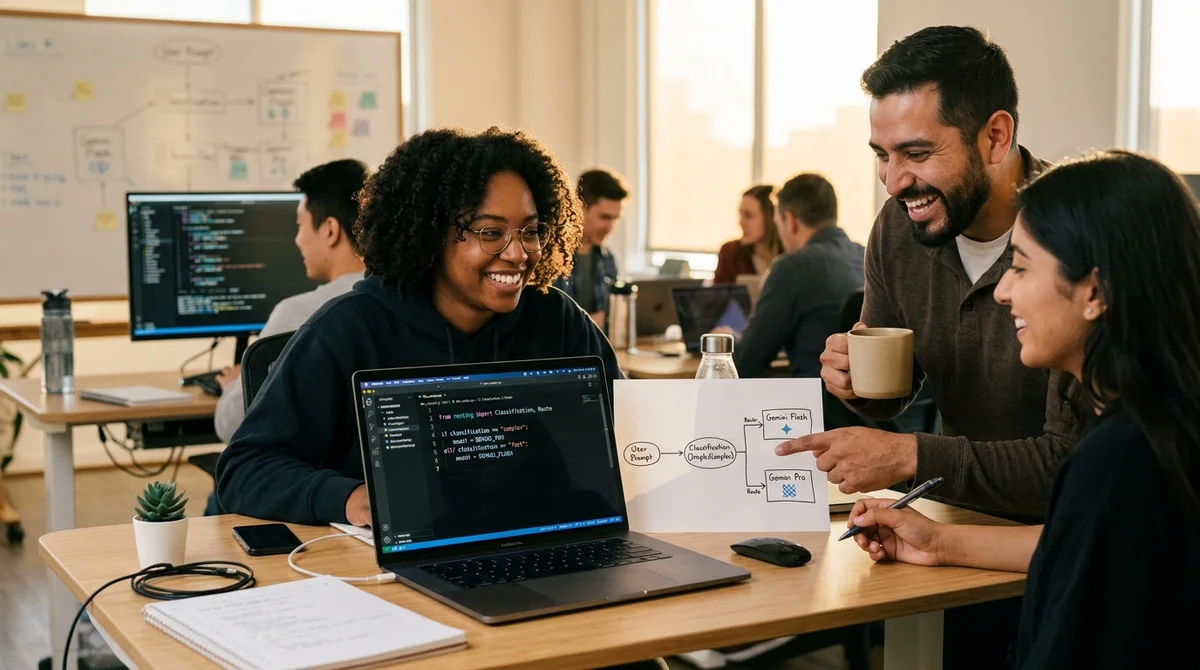
NadirClaw es un sistema de enrutamiento inteligente de solicitudes LLM que clasifica prompts como simples o complejos directamente en el dispositivo del usuario, sin enviar datos a servidores. Luego selecciona automáticamente el modelo apropiado — económico para tareas simples, potente para las complejas. Resultado: ahorro significativo en costos de API sin pérdida de calidad.
Cómo Funciona el Enrutamiento
NadirClaw funciona en tres etapas. Primero, un clasificador local analiza el prompt de entrada y determina si es una solicitud simple o compleja — sin hacer llamadas a la API externa. Este es el momento clave: la clasificación ocurre en el lado del cliente, lo que evita gastos innecesarios. El prompt nunca se envía a ningún lugar; permanece privado y se procesa localmente.
Luego, el sistema selecciona el modelo apropiado. Las solicitudes simples se enrutan a opciones más económicas, como Gemini 1.5 Flash, mientras que las tareas analíticas o creativas complejas van a versiones más potentes, como Gemini 2.0 Pro. Los desarrolladores pueden personalizar rutas y umbrales de clasificación según sus necesidades — establecer en qué nivel de complejidad cambiar a un modelo costoso. Esta es una flexibilidad que los modelos de precios fijos no tienen.
La tercera etapa es ejecutar la solicitud en el modelo seleccionado y devolver el resultado. Todo el proceso lleva milisegundos, y el usuario obtiene una respuesta casi instantáneamente. Mientras tanto, los análisis de enrutamiento permanecen en el lado del usuario y no se recopilan centralmente, lo que aumenta la privacidad.
Dónde Ahorrar
La economía es la principal ventaja de este enfoque. La mayoría de las aplicaciones reciben tráfico mixto: algunas solicitudes requieren procesamiento complejo, pero la mayoría son simples y rutinarias. Si envías todo a un modelo poderoso (y caro), los costos crecen linealmente. NadirClaw resuelve este problema:
- Las solicitudes simples (definiciones de palabras, análisis JSON, resúmenes breves) cuestan 10 veces menos
- Clasificación local — costos cero para identificar el tipo de tarea, sin involucrar un LLM
- Aplicaciones a gran escala — si 70–80% de las tareas son simples, los costos generales caen un tercio o más
- Almacenamiento en caché de contexto largo — funciona igualmente bien con modelos económicos y costosos
- Sin llamadas a API redundantes — solo solicitudes necesarias a servicios pagados
Puedes usar NadirClaw de dos maneras. Primero — incrustarlo en tu aplicación a través de una biblioteca Python, que enrutará solicitudes automáticamente en segundo plano. Segundo — experimentar a través de CLI para entender qué umbrales de clasificación funcionan mejor para tu escenario. La instalación es mínima, la configuración lleva minutos, y la integración no requiere cambios en la lógica principal de tu aplicación.
Qué Significa Esto
En un mundo donde los costos de API de LLM crecen con la escala de la aplicación, NadirClaw ofrece una forma práctica de optimizar gastos. Esto es especialmente útil para sistemas con grandes volúmenes de solicitudes simples — chatbots de soporte, sistemas de FAQ, clasificación de texto, moderación de contenido, procesamiento de solicitudes.
Ahora los desarrolladores tienen una herramienta para mantener los costos bajo control sin sacrificar la calidad para tareas analíticas y creativas complejas. Este es un paso hacia un uso más responsable y económico de LLMs en producción.
- 29 oct 2026Anthropic muestra en su S-1: 11 900 clientes pagan desde $100 mil al año
- 29 oct 2026Google DeepMind encuentra un fallo en softmax: el gradiente se anula con un margen de 16,6
- 28 oct 2026Una CNN de 2015 supera a GPT-6 Astra y Claude Fable 5.1 en el diagnóstico del cáncer de piel
- 28 oct 2026Google enseña a un LLM a «dormir»: SLEEP fija el conocimiento en los pesos, hasta 10 millones de tokens
Preguntas frecuentes sobre la noticia
Cómo Funciona el Enrutamiento?
NadirClaw funciona en tres etapas. Primero, un clasificador local analiza el prompt de entrada y determina si es una solicitud simple o compleja — sin hacer llamadas a la API externa. Este es el momento clave: la clasificación ocurre en el lado del cliente, lo que evita gastos innecesarios. El prompt nunca se envía a ningún lugar; permanece privado y se procesa localmente. Luego, el sistema selecciona el modelo apropiado. Las solicitudes simples se enrutan a opciones más económicas, como Gemini 1.5 Flash, mientras que las tareas analíticas o creativas complejas van a versio
Dónde Ahorrar?
La economía es la principal ventaja de este enfoque. La mayoría de las aplicaciones reciben tráfico mixto: algunas solicitudes requieren procesamiento complejo, pero la mayoría son simples y rutinarias. Si envías todo a un modelo poderoso (y caro), los costos crecen linealmente. NadirClaw resuelve este problema: Las solicitudes simples (definiciones de palabras, análisis JSON, resúmenes breves) cuestan 10 veces menos Clasificación local — costos cero para identificar el tipo de tarea, sin involucrar un LLM Aplicaciones a gran escala — si 70–80% de las tareas son simples, lo
¿Qué se sabe sobre Qué Significa Esto?
En un mundo donde los costos de API de LLM crecen con la escala de la aplicación, NadirClaw ofrece una forma práctica de optimizar gastos. Esto es especialmente útil para sistemas con grandes volúmenes de solicitudes simples — chatbots de soporte, sistemas de FAQ, clasificación de texto, moderación de contenido, procesamiento de solicitudes. Ahora los desarrolladores tienen una herramienta para mantener los costos bajo control sin sacrificar la calidad para tareas analíticas y creativas complejas. Este es un paso hacia un uso más responsable y económico de LLMs en producció
Build & Ship Production AI Agents Without Boilerplate Code
Start your free 72-hour trial at Hamidun Academy (academy.hamidun.com) — interactive lessons on Claude Code & Cursor, live Tech Radar, and production agent templates.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.