NadirClaw: ahorrar en IA mediante el enrutamiento de consultas
Los desarrolladores ya pueden usar NadirClaw para enrutar de forma inteligente las consultas a LLM. El sistema envía automáticamente los prompts simples a modelos baratos y los complejos a modelos potentes. Funciona en local mediante CLI o como biblioteca de Python, y reduce el gasto en API.
Procesado por IA desde MarkTechPost; editado por Hamidun News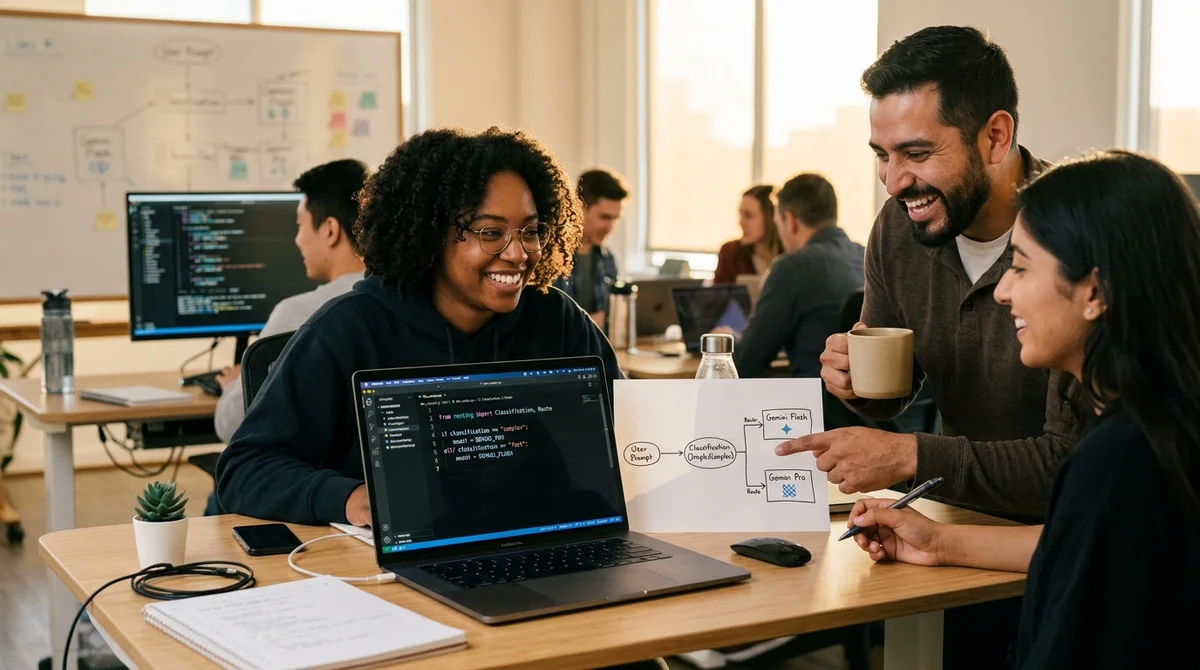
NadirClaw es un sistema de enrutamiento inteligente de consultas a IA. Clasifica los prompts como simples o complejos directamente en el dispositivo del usuario, sin enviar datos a ningún servidor. Después elige automáticamente un modelo adecuado: uno barato para tareas simples y uno potente para las complejas. El resultado: un ahorro significativo en costes de API sin perder calidad.
¿Cómo funciona el enrutamiento de consultas en NadirClaw?
NadirClaw analiza cada prompt entrante con un clasificador local y determina si la consulta es simple o compleja. Después elige automáticamente un modelo adecuado: uno barato para tareas simples y uno potente para las complejas.
¿Por qué el enrutamiento ahorra dinero en las API?
El sistema envía las consultas simples a modelos económicos (bajo coste por consulta) y las complejas a modelos potentes (precio más alto, pero se necesitan pocas veces). El resultado: un ahorro significativo en costes de API sin perder calidad.
¿Cómo ahorrar en las consultas a la IA?
NadirClaw enruta las consultas: las tareas simples van a modelos baratos y las complejas a modelos potentes, lo que reduce el coste sin perder calidad. La clasificación se hace en local, en el dispositivo del usuario, sin enviar datos a ningún servidor.
¿Por qué el enrutamiento ahorra dinero?
Las tareas simples no necesitan el modelo más potente. NadirClaw elige automáticamente el modelo adecuado, barato para las consultas simples y potente para las complejas, y optimiza así el gasto en API.
Preguntas frecuentes sobre la noticia
¿Cómo funciona el enrutamiento de consultas en NadirClaw?
NadirClaw analiza cada prompt entrante con un clasificador local y determina si la consulta es simple o compleja. Después elige automáticamente un modelo adecuado: uno barato para tareas simples y uno potente para las complejas.
¿Por qué el enrutamiento ahorra dinero en las API?
El sistema envía las consultas simples a modelos económicos (bajo coste por consulta) y las complejas a modelos potentes (precio más alto, pero se necesitan pocas veces). El resultado: un ahorro significativo en costes de API sin perder calidad.
¿Cómo ahorrar en las consultas a la IA?
NadirClaw enruta las consultas: las tareas simples van a modelos baratos y las complejas a modelos potentes, lo que reduce el coste sin perder calidad. La clasificación se hace en local, en el dispositivo del usuario, sin enviar datos a ningún servidor.
¿Por qué el enrutamiento ahorra dinero?
Las tareas simples no necesitan el modelo más potente. NadirClaw elige automáticamente el modelo adecuado, barato para las consultas simples y potente para las complejas, y optimiza así el gasto en API.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.