Hugging Face acelera un 22% la inferencia de LLM con procesamiento por lotes asíncrono
Hugging Face ha incorporado la asincronía a la inferencia de LLM. En lugar de trabajar por turnos, la CPU y la GPU lo hacen ahora en paralelo: mientras la GPU calcula un lote, la CPU prepara el siguiente. El resultado es una aceleración del 22%. No hay kernels nuevos. El cambio consiste en reorganizar los flujos (streams) de CUDA y la memoria.
Procesado por IA desde Hugging Face Blog; editado por Hamidun News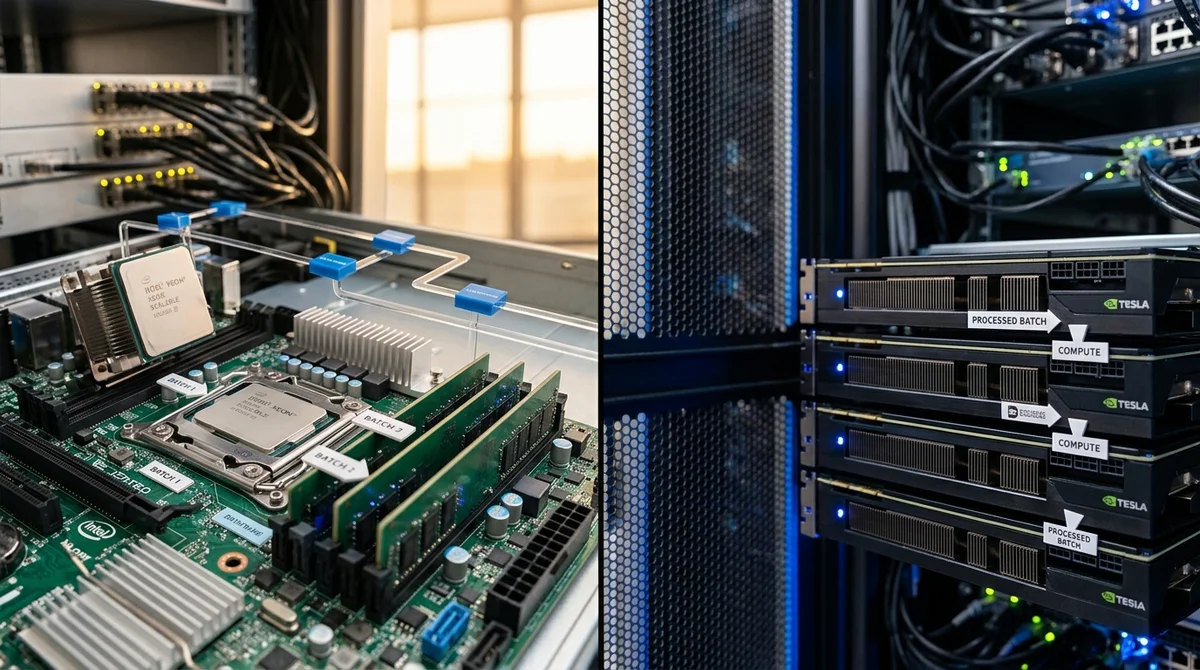
Hugging Face ha encontrado una forma sencilla de acelerar un 22% la generación de tokens en los LLM: hacer que la CPU y la GPU trabajen a la vez en lugar de esperarse mutuamente. No requiere reentrenar los modelos ni nuevos algoritmos.
Cuál era el problema
En el procesamiento por lotes síncrono habitual, la CPU prepara los datos, después la GPU los calcula, y luego la CPU espera los resultados y prepara el siguiente lote. La GPU queda inactiva alrededor del 24% del tiempo mientras la CPU se ocupa del preprocesamiento. Es como una cadena de montaje en la que, en cada paso, alguien mira el reloj. Incluso con la CPU a plena carga, es más lenta que el cálculo más simple de la GPU, así que la tarjeta gráfica se queda esperando datos nuevos.
Con lotes síncronos, un modelo de 8.000 millones de parámetros con un tamaño de lote de 32 generaba 8K tokens en 300 segundos, con la GPU activa solo el 76% del tiempo.
Cómo resuelve la asincronía el problema
La idea es muy sencilla: ejecutar CPU y GPU en paralelo mediante flujos de CUDA (streams). Se usan tres flujos independientes: uno para transferir datos a la GPU (H2D), otro para los cálculos (Compute) y otro para la transferencia de vuelta (D2H). Cada flujo devuelve el control a la CPU de inmediato, sin bloquearla.
Entre los flujos se colocan eventos de CUDA (events), balizas que garantizan el orden correcto:
- El flujo H2D marca cuándo los datos ya están cargados en la GPU
- El flujo Compute espera esa baliza, calcula y coloca la suya
- El flujo D2H espera a que terminen los cálculos y extrae los resultados
Mientras la GPU procesa el lote N, la CPU ya prepara el lote N+1 en otro búfer de memoria. Sin esperas: ambas trabajan en paralelo.
El gran truco: el carry-over
La dificultad está en que, cuando una solicitud abarca varios lotes, sus tokens de salida del lote N pasan a ser la entrada del lote N+1. Hugging Face lo resolvió con marcadores de posición (placeholders): al preparar el lote N+1, coloca ceros en lugar de las entradas de los tokens futuros, y cuando el lote N termina, sustituye los ceros por los valores reales.
«Esto permite a la CPU preparar el siguiente lote sin esperar los resultados del actual», explican en
Hugging Face.
Todo se apoya en grafos de CUDA con un pool de memoria compartido, lo que incluso ahorra memoria de vídeo.
Los números hablan por sí solos
Antes de la optimización: GPU activa al 76%, generar 8K tokens tardaba 300.6 segundos. Después: GPU activa al 99.4%, los mismos tokens en 234.5 segundos. La aceleración del 22% es casi el límite para esta arquitectura (el máximo teórico era del 24%).
Qué significa
No hacen falta GPU más caras ni reentrenar los modelos para lograr un aumento notable de velocidad. El código ya está en la biblioteca Transformers, en la clase `ContinuousBatchingAsyncIOs`. Para las empresas que generan muchos tokens, esto podría ahorrar millones en hardware.
- 2 nov 2026Karpathy montó en dos horas un clon de YouTube con 6454 vídeos recomendados en Hacker News
- 2 nov 2026Karpathy usó Claude para crear HackerTube, con 6454 vídeos recomendados en Hacker News
- 2 nov 2026Microsoft lanza Mage-VL-Cowork, un modelo de 4B que resuelve el 66,0% de las tareas de OSWorld-Verified
- 1 nov 2026Los modelos locales pierden ante Opus y Codex: 0,21 puntos en un MacBook frente a 1,00 de Codex
Preguntas frecuentes sobre la noticia
¿Qué se sabe sobre Cuál era el problema?
En el procesamiento por lotes síncrono habitual, la CPU prepara los datos, después la GPU los calcula, y luego la CPU espera los resultados y prepara el siguiente lote. La GPU queda inactiva alrededor del 24% del tiempo mientras la CPU se ocupa del preprocesamiento. Es como una cadena de montaje en la que, en cada paso, alguien mira el reloj. Incluso con la CPU a plena carga, es más lenta que el cálculo más simple de la GPU, así que la tarjeta gráfica se queda esperando datos nuevos. Con lotes síncronos, un modelo de 8.000 millones de parámetros con un tamaño de lote de 32
Cómo resuelve la asincronía el problema?
La idea es muy sencilla: ejecutar CPU y GPU en paralelo mediante flujos de CUDA (streams). Se usan tres flujos independientes: uno para transferir datos a la GPU (H2D), otro para los cálculos (Compute) y otro para la transferencia de vuelta (D2H). Cada flujo devuelve el control a la CPU de inmediato, sin bloquearla. Entre los flujos se colocan eventos de CUDA (events), balizas que garantizan el orden correcto: El flujo H2D marca cuándo los datos ya están cargados en la GPU El flujo Compute espera esa baliza, calcula y coloca la suya El flujo D2H espera a que terminen los cá
¿Qué se sabe sobre El gran truco: el carry-over?
La dificultad está en que, cuando una solicitud abarca varios lotes, sus tokens de salida del lote N pasan a ser la entrada del lote N+1. Hugging Face lo resolvió con marcadores de posición (placeholders): al preparar el lote N+1, coloca ceros en lugar de las entradas de los tokens futuros, y cuando el lote N termina, sustituye los ceros por los valores reales. «Esto permite a la CPU preparar el siguiente lote sin esperar los resultados del actual», explican en Hugging Face. Todo se apoya en grafos de CUDA con un pool de memoria compartido, lo que incluso ahorra memoria de
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.