Cómo evitar la fuga de datos en machine learning: Target Encoding
El target encoding parece una forma sencilla de tratar variables categóricas, pero una implementación ingenua filtra sin que se note el objetivo en el conjunto de entrenamiento. Las métricas de validación son excelentes, pero el modelo no funciona en producción. El artículo explica dónde se produce la fuga (leakage) y muestra implementaciones correctas con Leave-One-Out y K-Fold, para obtener un resultado honesto y no cifras bonitas en un panel.
Procesado por IA desde Habr AI; editado por Hamidun News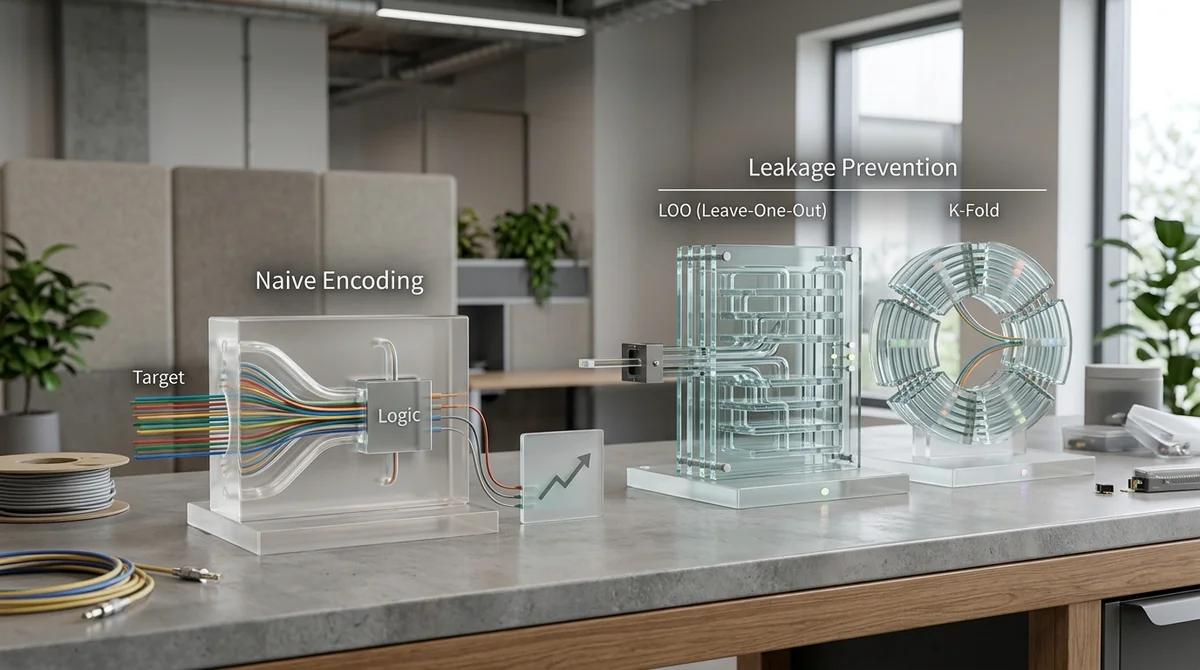
El target encoding es un método de machine learning para codificar variables categóricas, pero su implementación ingenua provoca de forma sistemática una fuga de datos e infla las métricas del modelo en las pruebas, y después el modelo se desmorona en producción.
¿Qué es el target encoding en machine learning?
El target encoding sustituye cada valor único de una variable categórica por la media de la variable objetivo en esa categoría. Por ejemplo, a cada ciudad se le asigna el valor medio de ventas de los clientes de esa ciudad.
Ship AI Faster with Founders, Engineers & Weekly Architecture Reviews
Inside Vibe Club (hamidun.com/club) — weekly live masterminds with Zhemal Khamidun, Tech Radar, full LMS access, and 370+ production Claude Code skills.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.