Habr AI muestra cómo funciona una cámara virtual para Shorts y Reels con seguimiento facial
Habr AI ha publicado un análisis detallado de una cámara virtual para Shorts y Reels. En lugar de un simple autorrecorte, el autor montó un pipeline de producción con una cascada de detectores, seguimiento facial, filtrado anti-jerk y un modelo físico del movimiento de la cámara. El resultado es un encuadre vertical que no se comporta como un recortador a tirones, sino como un operador con inercia y un modo de respaldo. Además, incluye una transición suave tipo Ken Burns para cuando el rostro desaparece del encuadre.
Procesado por IA desde Habr AI; editado por Hamidun News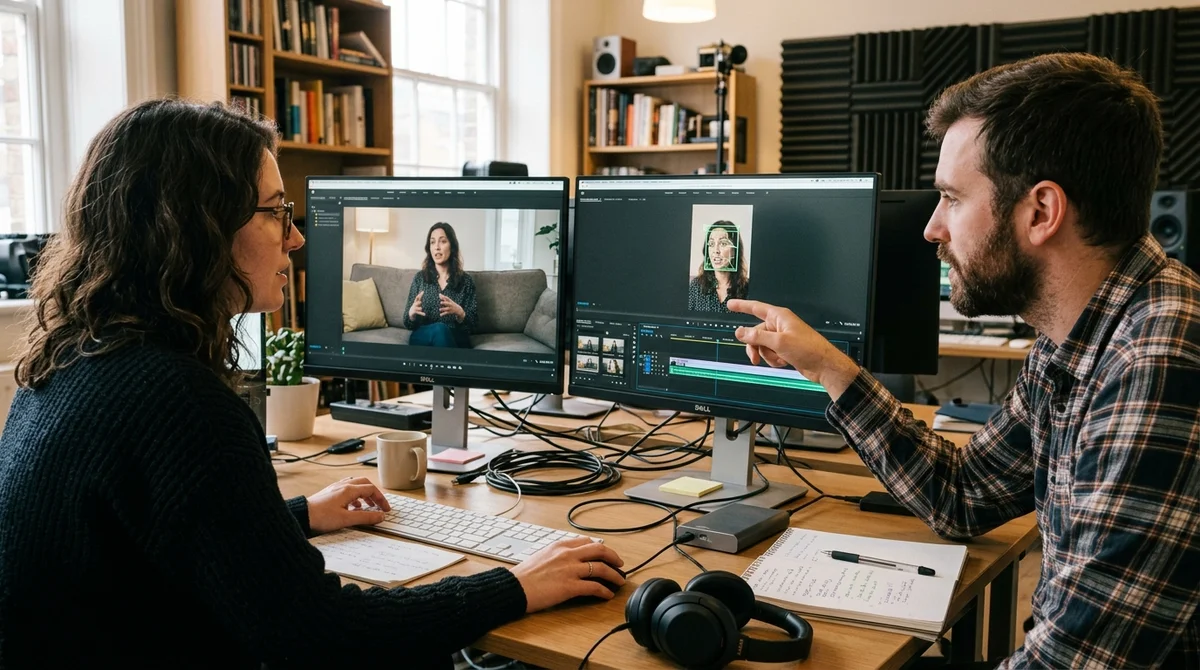
Habr AI ha publicado un análisis detallado de una cámara virtual para vídeo vertical que convierte un clip horizontal normal en Shorts o Reels sin el autorrecorte a tirones. El autor describe un pipeline de producción en el que la cámara sigue el rostro no por una única caja delimitadora, sino como un sistema dinámico independiente.
Por qué falla el autorrecorte
En el papel, la tarea parece sencilla: tomar el fotograma original 16:9, recortar una ventana 9:16 y mantener a la persona en el centro. En un vídeo real, este enfoque se desmorona rápido. El rostro puede desplazarse a izquierda o derecha, puede aparecer una segunda persona en el encuadre y el propio detector unas veces generará ruido y otras perderá el objetivo en un giro de cabeza, un reflejo o un gesto. El resultado es que el clip vertical empieza a parecerse a un autofoco antiguo: la imagen salta nerviosamente y falla de continuo con la composición.
El autor propone abordar la tarea no como un autorrecorte, sino como una cámara virtual con inercia propia, límite de velocidad, retardo de reacción y lógica de respaldo. Por eso no basta con que el sistema "siga el centro de la caja". Debe funcionar a lo largo del tiempo, tolerar datos imprecisos, no entrar en pánico ante pérdidas breves del rostro y mantener un movimiento con sentido incluso en escenas sin ningún rostro en cuadro. Esto es crítico en fragmentos largos.
«Una cámara no es una coordenada, sino un sistema dinámico».
Cómo está construido el pipeline
La base de la solución es una cadena de detección facial de tres niveles: MediaPipe → YuNet → Haar Cascade. El primer detector es la opción de trabajo principal, el segundo sirve como backend ONNX de respaldo a través de OpenCV y el tercero queda como última línea de defensa cuando todo lo demás no está disponible o ha funcionado mal. Hacia fuera, la cadena entrega un formato de datos único: centro del rostro, tamaño, confidence y bounding box. Gracias a ello, el resto del sistema no depende de un detector concreto y puede funcionar de forma estable incluso en modo degradado.
Sobre la detección se añade un seguimiento sencillo pero práctico: el sistema compara el centro del rostro en el fotograma anterior con los candidatos actuales y elige el objeto más cercano. Si el rostro desaparece por poco tiempo, se activa un grace period: la cámara confía durante un breve lapso en la última posición conocida para no dar un tirón por un error aislado. Después, la señal se limpia en dos pasos adicionales y recibe un fallback aparte para escenas sin rostros en el clip.
- Anti-jerk recorta los saltos de coordenadas demasiado grandes entre fotogramas
- Low-pass filter suaviza el ruido residual y el micro-temblor
- Ken Burns fallback toma el control de la escena si el rostro se pierde o no existe
- Interpolación de trayectoria convierte el análisis a 8 FPS en un movimiento fluido para los 30 o 60 FPS finales
En la etapa final, el sistema no se limita a almacenar estados discretos de la cámara, sino que construye una trayectoria continua. Después, para cada fotograma toma el centro y el zoom, calcula el ROI, recorta la zona necesaria y la escala al formato vertical final. Así el pipeline se mantiene razonable en coste computacional: el análisis puede hacerse sobre una copia reducida del vídeo y el recorte final, sobre el original, sin perder fluidez de movimiento en el renderizado final.
Cómo la cámara se convierte en operador
La parte más interesante es el modelo de movimiento. En lugar de saltar al instante al punto objetivo, la cámara se describe como un oscilador amortiguado: tiene "masa", rigidez, amortiguación, límites de aceleración y velocidad máxima. Este esquema aporta inercia y hace el desplazamiento verosímil. Si la persona empieza a moverse más rápido, se puede añadir un predictive lead para que la cámara mire ligeramente hacia delante y no solo alcance al objetivo. Paradójicamente, un pequeño retardo artificial, el human lag, también mejora el resultado: una reacción perfectamente precisa suele parecer menos natural que una algo ralentizada.
Sobre la física, el autor superpone reglas de composición. La cámara puede desplazar el rostro hacia las líneas de los tercios, subir el punto de atención cerca del nivel de los ojos, ignorar los micromovimientos dentro de una dead zone y dejar un face margin de seguridad para no cortar orejas, pelo ni gestos en los bordes del encuadre. Para las escenas de talking head hay un modo single-face aparte, con velocidad más conservadora y estabilización reforzada, y para los clips sin rostros, una transición suave a Ken Burns con panorámica y zoom en lugar de un centro "congelado".
Qué significa
Este análisis muestra bien hacia dónde van las herramientas de edición de vídeo con IA. La calidad no nace de un único modelo "mágico", sino de un ensamblaje de ingeniería: detectores de respaldo, seguimiento, filtrado, física del movimiento y composición trabajan juntos. Para creadores de contenido y equipos que cortan en masa vídeos largos en Shorts y Reels, ya no es un autorrecorte de juguete, sino una plantilla práctica de cámara de producción que se puede reproducir y adaptar a distintos estilos de grabación.
Preguntas frecuentes sobre la noticia
¿Qué se sabe sobre Por qué falla el autorrecorte?
En el papel, la tarea parece sencilla: tomar el fotograma original 16:9, recortar una ventana 9:16 y mantener a la persona en el centro. En un vídeo real, este enfoque se desmorona rápido. El rostro puede desplazarse a izquierda o derecha, puede aparecer una segunda persona en el encuadre y el propio detector unas veces generará ruido y otras perderá el objetivo en un giro de cabeza, un reflejo o un gesto. El resultado es que el clip vertical empieza a parecerse a un autofoco antiguo: la imagen salta nerviosamente y falla de continuo con la composición. El autor propone abo
Cómo está construido el pipeline?
La base de la solución es una cadena de detección facial de tres niveles: MediaPipe → YuNet → Haar Cascade. El primer detector es la opción de trabajo principal, el segundo sirve como backend ONNX de respaldo a través de OpenCV y el tercero queda como última línea de defensa cuando todo lo demás no está disponible o ha funcionado mal. Hacia fuera, la cadena entrega un formato de datos único: centro del rostro, tamaño, confidence y bounding box. Gracias a ello, el resto del sistema no depende de un detector concreto y puede funcionar de forma estable incluso en modo degradad
Cómo la cámara se convierte en operador?
La parte más interesante es el modelo de movimiento. En lugar de saltar al instante al punto objetivo, la cámara se describe como un oscilador amortiguado: tiene "masa", rigidez, amortiguación, límites de aceleración y velocidad máxima. Este esquema aporta inercia y hace el desplazamiento verosímil. Si la persona empieza a moverse más rápido, se puede añadir un predictive lead para que la cámara mire ligeramente hacia delante y no solo alcance al objetivo. Paradójicamente, un pequeño retardo artificial, el human lag, también mejora el resultado: una reacción perfectamente p
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.