El STM32N6 de STMicroelectronics reconoce voz en local, sin nube, con 0,2 W
El microcontrolador STM32N6, con NPU integrada, logró reconocer habla libre directamente en el dispositivo, sin nube y con un consumo de unos 0,215 W. Por ahora solo está listo el modelo acústico: genera fonemas en tiempo real, mientras que el decodificador y el modelo de lenguaje siguen en desarrollo. Aun así, el proyecto demuestra que las interfaces de voz locales para el hogar inteligente, la industria y la electrónica vestible se vuelven prácticas.
Procesado por IA desde Habr AI; editado por Hamidun News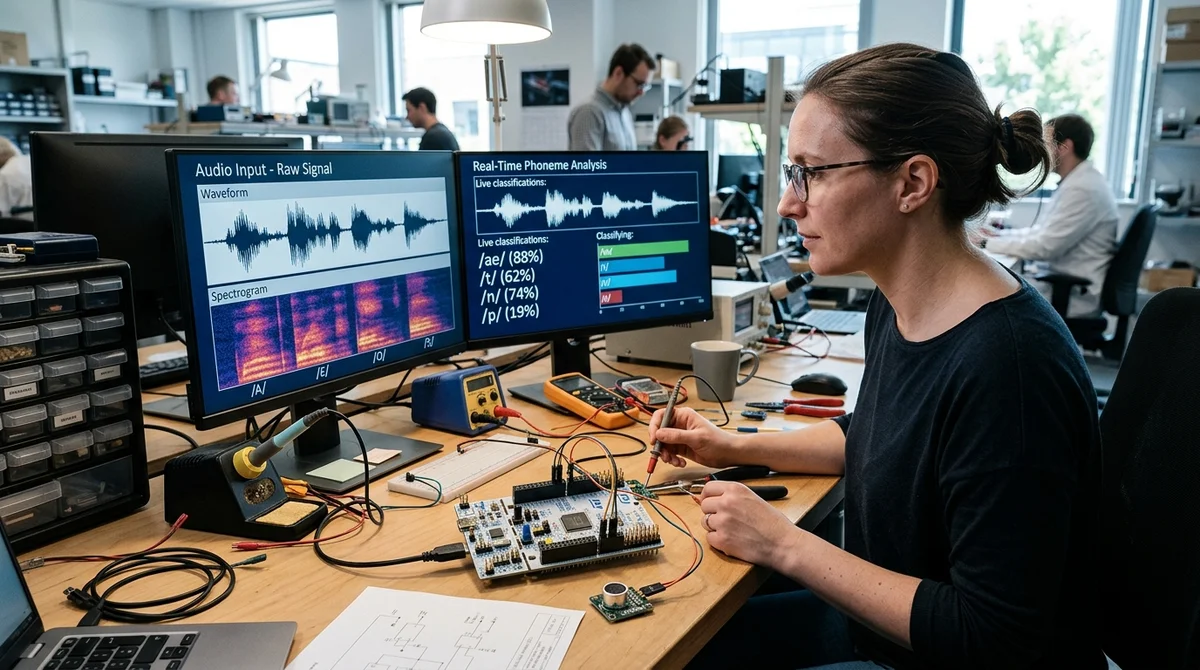
Los microcontroladores con NPU integrada empiezan a entrar en un terreno que antes pertenecía casi por completo a los servicios de reconocimiento de voz en la nube. Un experimento con el STM32N6 ha demostrado que el reconocimiento local de habla libre ya puede ejecutarse directamente en el dispositivo, sin internet, casi en tiempo real y con un consumo de unos 0,215 W.
Cómo funciona el sistema
El autor del proyecto montó el reconocimiento de voz en tres bloques: un modelo acústico, un decodificador y un módulo de rescoring. La parte más pesada es la acústica: recibe la señal de audio en bruto del micrófono y la convierte en una secuencia de fonemas. El decodificador debe construir palabras a partir de esos fonemas, y el bloque de rescoring, revisar el resultado teniendo en cuenta el contexto. En esta etapa, lo que ya funciona en el STM32N6 es el modelo acústico, es decir, el cimiento clave de todo el sistema.
En la práctica, el dispositivo escucha el habla en tiempo real, la procesa en la NPU y emite un flujo de fonemas. En la demostración, arriba se muestran palabras y números, y abajo los fonemas «en bruto» que predice el modelo. Por ahora, la conversión de fonemas a palabras se hace mediante una correspondencia rígida, no con un decodificador de lenguaje completo. Por eso el sistema aún es limitado, pero el hecho de que el modelo acústico funcione en local en un microcontrolador ya pesa más que el andamiaje actual que lo rodea.
Cifras y limitaciones
El resultado más sólido es el consumo energético. Durante el reconocimiento activo, todo el sistema consume unos 215 mW. De ellos, unos 160 mW van a la NPU y al núcleo Cortex-M55, otros 45 mW a la memoria externa Flash y PSRAM, y unos 10 mW a los pines externos. Y no se trata de un modo optimizado: el núcleo todavía no usa un modo de suspensión agresivo y la NPU está cargada solo al 10,4 %, así que aún hay margen para reducir el consumo.
En calidad, el resultado también resulta serio para hardware de esta clase. El modelo tiene 8,5 millones de parámetros, apenas perdió precisión tras la cuantización a int8 y en el dispositivo objetivo alcanzó un PER del 5,3 % en dev_clean y del 14,4 % en dev_other. La inferencia en la NPU tardó 52 ms por cada 500 ms de audio, y la latencia total fue de 985 ms. Casi la mitad de ese retraso no se debe al hardware, sino a la «ventana hacia el futuro» que usa el modelo para predecir los fonemas con más precisión.
- Tamaño del modelo acústico: 8,5 millones de parámetros
- Consumo durante el reconocimiento: unos 0,215 W
- Tiempo de inferencia de la NPU: 52 ms por 500 ms de audio
- Pérdida de calidad tras la cuantización a int8: menos del 0,5 %
- Uso de RAM: 18 %, carga de la NPU: 10,4 %
La comparación con sistemas mayores merece mención aparte. En PER, este modelo resultó comparable a wav2vec 2.0 Base y HuBERT Base, aunque estos son unas 11 veces más grandes y no están pensados para funcionar en microcontroladores. Además, el autor señala con honestidad los límites del proyecto: aún no sustituye al dictado de texto completo, sino que es más bien un motor local para comandos y frases cortas donde la autonomía y el ahorro de energía son críticos.
Dónde gana el microcontrolador
La fortaleza de este enfoque no es la universalidad a toda costa, sino cubrir el hueco entre el simple keyword spotting y el pesado ASR en la nube. Las interfaces de voz locales habituales esperan una coincidencia exacta del comando, mientras que aquí el dispositivo ya puede interpretar distintas formulaciones de la misma petición. En lugar de una frase fija, el usuario puede decir «sube un poco la temperatura», «súbela cinco grados» o «temperatura arriba», y el sistema entenderá una sola acción.
De ahí surgen escenarios bastante prácticos: un hogar inteligente que no envía la voz al exterior, entrada por voz de números y parámetros en la producción, y trabajo en almacenes, equipos médicos y transporte, donde la red es inestable o directamente no existe.
Otra ventaja es el margen de crecimiento. Ahora mismo el STM32N6 usa solo el 18 % de la RAM y la NPU se aprovecha en aproximadamente una décima parte. Los siguientes pasos están claros: añadir un decodificador de fonemas, un modelo de lenguaje y supresión de ruido. Eso es lo que debería convertir un prototipo técnico convincente en una interfaz de usuario realmente útil.
Qué significa
El STM32N6 no elimina el reconocimiento de voz en la nube, pero muestra que ya se pueden trasladar con seguridad ciertas tareas al borde de la red. Donde importan la autonomía, la privacidad, el precio y el bajo consumo, los MCU con NPU empiezan a parecer no un experimento, sino una nueva clase práctica de interfaces de voz.
Preguntas frecuentes sobre la noticia
Cómo funciona el sistema?
El autor del proyecto montó el reconocimiento de voz en tres bloques: un modelo acústico, un decodificador y un módulo de rescoring. La parte más pesada es la acústica: recibe la señal de audio en bruto del micrófono y la convierte en una secuencia de fonemas. El decodificador debe construir palabras a partir de esos fonemas, y el bloque de rescoring, revisar el resultado teniendo en cuenta el contexto. En esta etapa, lo que ya funciona en el STM32N6 es el modelo acústico, es decir, el cimiento clave de todo el sistema. En la práctica, el dispositivo escucha el habla en tie
¿Qué se sabe sobre Cifras y limitaciones?
El resultado más sólido es el consumo energético. Durante el reconocimiento activo, todo el sistema consume unos 215 mW. De ellos, unos 160 mW van a la NPU y al núcleo Cortex-M55, otros 45 mW a la memoria externa Flash y PSRAM, y unos 10 mW a los pines externos. Y no se trata de un modo optimizado: el núcleo todavía no usa un modo de suspensión agresivo y la NPU está cargada solo al 10,4 %, así que aún hay margen para reducir el consumo. En calidad, el resultado también resulta serio para hardware de esta clase. El modelo tiene 8,5 millones de parámetros, apenas perdió prec
Dónde gana el microcontrolador?
La fortaleza de este enfoque no es la universalidad a toda costa, sino cubrir el hueco entre el simple keyword spotting y el pesado ASR en la nube. Las interfaces de voz locales habituales esperan una coincidencia exacta del comando, mientras que aquí el dispositivo ya puede interpretar distintas formulaciones de la misma petición. En lugar de una frase fija, el usuario puede decir «sube un poco la temperatura», «súbela cinco grados» o «temperatura arriba», y el sistema entenderá una sola acción. De ahí surgen escenarios bastante prácticos: un hogar inteligente que no envía
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.