Hugging Face publica Ecom-RLVE, un gimnasio para agentes de IA de tiendas online
Hugging Face ha lanzado Ecom-RLVE, un entorno para entrenar agentes de IA que ayudan a comprar productos en tiendas online. Incluye ocho escenarios, desde la búsqueda y el armado del carrito hasta las devoluciones y el seguimiento del pedido, además de recompensas verificables por precisión, eficiencia y ausencia de alucinaciones. Las primeras pruebas indican que este enfoque detecta los fallos reales mejor que los benchmarks de chat habituales.
Procesado por IA desde Hugging Face Blog; editado por Hamidun News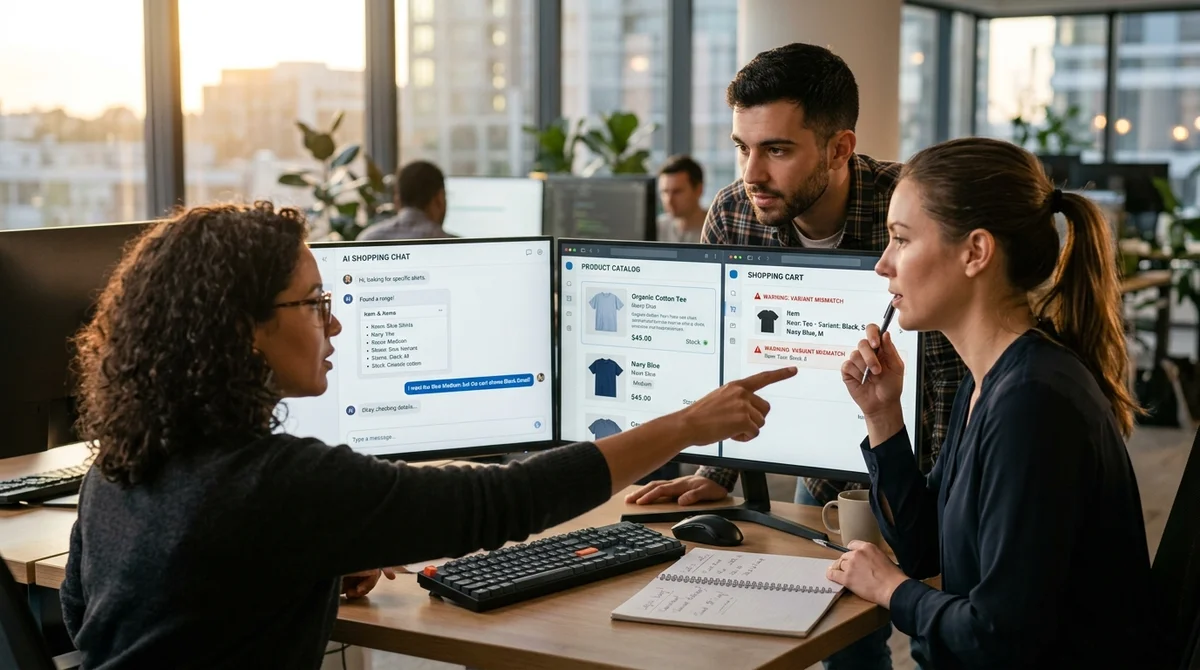
Hugging Face ha publicado Ecom-RLVE, un conjunto de entornos verificables para entrenar agentes conversacionales de IA que ayudan a comprar productos en tiendas online. El proyecto traslada el aprendizaje por refuerzo de las tareas abstractas a escenarios reales de varios pasos: búsqueda de producto, selección de un sustituto, armado del carrito, devoluciones y seguimiento del pedido.
Por qué los benchmarks antiguos se quedan cortos
Los grandes modelos de lenguaje hace tiempo que aprendieron a sonar convincentes, pero en el comercio electrónico eso no basta. Un usuario puede pedir no solo «encontrar un cargador», sino elegir un modelo de hasta 25 dólares, con USB-C, entrega en dos días y compatible con un dispositivo concreto. Para un agente ya no se trata de una respuesta de chat, sino de una cadena de acciones: encontrar la ficha del producto, comprobar las restricciones, elegir la variante correcta, no confundir la cantidad y no inventar lo que no existe en el catálogo.
«Hablar con fluidez no equivale a completar la tarea».
Ecom-RLVE se construye precisamente sobre esa brecha.
Los autores desarrollan la idea de RLVE-Gym, donde los modelos se entrenaban con tareas verificables y una recompensa exacta, y la trasladan al comercio conversacional. En lugar de una evaluación subjetiva por parte de una persona o de un LLM-as-a-judge, el entorno comprueba el resultado con código: si el agente dio con el producto correcto, si eligió bien la talla o la variante, si creó la devolución del artículo adecuado y si respetó el límite de pasos.
Cómo funciona el entorno
Cada episodio de Ecom-RLVE consta de una tarea oculta, un usuario simulado y un conjunto de herramientas con las que trabaja el agente. El agente no se limita a escribir texto: llama a funciones, busca en el catálogo, añade artículos al carrito, hace preguntas aclaratorias y da por terminado el escenario solo cuando el objetivo se ha cumplido de verdad.
El entorno cubre ocho tipos de situaciones, desde product discovery y product substitution hasta bundle planning, policy QA, order tracking y multi-intent journey. La recompensa se compone de varios elementos para que el modelo aprenda no solo a «parecer útil», sino a completar la tarea:
- recompensa por ejecutar correctamente la tarea
- bonificación por menos pasos y menos llamadas a herramientas
- penalización por alucinaciones, por ejemplo SKU o variantes inexistentes
- fallo total ante acciones no válidas o incumplimiento del formato de llamada
La dificultad adaptativa merece mención aparte. En lugar de niveles fijos easy/medium/hard, el entorno introduce un número de dificultad d que controla a la vez 12 ejes: cantidad de restricciones, detalles omitidos, productos parecidos, erratas, falta de stock, cambio de intención durante el diálogo y otras interferencias. Esto permite construir un curriculum learning sin etiquetado manual y evita mantener al modelo demasiado tiempo en tareas que ya se han vuelto triviales.
Dónde falla el modelo
El artículo analiza en detalle el escenario Cart Building, en el que el agente debe armar un carrito con varios productos, con variantes y cantidades exactas. Para evitar que el modelo memorice plantillas, los desarrolladores sintetizan las variantes sobre la marcha: en electrónica puede ser el tipo de conector, en ropa la talla, en artículos de cocina el material o el color. Por ello, el modelo no puede limitarse a «reconocer el producto»; debe vincular de verdad la petición del usuario con la modificación correcta dentro del catálogo.
El equipo entrenó Qwen 3 8B en este entorno con el método DAPO durante 300 pasos en la colección C1, y el propio benchmark prevé los modos C2, C4 y C8 para entrenar con dos, cuatro y ocho entornos. El catálogo se escaló hasta dos millones de productos mediante un índice FAISS y embeddings gte-modernbert-base, y el simulador de usuario se construyó sobre Qwen3.5-9.7B. Según los resultados, el agente logró avanzar de forma estable hacia episodios más difíciles y sus errores se volvieron muy visibles: el modelo puede elegir el producto correcto pero fallar en la variante, olvidar uno de los artículos del pedido o afirmar que la versión necesaria no existe, aunque la había visto varios pasos antes.
Qué significa
Para el mercado de las compras con IA es un cambio importante: ahora se puede competir no por lo fluido que habla un bot, sino por lo fiable que es al completar una tarea de compra. Si estos entornos abiertos se consolidan, el sector tendrá una forma más honesta de entrenar y comparar agentes de comercio electrónico: por la calidad real de sus acciones y no por la impresión que deja la conversación.
- 1 nov 2026Los modelos locales pierden ante Opus y Codex: 0,21 puntos en un MacBook frente a 1,00 de Codex
- 1 nov 2026Pika Labs publica H3 Flex, un modelo de vídeo abierto: 6 pasos en lugar de 50
- 1 nov 2026El tokenizador de BERT en Hugging Face es 50 veces más rápido tras eliminar el trabajo innecesario con ASCII
- 1 nov 2026Illinois reúne 12 151 problemas abiertos y comprueba si la IA puede resolverlos
Preguntas frecuentes sobre la noticia
¿Qué se sabe sobre Por qué los benchmarks antiguos se quedan cortos?
Los grandes modelos de lenguaje hace tiempo que aprendieron a sonar convincentes, pero en el comercio electrónico eso no basta. Un usuario puede pedir no solo «encontrar un cargador», sino elegir un modelo de hasta 25 dólares, con USB-C, entrega en dos días y compatible con un dispositivo concreto. Para un agente ya no se trata de una respuesta de chat, sino de una cadena de acciones: encontrar la ficha del producto, comprobar las restricciones, elegir la variante correcta, no confundir la cantidad y no inventar lo que no existe en el catálogo. «Hablar con fluidez no equiva
Cómo funciona el entorno?
Cada episodio de Ecom-RLVE consta de una tarea oculta, un usuario simulado y un conjunto de herramientas con las que trabaja el agente. El agente no se limita a escribir texto: llama a funciones, busca en el catálogo, añade artículos al carrito, hace preguntas aclaratorias y da por terminado el escenario solo cuando el objetivo se ha cumplido de verdad. El entorno cubre ocho tipos de situaciones, desde product discovery y product substitution hasta bundle planning, policy QA, order tracking y multi-intent journey. La recompensa se compone de varios elementos para que el mod
Dónde falla el modelo?
El artículo analiza en detalle el escenario Cart Building, en el que el agente debe armar un carrito con varios productos, con variantes y cantidades exactas. Para evitar que el modelo memorice plantillas, los desarrolladores sintetizan las variantes sobre la marcha: en electrónica puede ser el tipo de conector, en ropa la talla, en artículos de cocina el material o el color. Por ello, el modelo no puede limitarse a «reconocer el producto»; debe vincular de verdad la petición del usuario con la modificación correcta dentro del catálogo. El equipo entrenó Qwen 3 8B en este e
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.