NVIDIA presenta Nemotron OCR v2: un OCR multilingüe entrenado con 12,2 millones de documentos sintéticos
NVIDIA ha detallado Nemotron OCR v2, un modelo de OCR multilingüe entrenado sobre todo con 12,2 millones de documentos sintéticos. La apuesta no es una arquitectura nueva, sino datos a gran escala: un solo motor lee inglés, ruso, japonés, coreano y chino, y en una A100 procesa hasta 34,7 páginas por segundo. Para el entrenamiento también se añadieron unas 680 mil imágenes reales.
Procesado por IA desde Hugging Face Blog; editado por Hamidun News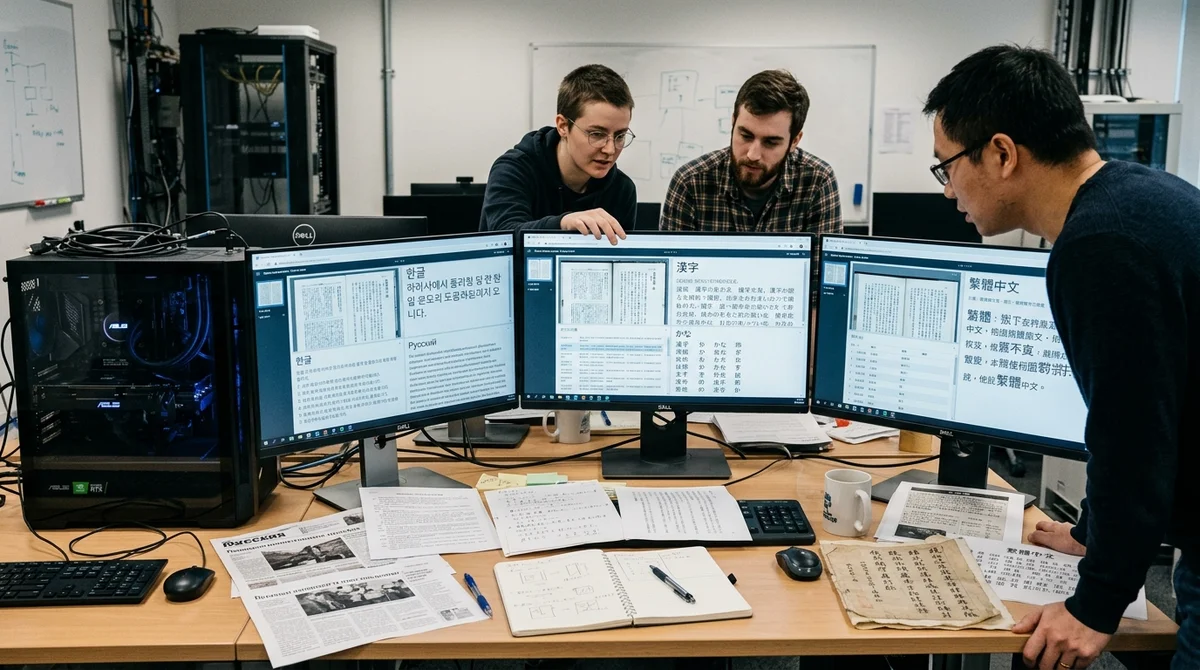
NVIDIA ha mostrado cómo construyó Nemotron OCR v2, un sistema de OCR multilingüe cuyo gran salto no vino de trucos arquitectónicos ingeniosos, sino de datos sintéticos a gran escala. La compañía reunió un conjunto de 12,26 millones de documentos generados artificialmente y entrenó con él un modelo que lee varios idiomas con un solo motor y ofrece hasta 34,7 páginas por segundo en una sola A100.
Foco en los datos
La versión anterior, Nemotron OCR v1, funcionaba con solidez en inglés, pero fallaba en otros idiomas. El benchmark SynthDoG mostró que los valores de Normalized Edit Distance para japonés, coreano, ruso y chino eran demasiado altos: en ocasiones el resultado apenas se parecía al texto original. El equipo incluso amplió el conjunto de caracteres de 855 a 14.244 para cubrir el cirílico y las escrituras CJK, pero la mejora fue pequeña. El modelo podía, formalmente, producir los signos necesarios, pero casi no los veía durante el entrenamiento.
«El cuello de botella eran los datos, no la arquitectura».
Eso fue el punto de inflexión del proyecto. Etiquetar a mano millones de documentos con cuadros a nivel de palabra, línea y párrafo habría costado demasiado, y el scraping de PDF de la web produce una capa de texto ruidosa y muchos errores. Por eso NVIDIA tomó otro camino: generar los documentos mediante programación y conocer de antemano las coordenadas exactas, las transcripciones y el orden de lectura de cada fragmento.
Cómo se construyó el corpus
Para los textos, NVIDIA usó mOSCAR, un gran corpus web multilingüe con 163 subconjuntos de idiomas. Eso permitió partir no de listas de diccionario ni de texto automático, sino de frases más realistas, con una distribución natural de palabras y caracteres.
Como motor de renderizado, la compañía eligió SynthDoG, del proyecto Donut, y lo rehízo en profundidad. El resultado no son solo imágenes de páginas, sino un etiquetado jerárquico completo a nivel de palabra, línea y párrafo, además de un grafo de relaciones que fija el orden de lectura.
Al pipeline se añadieron varios elementos importantes para acercar los datos sintéticos a los documentos reales:
- diseños con varias plantillas: columnas, tablas, texto vertical, índices, diapositivas y páginas al estilo Word
- etiquetado no solo por cuadros, sino por jerarquía de elementos y relaciones entre líneas
- paso al reconocimiento por líneas para japonés, coreano y chino, donde los límites de las palabras suelen ser ambiguos
- un gran conjunto de fuentes abiertas, de 165 a 1.258 por idioma, incluidas las familias Google Fonts y Noto
- aumentos de datos agresivos: sombras, contornos, ruido, desenfoque, distorsiones y cambios de brillo y de fondo
El conjunto final suma 12.258.146 ejemplos en seis categorías de idioma: inglés, japonés, coreano, ruso, chino simplificado y chino tradicional. El modelo multilingüe en sí funciona como una única pila para inglés, ruso, japonés, coreano y chino, sin un paso aparte de detección de idioma. La lógica de ampliación también es sencilla: si para un idioma nuevo hay un corpus de texto y fuentes adecuadas, el pipeline puede escalarse más sin etiquetado manual y sin reescribir la arquitectura.
Velocidad y compromisos
Nemotron OCR v2 se entrenó no solo con datos sintéticos, sino también con unas 680 mil imágenes reales. La arquitectura tiene tres partes: un detector de texto basado en RegNetX-8GF, un reconocedor basado en Transformer y un módulo relacional que entiende qué líneas y bloques están conectados. La idea clave es que un backbone convolucional pesado recorre la página una sola vez y sus características se reutilizan en el resto de componentes. Así, el sistema no gasta cómputo extra en cada etapa del pipeline por separado.
En el benchmark sintético la mejora parece muy fuerte. En ruso, el NED bajó de 0,564 en Nemotron OCR v1 a 0,043 en v2; en japonés, de 0,723 a 0,046; en coreano, de 0,923 a 0,047; en chino simplificado, de 0,784 a 0,035. Según NVIDIA, la versión multilingüe única superó en ese conjunto incluso a las variantes especializadas por idioma de PaddleOCR.
Pero en el OmniDocBench real el panorama es más complejo: Nemotron OCR v2 alcanza 34,7 páginas por segundo frente a 1,2 de PaddleOCR v5, una ventaja de velocidad de más de 28 veces, aunque en precisión queda por detrás de los mejores competidores en algunos subconjuntos. Aquí el producto elige claramente un equilibrio a favor de la velocidad de procesamiento, y no de la máxima calidad a cualquier precio.
Qué significa
Nemotron OCR v2 es una buena señal para el mercado de la IA documental: los datos sintéticos ya no son un efecto de demostración, sino una vía práctica para lanzar rápido modelos de OCR multilingües y escalarlos a nuevas escrituras. Para las empresas supone un camino más barato hacia el reconocimiento de documentos, sobre todo donde importan la velocidad, la versatilidad y el control del etiquetado, y no un récord absoluto en cada benchmark.
- 2 nov 2026El creador de Bun migra 750 mil líneas de Zig a Rust en 11 días con Claude Code
- 2 nov 2026Un periodista de The Verge construye con Claude Code un equivalente del Meta Muse Charm por 50 dólares
- 1 nov 2026Prueba de 16 modelos en 7 buscadores: Exa obtuvo una media de 10,5 puntos de 14; SearXNG, en torno a 3
- 1 nov 2026StreamVibe, el agente de vídeo de Google, supera en un 10,7 % a otros modelos en momento y calidad de respuesta
Preguntas frecuentes sobre la noticia
¿Qué se sabe sobre Foco en los datos?
La versión anterior, Nemotron OCR v1, funcionaba con solidez en inglés, pero fallaba en otros idiomas. El benchmark SynthDoG mostró que los valores de Normalized Edit Distance para japonés, coreano, ruso y chino eran demasiado altos: en ocasiones el resultado apenas se parecía al texto original. El equipo incluso amplió el conjunto de caracteres de 855 a 14.244 para cubrir el cirílico y las escrituras CJK, pero la mejora fue pequeña. El modelo podía, formalmente, producir los signos necesarios, pero casi no los veía durante el entrenamiento. «El cuello de botella eran los d
Cómo se construyó el corpus?
Para los textos, NVIDIA usó mOSCAR, un gran corpus web multilingüe con 163 subconjuntos de idiomas. Eso permitió partir no de listas de diccionario ni de texto automático, sino de frases más realistas, con una distribución natural de palabras y caracteres. Como motor de renderizado, la compañía eligió SynthDoG, del proyecto Donut, y lo rehízo en profundidad. El resultado no son solo imágenes de páginas, sino un etiquetado jerárquico completo a nivel de palabra, línea y párrafo, además de un grafo de relaciones que fija el orden de lectura. Al pipeline se añadieron varios el
¿Qué se sabe sobre Velocidad y compromisos?
Nemotron OCR v2 se entrenó no solo con datos sintéticos, sino también con unas 680 mil imágenes reales. La arquitectura tiene tres partes: un detector de texto basado en RegNetX-8GF, un reconocedor basado en Transformer y un módulo relacional que entiende qué líneas y bloques están conectados. La idea clave es que un backbone convolucional pesado recorre la página una sola vez y sus características se reutilizan en el resto de componentes. Así, el sistema no gasta cómputo extra en cada etapa del pipeline por separado. En el benchmark sintético la mejora parece muy fuerte. E
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.