NeuralSet y deep learning: decodificar rasgos del lenguaje a partir de señales MEG del cerebro
Un análisis de NeuralSet detalla un pipeline de extremo a extremo que convierte señales MEG en predicciones de rasgos del lenguaje. En el ejemplo, el modelo estima la longitud de una palabra a partir de la respuesta cerebral, desde la carga y limpieza de los datos hasta el entrenamiento de una red de deep learning en la práctica. No es un producto de consumo llamativo, sino un tutorial práctico para neuroingenieros, laboratorios de investigación y equipos que construyen sistemas de neuroAI con biosignales reales.
Procesado por IA desde MarkTechPost; editado por Hamidun News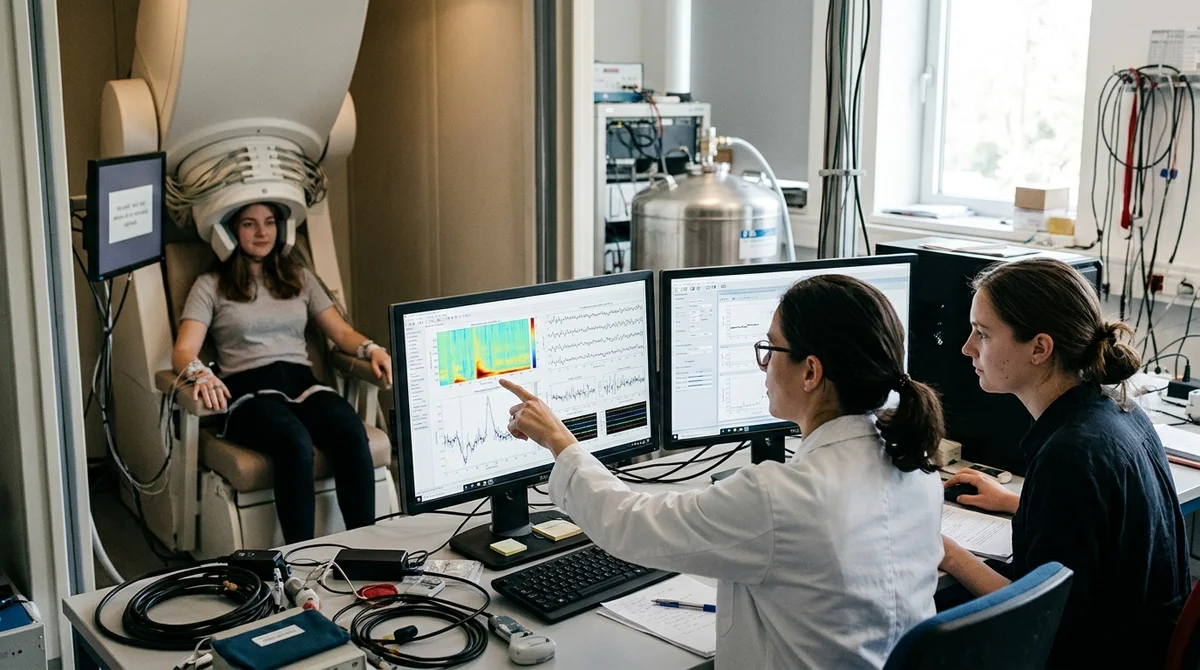
Un nuevo análisis técnico presenta un pipeline de neuroAI que extrae rasgos del lenguaje directamente de señales MEG. Como demostración, un sistema basado en NeuralSet y deep learning intenta predecir la longitud de una palabra a partir de la respuesta del cerebro a un estímulo lingüístico.
Cómo funciona el pipeline
Lo interesante del material es que no muestra un fragmento aislado de investigación, sino una cadena de ingeniería casi completa, desde la preparación del entorno hasta el entrenamiento del modelo con señales neuronales. En el centro está la MEG, un método que registra los campos magnéticos generados por la actividad de las neuronas. Después, los datos siguen la ruta habitual en neuroAI: carga, limpieza, sincronización con los estímulos, creación de ejemplos de entrenamiento y entrada a una red que debe asociar patrones de actividad cerebral con una propiedad lingüística concreta.
La tarea objetivo es bastante sencilla, pero reveladora: el sistema estima la longitud de la palabra que percibió una persona basándose únicamente en la respuesta cerebral. Es una salvedad importante. No se trata de «leer la mente» libremente, sino de predecir un rasgo estrictamente definido en un experimento controlado.
Este formato resulta útil para desarrolladores e investigadores: permite comprobar si un enfoque de extremo a extremo logra extraer significado de biosignales en bruto o apenas procesadas, sin dividir el proceso en decenas de pasos manuales.
Por qué importa la MEG
Para las tareas de lenguaje, la MEG resulta especialmente adecuada por su alta precisión temporal. Mientras que la fMRI muestra bien dónde se produce la actividad, la MEG sirve mejor para responder cuándo exactamente reacciona el cerebro a una palabra, un sonido o un rasgo concreto del estímulo. En tareas relacionadas con la longitud de las palabras, el orden de los caracteres o el procesamiento semántico temprano, esta dinámica de milisegundos suele importar más que un mapa espacial grueso. Por eso el interés por estos pipelines crece no solo entre neurocientíficos, sino también entre equipos que trabajan en la intersección de la IA y las interfaces cerebro-computadora.
También es relevante que el análisis use NeuralSet como base para organizar los datos y el modelo. En la práctica, esto es más útil que una descripción árida de una arquitectura sobre el papel: el lector ve cómo construir un proceso reproducible, no solo la idea final. En estos temas, la reproducibilidad suele ser lo que frena el avance. Incluso un buen modelo aporta poco si el equipo no puede montar rápido el entorno, llevar los registros MEG a un formato único y repetir el experimento con su propia muestra sin armar a mano cada paso.
Qué incluye la implementación
Según la descripción, el tutorial cubre los pasos clave necesarios para un primer prototipo funcional. No es una revisión abstracta sobre «redes neuronales para el cerebro», sino una implementación en código que muestra cómo los datos neuronales se convierten en una tarea supervisada. Para los ingenieros, el valor está justo en ese pragmatismo: se puede tomar la base, cambiar el rasgo objetivo, conectar otro conjunto de datos y comprobar rápidamente si el mismo enfoque funciona en un planteamiento nuevo.
- configuración del entorno de Python y las dependencias del pipeline de neuroAI
- carga de datos MEG y preprocesamiento básico de las señales
- vinculación de las respuestas cerebrales con los estímulos lingüísticos
- entrenamiento de un modelo de deep learning para predecir la longitud de la palabra
- evaluación de los resultados y comprobación de cuánta información lingüística útil aporta la señal
Este formato es especialmente útil ahora que el mercado de herramientas de IA se aleja rápidamente de los modelos puramente textuales hacia interfaces multimodales y de biosignales. Aunque la tarea de la longitud de palabra parezca limitada, responde a una pregunta más general: ¿se pueden extraer de forma estable rasgos estructurados de una señal cerebral compleja sin una pesada ingeniería manual? Si la respuesta es positiva, aunque sea en parte, el mismo enfoque puede ampliarse a la fonética, la categoría de la palabra, las clases semánticas y otros niveles del análisis lingüístico.
Qué significa
El valor práctico de esta publicación no está en promesas grandilocuentes, sino en que reduce la barrera de entrada a la neuroAI. Cuando los desarrolladores disponen de código reproducible para trabajar con MEG y rasgos del lenguaje, el campo avanza más rápido de las diapositivas de investigación a sistemas verificables. Para la industria, aún no es un producto terminado, pero ya es una ruta clara hacia futuras interfaces cerebro-computadora y nuevas herramientas para estudiar el habla.
Preguntas frecuentes sobre la noticia
Cómo funciona el pipeline?
Lo interesante del material es que no muestra un fragmento aislado de investigación, sino una cadena de ingeniería casi completa, desde la preparación del entorno hasta el entrenamiento del modelo con señales neuronales. En el centro está la MEG, un método que registra los campos magnéticos generados por la actividad de las neuronas. Después, los datos siguen la ruta habitual en neuroAI: carga, limpieza, sincronización con los estímulos, creación de ejemplos de entrenamiento y entrada a una red que debe asociar patrones de actividad cerebral con una propiedad lingüística co
¿Qué se sabe sobre Por qué importa la MEG?
Para las tareas de lenguaje, la MEG resulta especialmente adecuada por su alta precisión temporal. Mientras que la fMRI muestra bien dónde se produce la actividad, la MEG sirve mejor para responder cuándo exactamente reacciona el cerebro a una palabra, un sonido o un rasgo concreto del estímulo. En tareas relacionadas con la longitud de las palabras, el orden de los caracteres o el procesamiento semántico temprano, esta dinámica de milisegundos suele importar más que un mapa espacial grueso. Por eso el interés por estos pipelines crece no solo entre neurocientíficos, sino t
¿Qué se sabe sobre Qué incluye la implementación?
Según la descripción, el tutorial cubre los pasos clave necesarios para un primer prototipo funcional. No es una revisión abstracta sobre «redes neuronales para el cerebro», sino una implementación en código que muestra cómo los datos neuronales se convierten en una tarea supervisada. Para los ingenieros, el valor está justo en ese pragmatismo: se puede tomar la base, cambiar el rasgo objetivo, conectar otro conjunto de datos y comprobar rápidamente si el mismo enfoque funciona en un planteamiento nuevo. configuración del entorno de Python y las dependencias del pipeline de
Build & Ship Production AI Agents Without Boilerplate Code
Start your free 72-hour trial at Hamidun Academy (academy.hamidun.com) — interactive lessons on Claude Code & Cursor, live Tech Radar, and production agent templates.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.