Las startups de IA pasan en 2026 del prompt único a los pipelines multiagente
Un buen prompt y una interfaz atractiva ya no bastan para sostener un producto de IA completo. En 2026, las startups que necesitan resultados estables para el usuario y el negocio pasan a pipelines multiagente: un agente reúne datos, otro genera, un tercero verifica y un orquestador lo integra todo en el resultado final. Esta arquitectura es la que empieza a separar una demo de un servicio que funciona de verdad.
Procesado por IA desde Habr AI; editado por Hamidun News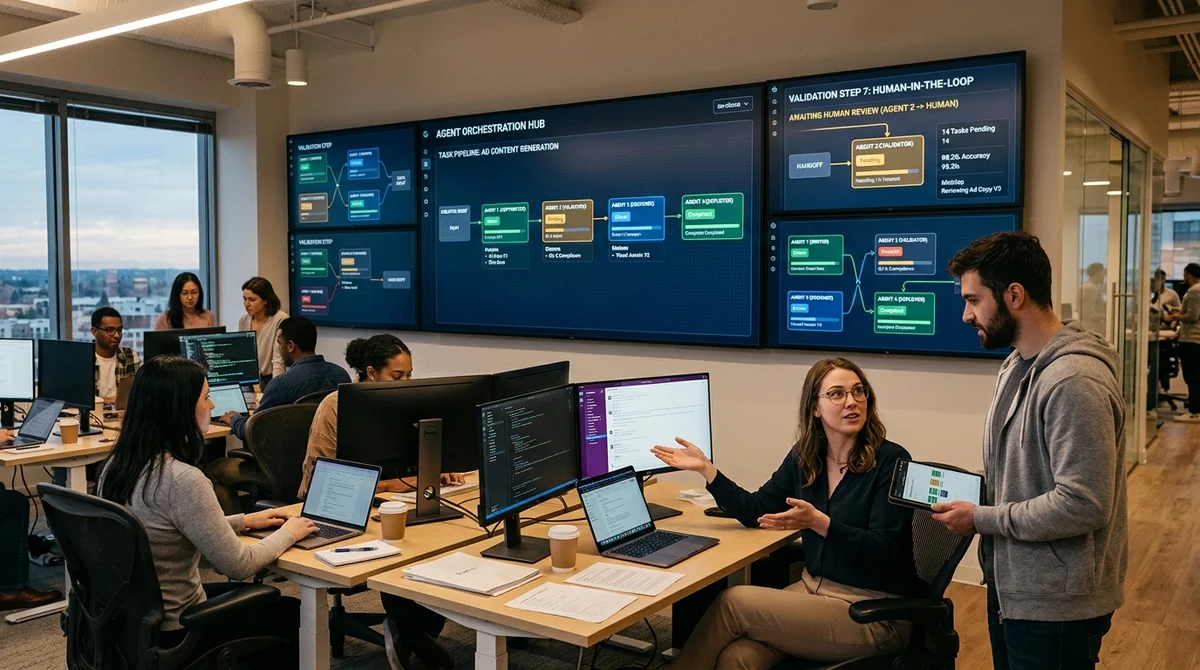
El mercado de servicios de IA se topa en 2026 cada vez más con una verdad incómoda: una interfaz bonita alrededor de un prompt afortunado casi nunca crea un producto sólido. Los equipos que quieren llevar la IA a un resultado operativo abandonan la "consulta mágica" y montan pipelines multiagente, en los que distintos modelos y verificaciones se encargan de etapas separadas de la tarea.
Por qué un solo prompt no basta
La lógica de "tomemos un modelo potente, escribamos un buen prompt de sistema y lo envolvamos en una suscripción" funcionó en el mercado incipiente, pero pronto tocó techo. Una sola consulta puede redactar un texto, proponer una idea o armar un borrador, pero maneja mal el contexto largo, no sabe comprobarse a sí misma de forma estable y se rompe con facilidad cuando la entrada del usuario es algo más compleja de lo previsto. El resultado: el producto luce bien en la demo, pero se desmorona en escenarios reales que exigen memoria, enrutamiento de tareas y control de calidad.
El problema se nota sobre todo cuando se promete automatizar un proceso de negocio y en la práctica se entrega un chat con un botón. Mientras el usuario hace una pregunta típica, todo resulta convincente. Pero en cuanto hay que combinar varias fuentes, mantener un formato, verificar cifras y devolver una respuesta predecible, el sistema empieza a dar resultados distintos con la misma entrada. Para B2B y el trabajo en equipo, esto es casi una sentencia: una herramienta así es difícil de integrar en el circuito operativo.
Cómo es un pipeline
El nuevo enfoque no se construye en torno a un modelo, sino a una cadena de roles. Un agente recibe la tarea y precisa los datos de entrada, un segundo busca hechos o documentos, un tercero escribe el borrador, un cuarto comprueba la lógica, el formato y las restricciones, y el orquestador reúne el resultado y decide si hay que enviar la tarea a otra ronda. Una cadena así es bastante más compleja de montar, pero se parece más a cómo trabajan los equipos sólidos: no un ejecutor universal, sino varias especializaciones con áreas de responsabilidad claras.
Un pipeline multiagente no se necesita por una palabra de moda, sino por controlabilidad. Cuando cada paso está aislado, el equipo puede mejorar el punto débil con precisión: cambiar el modelo solo en la investigación, añadir reglas de verificación solo en la revisión final, guardar memoria solo donde de verdad ayuda. Esto reduce el coste de los errores y hace el desarrollo del producto más ingenieril y menos intuitivo. El equipo ve exactamente dónde falla la salida y puede arreglar ese tramo sin reescribir todo el sistema.
«Un prompt no es un producto».
Qué cambia para las startups
El esquema multiagente cuesta más de desarrollar, pero aporta lo que le falta a la mayoría de los wrappers de IA: repetibilidad del resultado. En lugar de confiar en una generación afortunada, el equipo empieza a diseñar un proceso: dónde validar los datos, cómo detectar alucinaciones, cómo reutilizar el contexto, cuándo pedir confirmación a una persona. Ahí aparece un valor de producto que es difícil copiar en una tarde. Esto convierte la IA de generador de respuestas en un servicio gestionado con SLA claros.
- Descomposición de la tarea en etapas en lugar de una sola consulta
- Agentes distintos para búsqueda, generación y verificación
- Reglas de escalado si el modelo no está seguro de su respuesta
- Almacenamiento del contexto intermedio y del historial de decisiones
- Métricas de calidad para cada paso, no solo para la respuesta final
Este enfoque cambia también la economía del producto. Sí, un pipeline puede costar más en tokens e infraestructura, pero reduce el precio del error: menos repeticiones manuales, menos devoluciones, menos desconfianza del cliente. Si el servicio promete un resultado y no solo "ayuda con la generación", la estabilidad empieza a compensar los gastos adicionales ya en una fase temprana de crecimiento.
Para el mercado, es un cambio importante. Ganarán no quienes primero conectaron un LLM a un formulario, sino quienes construyeron una arquitectura fiable alrededor del modelo. En 2026, la ventaja competitiva no es el acceso a la API en sí, sino saber organizar agentes, herramientas y datos en un único flujo de trabajo sin magia innecesaria.
Qué significa
El periodo en que un producto de IA podía venderse como "un prompt potente más una interfaz bonita" está terminando. Si un equipo quiere vender no una demo sino un servicio estable, tendrá que pensar como un sistema de ingeniería: dividir la tarea, verificar los pasos y construir la orquestación entre agentes.
Preguntas frecuentes sobre la noticia
¿Qué se sabe sobre Por qué un solo prompt no basta?
La lógica de "tomemos un modelo potente, escribamos un buen prompt de sistema y lo envolvamos en una suscripción" funcionó en el mercado incipiente, pero pronto tocó techo. Una sola consulta puede redactar un texto, proponer una idea o armar un borrador, pero maneja mal el contexto largo, no sabe comprobarse a sí misma de forma estable y se rompe con facilidad cuando la entrada del usuario es algo más compleja de lo previsto. El resultado: el producto luce bien en la demo, pero se desmorona en escenarios reales que exigen memoria, enrutamiento de tareas y control de calidad
Cómo es un pipeline?
El nuevo enfoque no se construye en torno a un modelo, sino a una cadena de roles. Un agente recibe la tarea y precisa los datos de entrada, un segundo busca hechos o documentos, un tercero escribe el borrador, un cuarto comprueba la lógica, el formato y las restricciones, y el orquestador reúne el resultado y decide si hay que enviar la tarea a otra ronda. Una cadena así es bastante más compleja de montar, pero se parece más a cómo trabajan los equipos sólidos: no un ejecutor universal, sino varias especializaciones con áreas de responsabilidad claras. Un pipeline multiage
¿Qué se sabe sobre Qué cambia para las startups?
El esquema multiagente cuesta más de desarrollar, pero aporta lo que le falta a la mayoría de los wrappers de IA: repetibilidad del resultado. En lugar de confiar en una generación afortunada, el equipo empieza a diseñar un proceso: dónde validar los datos, cómo detectar alucinaciones, cómo reutilizar el contexto, cuándo pedir confirmación a una persona. Ahí aparece un valor de producto que es difícil copiar en una tarde. Esto convierte la IA de generador de respuestas en un servicio gestionado con SLA claros. Descomposición de la tarea en etapas en lugar de una sola consul
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.