Google lanza Gemini Embedding 2 para RAG multimodal con vídeo, audio y PDF
Google ha actualizado su línea de embeddings con Gemini Embedding 2, un modelo que no solo trabaja con texto, sino también con imágenes, vídeo, audio y PDF. Para el RAG es un cambio importante: ahora se puede buscar en distintos formatos dentro de un único espacio vectorial. Sin embargo, para que el LLM dé una respuesta útil sigue haciendo falta una arquitectura adecuada, con descripciones de texto independientes de los archivos encontrados.
Procesado por IA desde Habr AI; editado por Hamidun News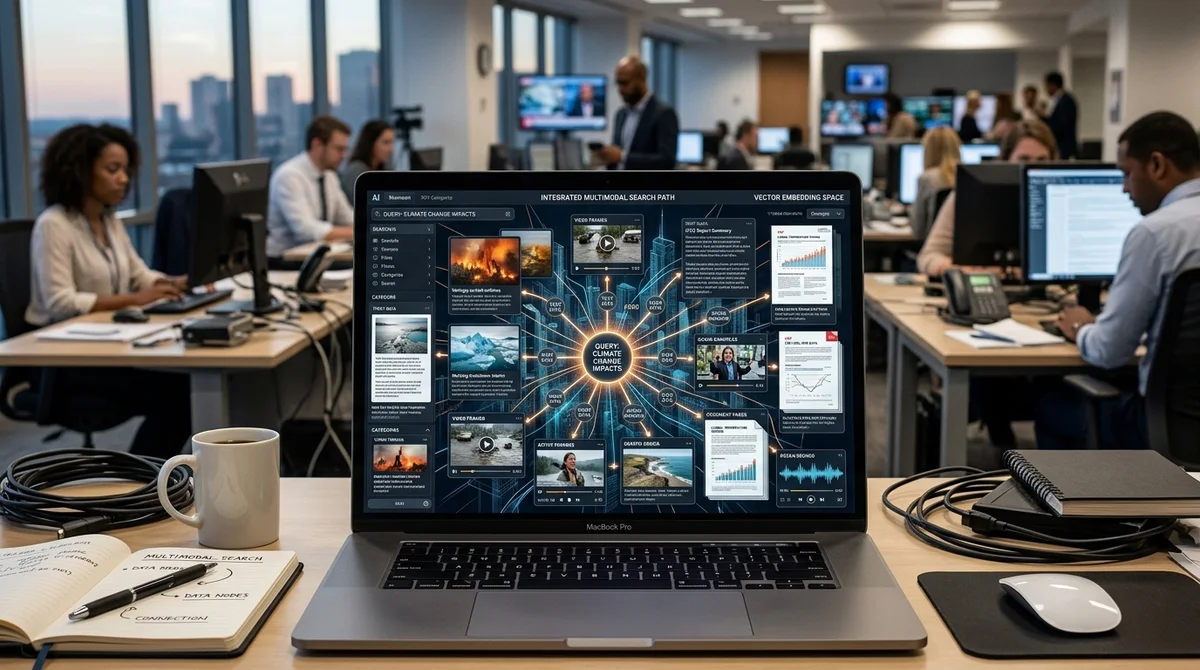
Google ha lanzado Gemini Embedding 2, un modelo de embeddings que lleva a un mismo espacio vectorial no solo texto, sino también imágenes, audio, vídeo y PDF. Para el RAG multimodal es un paso importante: una sola consulta puede encontrar tanto un artículo de la base de conocimiento como el fragmento exacto de un vídeo de formación.
Qué ha cambiado
Hasta ahora, la búsqueda en contenidos de tipos mixtos exigía una larga cadena de transformaciones. Había que dividir el vídeo en fotogramas, transcribir el audio, describir las imágenes con un modelo de visión, volver a reunirlo todo en texto y solo entonces enviarlo a un modelo de embeddings. El esquema funcionaba, pero perdía detalles en cada etapa. Si el reconocimiento de voz fallaba o la descripción de un fotograma era demasiado genérica, la calidad de la búsqueda caía de inmediato, y el desarrollador tenía que mantener un pipeline engorroso de varios servicios.
Con Gemini Embedding 2 desaparece parte de esa complejidad. El modelo acepta los archivos originales directamente y construye representaciones de distintos formatos en un espacio unificado. Esto significa que una consulta de texto como «cómo configurar la autorización» puede coincidir no solo con la documentación, sino también con un fragmento de vídeo relevante, una captura de la interfaz o una guía en PDF. Para los equipos que guardan su conocimiento en formatos dispersos, elimina una de las principales limitaciones del RAG clásico.
Cómo montar el sistema
Pero el modelo de embeddings por sí solo no hace útil el RAG multimodal de forma automática. Un modelo de lenguaje grande no puede simplemente «leer» un MP4 o una imagen como lee un contexto de texto. Por eso, una arquitectura que funcione se construye en dos canales: uno se encarga de la búsqueda con embeddings nativos y el otro prepara una descripción de texto del objeto encontrado, que después sí puede pasarse al LLM para generar la respuesta. Es la combinación de ambos canales la que convierte una demo vistosa en un producto funcional.
- Indexar los archivos originales de forma nativa, sin transformaciones innecesarias
- Guardar junto a ellos descripciones de texto, transcripciones y metadatos
- Buscar en un único espacio vectorial para todos los tipos de contenido
- Pasar al LLM no el archivo, sino su representación de texto y su contexto
En la práctica, encaja bien con el stack habitual de RAG: Python para el pipeline, la API de Gemini para los embeddings y la generación de descripciones, y Supabase u otra base de datos vectorial para almacenar los índices. Este enfoque permite buscar a la vez en la base de conocimiento, capturas de pantalla, presentaciones y vídeos internos, sin obligar al usuario a pensar en qué formato está la respuesta. A nivel de producto, ya no es solo una búsqueda en documentos, sino un punto de acceso único al conocimiento de la empresa.
Dónde están los cuellos de botella
La principal limitación no ha desaparecido: el objeto multimedia encontrado todavía hay que explicárselo al modelo y a la persona. Si el sistema devuelve un vídeo pero no sabe en qué fragmento concreto está la respuesta, el usuario seguirá recibiendo un resultado pobre. Por eso, la calidad del RAG multimodal depende ahora no solo de los embeddings, sino también de lo cuidadosamente que se construyan la segmentación, la anotación y el vínculo de la capa de texto con el archivo original.
La consulta «cómo configurar la autorización» puede devolver tanto un
artículo como el fragmento de vídeo adecuado.
De ahí se derivan requisitos de ingeniería: hay que planificar el chunking de vídeo y audio, la actualización de las descripciones cuando se reemplazan archivos, el almacenamiento de marcas de tiempo y el control de costes. La búsqueda multimodal nativa reduce la pérdida de información, pero no elimina la necesidad de buenos datos. Si las descripciones son débiles, el LLM no podrá armar una respuesta con seguridad ni siquiera cuando la búsqueda acierta. Por eso, el principal valor de Gemini Embedding 2 aparece donde el equipo está dispuesto a construir un índice completo, en lugar de subir archivos y esperar magia.
Qué significa
Para las bases de conocimiento corporativas, el soporte, el onboarding y las plataformas de formación, es un cambio notable. Google acerca el RAG a un escenario en el que texto, imágenes y vídeo son fuentes de respuesta en pie de igualdad. No ganarán quienes tengan más archivos, sino quienes sepan conectar bien la búsqueda multimodal con una capa de texto clara para el LLM.
- 1 nov 2026Prueba de 16 modelos en 7 buscadores: Exa obtuvo una media de 10,5 puntos de 14; SearXNG, en torno a 3
- 1 nov 2026StreamVibe, el agente de vídeo de Google, supera en un 10,7 % a otros modelos en momento y calidad de respuesta
- 1 nov 2026OpenAI reescribe las reglas de comportamiento de GPT: cinco valores y una cadena de prioridades
- 1 nov 2026Los bots de voz con LLM recurren al clasificador rápido Jev: decisiones en 200–500 ms
Preguntas frecuentes sobre la noticia
¿Qué se sabe sobre Qué ha cambiado?
Hasta ahora, la búsqueda en contenidos de tipos mixtos exigía una larga cadena de transformaciones. Había que dividir el vídeo en fotogramas, transcribir el audio, describir las imágenes con un modelo de visión, volver a reunirlo todo en texto y solo entonces enviarlo a un modelo de embeddings. El esquema funcionaba, pero perdía detalles en cada etapa. Si el reconocimiento de voz fallaba o la descripción de un fotograma era demasiado genérica, la calidad de la búsqueda caía de inmediato, y el desarrollador tenía que mantener un pipeline engorroso de varios servicios. Con Ge
Cómo montar el sistema?
Pero el modelo de embeddings por sí solo no hace útil el RAG multimodal de forma automática. Un modelo de lenguaje grande no puede simplemente «leer» un MP4 o una imagen como lee un contexto de texto. Por eso, una arquitectura que funcione se construye en dos canales: uno se encarga de la búsqueda con embeddings nativos y el otro prepara una descripción de texto del objeto encontrado, que después sí puede pasarse al LLM para generar la respuesta. Es la combinación de ambos canales la que convierte una demo vistosa en un producto funcional. Indexar los archivos originales de
Dónde están los cuellos de botella?
La principal limitación no ha desaparecido: el objeto multimedia encontrado todavía hay que explicárselo al modelo y a la persona. Si el sistema devuelve un vídeo pero no sabe en qué fragmento concreto está la respuesta, el usuario seguirá recibiendo un resultado pobre. Por eso, la calidad del RAG multimodal depende ahora no solo de los embeddings, sino también de lo cuidadosamente que se construyan la segmentación, la anotación y el vínculo de la capa de texto con el archivo original. La consulta «cómo configurar la autorización» puede devolver tanto un artículo como el fr
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.