Nvidia presenta el primer conjunto de datos abierto y modelos de IA base para robots médicos
Nvidia y sus socios han publicado Open-H-Embodiment, el primer gran conjunto de datos abierto para robótica médica. Reúne 778 horas de datos de cirugía, ecografía y colonoscopia. Junto a él llegan por primera vez dos modelos: GR00T-H, para controlar robots, y Cosmos-H-Surgical-Simulator, para simular operaciones con rapidez. Es un intento de montar una pila base de Physical AI para la medicina.
Procesado por IA desde Hugging Face Blog; editado por Hamidun News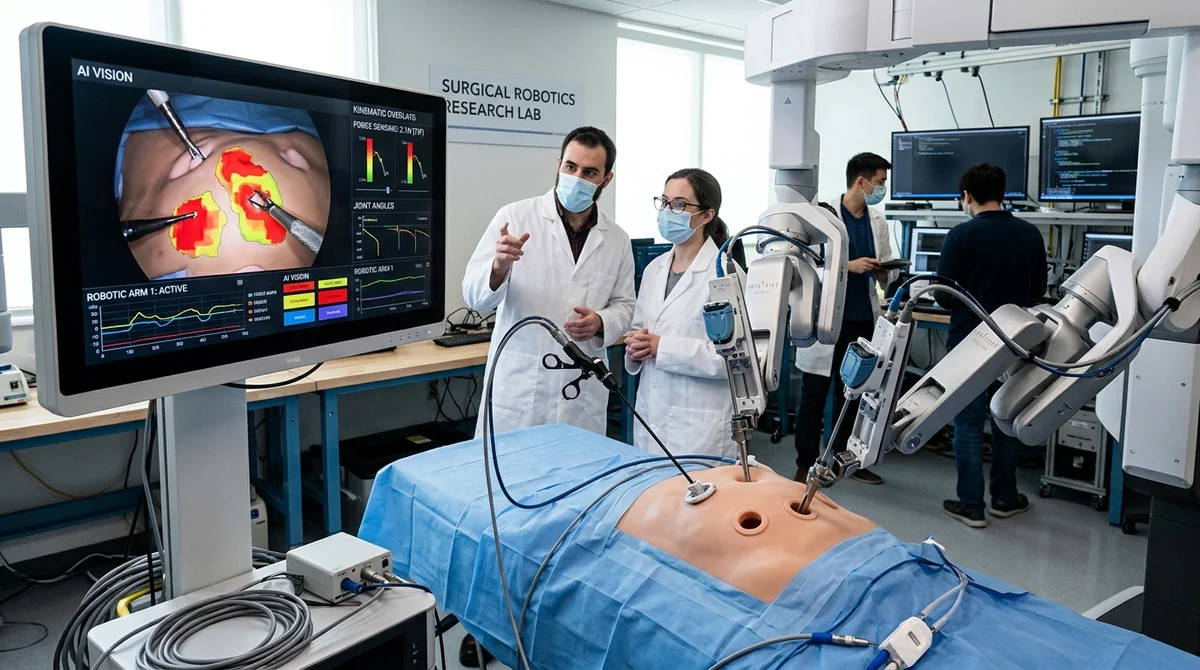
Nvidia, junto con la comunidad investigadora, ha presentado Open-H-Embodiment, el primer gran conjunto de datos abierto para robótica médica, además de dos modelos base para escenarios quirúrgicos. El paquete está publicado en Hugging Face y busca desplazar la IA médica del análisis de imágenes hacia sistemas capaces de actuar en el mundo físico.
Qué se ha abierto
La idea del lanzamiento es sencilla: en medicina ya sobran modelos que solo reconocen imágenes, segmentan tejidos o clasifican patologías. En el quirófano, en una ecografía o en una colonoscopia, la máquina debe manejar un instrumento, entender el contacto con los tejidos, tener en cuenta la cinemática del robot y cerrar el bucle de control mediante retroalimentación. Open-H-Embodiment se ha creado precisamente para eso: una base común para entrenar y evaluar Physical AI en robótica médica.
- 778 horas de datos de entrenamiento con licencia CC-BY-4.0
- 35 organizaciones participantes de universidades, clínicas e industria
- escenarios de cirugía, ecografía y colonoscopia autónoma
- datos de simulación, ejercicios en simuladores y procedimientos reales
- compatibilidad con plataformas robóticas comerciales y de investigación
Para el mercado importa tanto el formato como el volumen. El conjunto de datos reúne visión, fuerza, cinemática y distintos tipos de cuerpos robóticos en una colección abierta, de modo que los equipos puedan comparar enfoques sobre una base común y no sobre colecciones locales cerradas. Participan Nvidia, Johns Hopkins, Technical University of Munich, Stanford y decenas de equipos más, así que no se trata de una publicación puntual, sino de un intento de fijar un estándar sectorial.
Cómo funcionan los modelos
Junto con el conjunto de datos, Nvidia ha publicado GR00T-H, un modelo Vision-Language-Action para robótica quirúrgica, entrenado con unas 600 horas de datos de Open-H-Embodiment. En esencia es un modelo de políticas: recibe contexto visual y textual y lo traduce en acciones del robot. Los autores subrayan que han introducido un espacio de acciones normalizado común para distintos robots, proyecciones específicas para cada cinemática y entrenamiento sobre movimientos relativos del instrumento. El prototipo ya ha completado una sutura entera en el benchmark SutureBot, es decir, no un gesto corto, sino una larga secuencia de acciones precisas.
La segunda pieza de la pila es Cosmos-H-Surgical-Simulator, un world foundation model para simulación quirúrgica condicionada por acciones. Se ajustó con Open-H-Embodiment para generar vídeo verosímil de la operación directamente a partir de las acciones cinemáticas del robot, incluidos efectos complejos como la deformación de tejidos blandos, los reflejos, la sangre y el humo. La ventaja práctica es notable: 600 ejecuciones en este simulador tardan unos 40 minutos, frente a unos dos días en pruebas reales de banco. Para el ajuste se usaron 64 GPU A100 y unas 10.000 horas de GPU, así que es una base de infraestructura seria, no una demo de laboratorio.
Qué viene después
Lo más interesante es el intento de llevar la robótica médica del modo «el modelo ve» al modo «el modelo actúa y generaliza». Un conjunto de datos abierto y dos modelos fundacionales dan a los investigadores una pila común para experimentos sim-to-real, generación de datos sintéticos y transferencia de habilidades entre robots distintos. Esto es especialmente relevante en cirugía, donde reunir grandes conjuntos de datos de calidad es caro y un error de control cuesta mucho más que en la visión por computador convencional.
«La robótica quirúrgica necesita su propio momento ChatGPT».
Así describen los autores el objetivo de la segunda versión de Open-H-Embodiment. La siguiente etapa no es solo un mejor control del instrumento, sino autonomía con elementos de razonamiento: los sistemas deberían poder explicar los pasos, planificar procedimientos largos, adaptarse a los fallos y aprender de trayectorias anotadas con intenciones, resultados y tipos de error. Si la comunidad logra reunir datos preparados para el razonamiento, la medicina podría obtener no un algoritmo estrecho más, sino una plataforma para asistentes robóticos más universales.
Qué significa
Para el mercado de la IA es un cambio importante: en medicina se empieza a construir abiertamente no solo modelos de reconocimiento, sino una capa base para Physical AI, donde datos, modelos de políticas y simuladores se publican en paquete. Si el enfoque despega, startups, laboratorios y fabricantes de robots tendrán un kit inicial común para acelerar la investigación, reducir el coste de las pruebas y pasar más rápido de los prototipos a sistemas clínicamente útiles.
- 2 nov 2026TensorFold 1.2.0 aumenta un 44,2% el rendimiento de Qwen3.8-27B en el M3 Ultra con 16 flujos
- 1 nov 2026Los modelos locales pierden ante Opus y Codex: 0,21 puntos en un MacBook frente a 1,00 de Codex
- 1 nov 2026Un autor de Habr ajusta YOLOv8l con radiografías dentales y lleva el mAP50 a 0,642
- 1 nov 2026Los bots de voz con LLM recurren al clasificador rápido Jev: decisiones en 200–500 ms
Preguntas frecuentes sobre la noticia
¿Qué se sabe sobre Qué se ha abierto?
La idea del lanzamiento es sencilla: en medicina ya sobran modelos que solo reconocen imágenes, segmentan tejidos o clasifican patologías. En el quirófano, en una ecografía o en una colonoscopia, la máquina debe manejar un instrumento, entender el contacto con los tejidos, tener en cuenta la cinemática del robot y cerrar el bucle de control mediante retroalimentación. Open-H-Embodiment se ha creado precisamente para eso: una base común para entrenar y evaluar Physical AI en robótica médica. 778 horas de datos de entrenamiento con licencia CC-BY-4.0 35 organizaciones partici
Cómo funcionan los modelos?
Junto con el conjunto de datos, Nvidia ha publicado GR00T-H, un modelo Vision-Language-Action para robótica quirúrgica, entrenado con unas 600 horas de datos de Open-H-Embodiment. En esencia es un modelo de políticas: recibe contexto visual y textual y lo traduce en acciones del robot. Los autores subrayan que han introducido un espacio de acciones normalizado común para distintos robots, proyecciones específicas para cada cinemática y entrenamiento sobre movimientos relativos del instrumento. El prototipo ya ha completado una sutura entera en el benchmark SutureBot, es dec
¿Qué se sabe sobre Qué viene después?
Lo más interesante es el intento de llevar la robótica médica del modo «el modelo ve» al modo «el modelo actúa y generaliza». Un conjunto de datos abierto y dos modelos fundacionales dan a los investigadores una pila común para experimentos sim-to-real, generación de datos sintéticos y transferencia de habilidades entre robots distintos. Esto es especialmente relevante en cirugía, donde reunir grandes conjuntos de datos de calidad es caro y un error de control cuesta mucho más que en la visión por computador convencional. «La robótica quirúrgica necesita su propio momento C
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.