Google lanza WAXAL, un conjunto de datos de voz abierto para lenguas africanas
Google ha abierto WAXAL, un conjunto de datos de voz para lenguas africanas que busca acelerar el reconocimiento y la síntesis del habla en lenguas de pocos recursos. Para el reconocimiento se recogió habla natural mediante descripciones de imágenes; para la síntesis, grabaciones más limpias a partir de textos equilibrados. Google también muestra que el proyecto ya se amplía, abarca decenas de lenguas y seguirá creciendo.
Procesado por IA desde MarkTechPost; editado por Hamidun News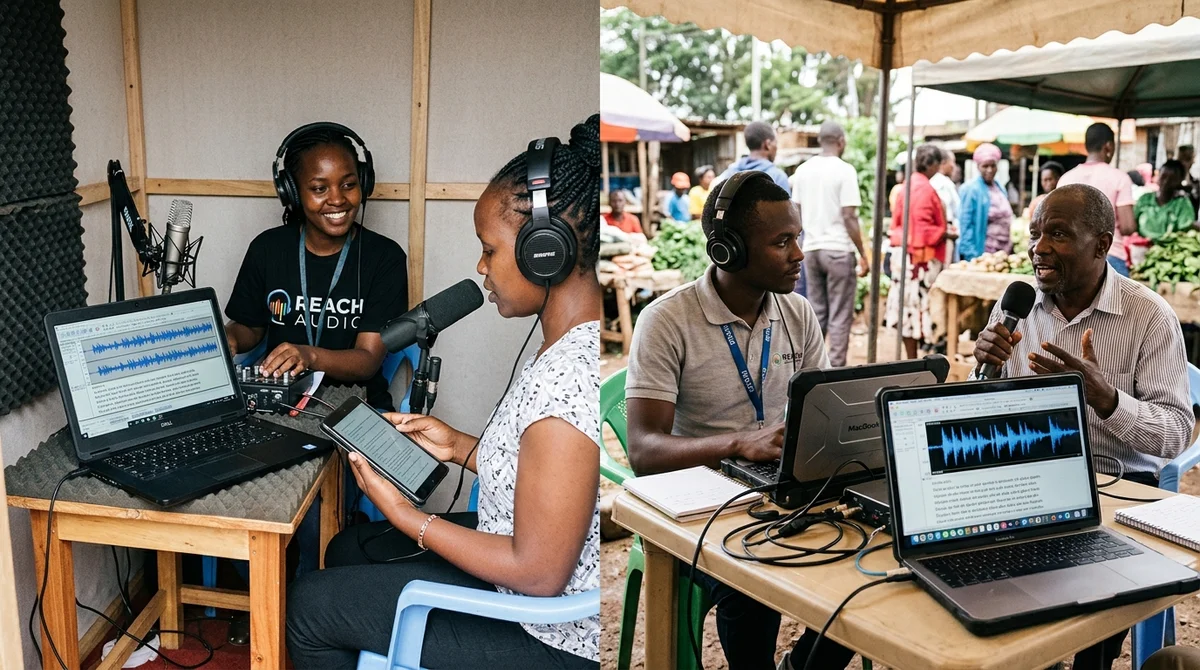
Google ha abierto WAXAL, un gran corpus de voz para lenguas africanas, creado como base para sistemas de reconocimiento y síntesis del habla. El proyecto se dirige a un mercado donde las tecnologías de voz avanzan bastante más despacio por la falta crónica de datos abiertos de calidad.
Por qué importa
El principal problema de la IA de voz desde hace tiempo no son los modelos, sino la distribución de los datos. Para el inglés, el español o el chino existen enormes corpus abiertos y comerciales, por lo que el reconocimiento de voz y la síntesis progresan rápido. Para muchas lenguas africanas ocurre lo contrario: hay poca voz etiquetada, pocas grabaciones de calidad y pocas licencias abiertas. Por eso, hablantes de lenguas con millones de personas siguen recibiendo peor calidad en dictado, subtítulos automáticos, asistentes de voz y locución de interfaces.
WAXAL intenta cerrar precisamente esa brecha de infraestructura.
Es significativo que el proyecto ya parezca vivo y no un archivo estático. En la descripción técnica, el equipo habla de 24 lenguas y de un conjunto inicial para tareas de reconocimiento y síntesis del habla. En el blog de lanzamiento de Google del 6 de marzo de 2026 aparece ya una entrega inicial ampliada: 27 lenguas, más de 1 846 horas de datos para reconocimiento de voz y más de 565 horas para síntesis. Es decir, Google no se ha limitado a publicar un conjunto de datos; parece estar construyendo una base abierta a largo plazo para lenguas que suelen quedar fuera de las grandes plataformas de IA.
Cómo está construido WAXAL
WAXAL se dividió en dos partes independientes, porque el reconocimiento de voz y la síntesis tienen requisitos de datos distintos. El primero necesita hablantes diversos, entornos naturales y habla espontánea para que el modelo funcione mejor en condiciones reales. La segunda exige audio más limpio, textos fonéticamente equilibrados y grabación controlada; de lo contrario, es difícil obtener una voz natural y estable. En ese sentido, WAXAL no parece una "carpeta de audios" genérica, sino un conjunto diseñado para dos tipos de tareas.
- En la parte de reconocimiento, se pidió a los participantes que describieran imágenes en su lengua materna en lugar de leer guiones preparados.
- Google afirma que esos estímulos cubrían más de 50 temas y sacaban mejor el habla espontánea, incluidos matices tonales y cambios entre lenguas.
- En la parte de síntesis se usaron textos fonéticamente equilibrados y condiciones de grabación más controladas.
- El conjunto se publica bajo la licencia abierta CC-BY-4.0, de modo que puede usarse en investigación y en productos aplicados.
Quién recopiló los datos
La clave del proyecto no es solo el volumen, sino cómo se recogieron los datos. Google no trabajó sola, sino con universidades y organizaciones locales africanas, entre ellas Makerere University, University of Ghana, Digital Umuganda, African Institute for Mathematical Sciences Senegal, Media Trust y Loud and Clear Communications. Este formato importa porque los equipos locales entienden mejor los hábitos de habla, la mezcla de lenguas, las variantes regionales de pronunciación y los contextos en los que la gente realmente habla, en lugar de leer un texto en el silencio de un laboratorio.
«El corpus fue creado por la comunidad y para la comunidad que lo necesita».
También son interesantes los detalles de producción. Para la parte de TTS, los participantes prepararon textos de entre 10 000 y 20 000 palabras y trabajaron en parejas: uno leía y el otro grababa y comprobaba la calidad. Para lograr un sonido más limpio, algunos equipos incluso construyeron sus propias cabinas de estudio.
Google subraya aparte que WAXAL debe ayudar no solo a los benchmarks académicos, sino a escenarios reales: interfaces de voz locales, dictado automático, transcripción automática, locución de servicios y sistemas conversacionales que deben entender el habla viva y no solo un texto leído a la perfección.
Alrededor del corpus ya empieza a crecer un ecosistema aplicado y de investigación. Google menciona trabajos de recopilación de datos para personas con trastornos del habla, un gran corpus aparte para cinco lenguas de Ghana y benchmarks para modelos como Whisper, XLS-R, MMS y W2v-BERT en lenguas africanas. Es una buena señal: WAXAL sirve no solo como archivo, sino como punto de referencia común para comparar modelos, encontrar puntos débiles y llevar más rápido los productos de voz a una calidad útil.
Qué significa
WAXAL reduce la barrera de entrada para startups, investigadores y equipos locales que quieren desarrollar IA de voz no solo para lenguas globales. Si estos corpus abiertos crecen y se actualizan con regularidad, las lenguas africanas tendrán la oportunidad de acercarse antes al resto del mercado en calidad de reconocimiento, síntesis y accesibilidad de los servicios digitales.
- 1 nov 2026Prueba de 16 modelos en 7 buscadores: Exa obtuvo una media de 10,5 puntos de 14; SearXNG, en torno a 3
- 1 nov 2026StreamVibe, el agente de vídeo de Google, supera en un 10,7 % a otros modelos en momento y calidad de respuesta
- 1 nov 2026OpenAI reescribe las reglas de comportamiento de GPT: cinco valores y una cadena de prioridades
- 1 nov 2026Los bots de voz con LLM recurren al clasificador rápido Jev: decisiones en 200–500 ms
Preguntas frecuentes sobre la noticia
¿Qué se sabe sobre Por qué importa?
El principal problema de la IA de voz desde hace tiempo no son los modelos, sino la distribución de los datos. Para el inglés, el español o el chino existen enormes corpus abiertos y comerciales, por lo que el reconocimiento de voz y la síntesis progresan rápido. Para muchas lenguas africanas ocurre lo contrario: hay poca voz etiquetada, pocas grabaciones de calidad y pocas licencias abiertas. Por eso, hablantes de lenguas con millones de personas siguen recibiendo peor calidad en dictado, subtítulos automáticos, asistentes de voz y locución de interfaces. WAXAL intenta cer
Cómo está construido WAXAL?
WAXAL se dividió en dos partes independientes, porque el reconocimiento de voz y la síntesis tienen requisitos de datos distintos. El primero necesita hablantes diversos, entornos naturales y habla espontánea para que el modelo funcione mejor en condiciones reales. La segunda exige audio más limpio, textos fonéticamente equilibrados y grabación controlada; de lo contrario, es difícil obtener una voz natural y estable. En ese sentido, WAXAL no parece una "carpeta de audios" genérica, sino un conjunto diseñado para dos tipos de tareas. En la parte de reconocimiento, se pidió
¿Qué se sabe sobre Quién recopiló los datos?
La clave del proyecto no es solo el volumen, sino cómo se recogieron los datos. Google no trabajó sola, sino con universidades y organizaciones locales africanas, entre ellas Makerere University, University of Ghana, Digital Umuganda, African Institute for Mathematical Sciences Senegal, Media Trust y Loud and Clear Communications. Este formato importa porque los equipos locales entienden mejor los hábitos de habla, la mezcla de lenguas, las variantes regionales de pronunciación y los contextos en los que la gente realmente habla, en lugar de leer un texto en el silencio de
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.