Baidu lanza Qianfan-OCR, un modelo de 4B para reconocer y entender documentos
Baidu ha presentado Qianfan-OCR, un modelo de 4B que reúne OCR, análisis de maquetación y comprensión de documentos en una sola arquitectura. En lugar de un pipeline de varios pasos, el sistema convierte la imagen directamente en Markdown y admite tareas mediante prompts, como la extracción de tablas, las respuestas a preguntas sobre el documento y la automatización de procesos internos. Es otro paso hacia servicios de IA documental inteligentes para empresas.
Procesado por IA desde MarkTechPost; editado por Hamidun News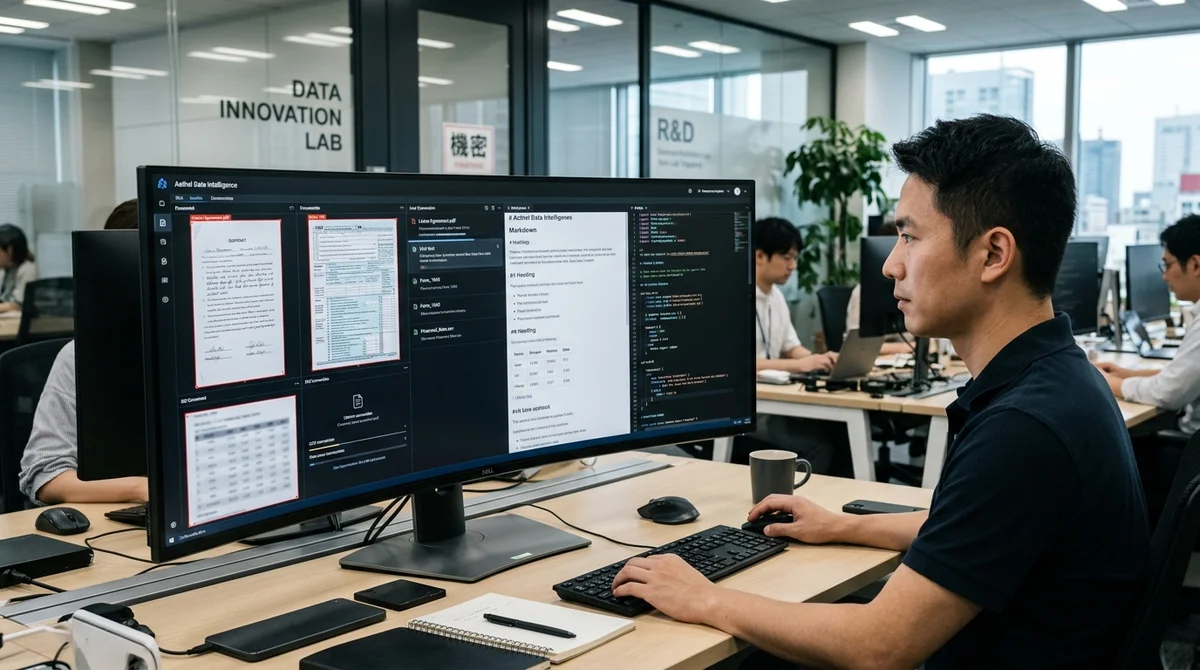
Baidu ha presentado Qianfan-OCR, un modelo unificado de 4B para trabajar con documentos que combina reconocimiento de texto, análisis de estructura y comprensión del contenido. En lugar del clásico pipeline de OCR con varias etapas, el sistema convierte directamente la imagen del documento en Markdown estructurado y puede ejecutar tareas según lo que pida el usuario.
Por qué el mercado se aleja de los pipelines de OCR
Los sistemas OCR clásicos suelen montarse con varios bloques independientes: uno localiza las áreas de la página, otro reconoce el texto y un tercero intenta interpretar tablas, títulos y orden de lectura. Este enfoque funciona mientras el documento es sencillo, pero empieza a fallar con maquetaciones complejas, escaneos, formularios, contenido mixto, diseños no estándar y archivos de varias páginas. Cuantos más pasos tiene la cadena, mayor es el riesgo de que un error temprano estropee todo el resultado.
En este contexto, Baidu Qianfan apuesta por un enfoque único de visión y lenguaje. Qianfan-OCR no pretende solo leer caracteres, sino percibir el documento como un objeto completo: con bloques, estructura, lógica y significado. Para las empresas es un cambio importante, porque el negocio no suele necesitar el texto en sí, sino datos listos para usar en búsqueda, analítica, automatización y escenarios internos de IA, incluidos los procesos en producción.
Qué sabe hacer Qianfan-OCR
Según la descripción del equipo, es un modelo de extremo a extremo con 4000 millones de parámetros que reúne el análisis de documentos, el layout analysis y el document understanding en una sola arquitectura. La principal diferencia con el OCR habitual es que el modelo no depende de un largo conjunto de módulos conectados en secuencia. En su lugar, recibe una imagen y devuelve de inmediato un resultado estructurado, incluida la conversión de imagen a Markdown. Esto reduce de forma considerable el número de transformaciones intermedias.
Destaca por separado la lógica guiada por prompts. El modelo puede usarse no solo para el reconocimiento básico, sino también para tareas aplicadas en las que el usuario formula qué quiere extraer del documento. El artículo menciona expresamente escenarios como la extracción de tablas y las respuestas a preguntas sobre el documento. Así, el OCR deja de ser una herramienta de archivo para escaneos y se acerca a una interfaz para trabajar con archivos corporativos en los flujos de trabajo de las empresas.
El formato Markdown también importa. Para los equipos que construyen bases de conocimiento, búsqueda con IA o pipelines para LLM, no basta con obtener texto sin estructura. Hacen falta títulos, listas, tablas y un orden lógico de los bloques. Si el modelo entrega el documento de inmediato en una forma cómoda para el procesamiento automático, se reduce el posprocesamiento y el resultado resulta más adecuado para la indexación automática, el resumen y una capa posterior de preguntas y respuestas. Para la integración, es una ventaja notable.
- Conversión directa de la imagen del documento a Markdown
- Análisis de la estructura de la página sin un pipeline aparte de varios módulos
- Extracción de tablas a petición del usuario
- Respuestas a preguntas sobre el contenido del documento
- Un único modelo en lugar de un conjunto de componentes dispersos
Dónde puede resultar útil
El sentido práctico de estos modelos es que reducen el número de operaciones intermedias entre el documento y la acción útil. Si el sistema entiende de forma realmente estable la maquetación, el texto y el significado en una sola pasada, se simplifica el procesamiento de contratos, instrucciones, informes, formularios, presentaciones y bases de conocimiento internas. Es especialmente relevante para los equipos que quieren convertir automáticamente PDF y escaneos a un formato apto para RAG, búsqueda de conocimiento o análisis posterior con LLM.
Para desarrolladores y equipos de producto hay otro punto importante: la unificación reduce la complejidad de ingeniería. En lugar de mantener varios servicios de OCR y posprocesamiento, se puede construir un stack más corto. Esto no garantiza una calidad perfecta en cada tipo de documento, pero la dirección está clara: el mercado pasa de un conjunto de detectores especializados a grandes modelos que tratan el documento como un objeto multimodal, lo preparan de inmediato para tareas downstream y lanzan nuevos escenarios con más rapidez.
Qué significa
Qianfan-OCR muestra que el OCR está pasando rápidamente de ser una tecnología acotada de reconocimiento de caracteres a convertirse en una capa de inteligencia documental. Si estos modelos confirman su calidad en escenarios reales, a las empresas les resultará más fácil automatizar el trabajo con documentos sin pipelines complejos de varias etapas ni montaje manual de componentes sueltos. Saldrán ganando sobre todo los equipos que necesitan pasar rápido de PDF y escaneos a datos listos para búsqueda, analítica y asistentes de IA.
Preguntas frecuentes sobre la noticia
¿Qué se sabe sobre Por qué el mercado se aleja de los pipelines de OCR?
Los sistemas OCR clásicos suelen montarse con varios bloques independientes: uno localiza las áreas de la página, otro reconoce el texto y un tercero intenta interpretar tablas, títulos y orden de lectura. Este enfoque funciona mientras el documento es sencillo, pero empieza a fallar con maquetaciones complejas, escaneos, formularios, contenido mixto, diseños no estándar y archivos de varias páginas. Cuantos más pasos tiene la cadena, mayor es el riesgo de que un error temprano estropee todo el resultado. En este contexto, Baidu Qianfan apuesta por un enfoque único de visió
¿Qué se sabe sobre Qué sabe hacer Qianfan-OCR?
Según la descripción del equipo, es un modelo de extremo a extremo con 4000 millones de parámetros que reúne el análisis de documentos, el layout analysis y el document understanding en una sola arquitectura. La principal diferencia con el OCR habitual es que el modelo no depende de un largo conjunto de módulos conectados en secuencia. En su lugar, recibe una imagen y devuelve de inmediato un resultado estructurado, incluida la conversión de imagen a Markdown. Esto reduce de forma considerable el número de transformaciones intermedias. Destaca por separado la lógica guiada
Dónde puede resultar útil?
El sentido práctico de estos modelos es que reducen el número de operaciones intermedias entre el documento y la acción útil. Si el sistema entiende de forma realmente estable la maquetación, el texto y el significado en una sola pasada, se simplifica el procesamiento de contratos, instrucciones, informes, formularios, presentaciones y bases de conocimiento internas. Es especialmente relevante para los equipos que quieren convertir automáticamente PDF y escaneos a un formato apto para RAG, búsqueda de conocimiento o análisis posterior con LLM. Para desarrolladores y equipos
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.