El algoritmo TurboQuant de Google hunde las acciones de los fabricantes de memoria tras publicarse la investigación
Google presentó TurboQuant, un método de compresión del KV cache para LLM que reduce el consumo de memoria al menos seis veces y, según la compañía, no empeora la calidad. El mercado reaccionó en horas: las acciones de Micron, Western Digital y SanDisk cayeron porque los inversores recalcularon al instante la demanda futura de memoria para IA. Si el enfoque se consolida, la inferencia podría abaratarse de forma notable. El método comprime el KV cache a 3 bits por valor en lugar de los 16 estándar y no requiere reentrenamiento ni fine-tuning.
Procesado por IA desde TNW; editado por Hamidun News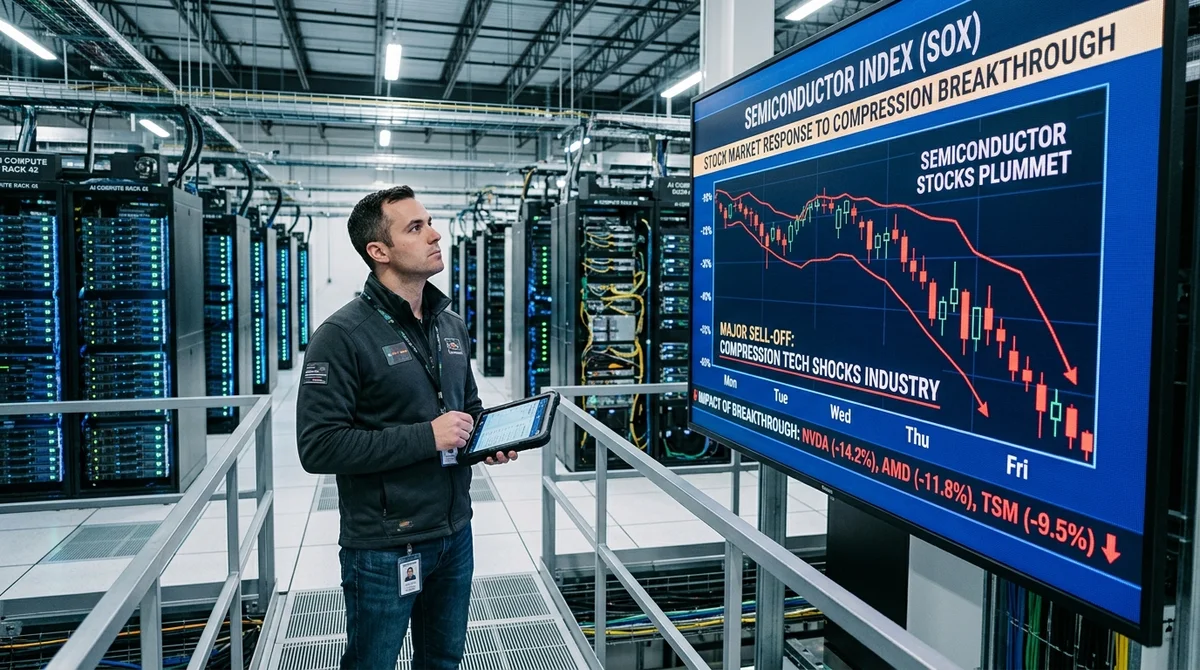
Google Research ha presentado TurboQuant, un algoritmo de compresión para modelos de IA que reduce al menos seis veces el volumen de la memoria de trabajo clave sin una pérdida de calidad apreciable. El mercado reaccionó al instante: tras la publicación del 24 de marzo de 2026, los inversores empezaron a revisar cuánta memoria necesitará realmente la industria de la IA generativa.
Qué mostró Google
TurboQuant ataca un punto estrecho pero costoso de la inferencia de los grandes modelos de lenguaje: la key-value cache, o KV cache. Es el almacén de contexto que permite al modelo no recalcular los tokens ya procesados. Cuanto más largo es el prompt, el documento o la conversación, más rápido crece esta caché y más memoria de la GPU ocupa.
Según Google, el nuevo método comprime el KV cache a 3 bits por valor en lugar de los 16 bits estándar y reduce el consumo de memoria como mínimo seis veces.
En la práctica esto importa tanto como en la ciencia. La memoria liberada permite atender más solicitudes simultáneas con el mismo hardware, usar ventanas de contexto más largas o emplear modelos más grandes sin ampliar la flota de aceleradores. Los autores señalan que TurboQuant no requiere reentrenamiento ni fine-tuning y se presentará en ICLR 2026. Las pruebas utilizaron modelos de las familias Gemma, Mistral y Llama, además de benchmarks estándar de contexto largo.
Cómo funciona el algoritmo
TurboQuant se basa en un esquema de dos etapas. Primero, el método PolarQuant convierte los vectores a una representación polar para eliminar los datos auxiliares superfluos que suelen consumir parte de la ganancia de la cuantización tradicional. Después entra QJL, una técnica que codifica el error residual con un solo bit adicional por dimensión y reduce las distorsiones en la atención (attention). Así, la mayor parte del presupuesto de bits se dedica a conservar el significado de los datos originales y no a la sobrecarga técnica.
Google llama al KV cache una «chuleta digital de alta velocidad» para el modelo.
- compresión del KV cache de 16 a 3 bits
- reducción de memoria de al menos 6 veces
- hasta 8 veces más rapidez en el cálculo de attention en Nvidia H100 en modo de 4 bits
- funciona sin entrenamiento ni fine-tuning
- aplicable no solo a LLM, sino también a la búsqueda vectorial
Google afirma que en las tareas Needle in a Haystack TurboQuant mantuvo un resultado perfecto incluso con la caché comprimida seis veces. En LongBench y ZeroSCROLLS, el método también igualó o superó a KIVI, uno de los enfoques de referencia conocidos para la cuantización del KV cache. Por separado, la compañía probó TurboQuant en búsqueda vectorial y obtuvo un recall más alto sin grandes codebooks ni ajustes a un dataset concreto. Es una zona de interés directo para buscadores, sistemas de recomendación y publicidad.
Por qué reaccionó el mercado
La bolsa no leyó esta publicación como un avance académico, sino como una señal de posible caída de la demanda de memoria para infraestructura de IA. En pocas horas tras la publicación, las acciones de Micron bajaron un 3 %, las de Western Digital un 4,7 % y las de SanDisk un 5,7 %.
La lógica es simple: si un componente clave de la inferencia necesita de repente varias veces menos memoria, las compras futuras de HBM, DRAM y almacenamiento pueden parecer menos lineales de lo que habían previsto los inversores.
Pero eso no significa que la industria vaya a necesitar de golpe seis veces menos hardware. La memoria es solo una partida de los gastos de los centros de datos, y el apetito de los modelos por cómputo crece más rápido que cualquier optimización local. Incluso los analistas advierten contra conclusiones demasiado directas: los algoritmos de compresión ya existían, pero no hundieron la demanda de infraestructura en su conjunto. La historia de la computación muestra más a menudo el efecto contrario: cuando los recursos se abaratan, las empresas construyen sistemas más pesados y masivos con el mismo presupuesto.
Qué significa
TurboQuant no es motivo para dar por perdidos a los fabricantes de memoria, sino un indicador temprano de una nueva etapa en la carrera por la eficiencia. Ganarán no solo quienes compren más GPU, sino también quienes sepan comprimir más la inferencia sin perder calidad. Para los productos de IA es una oportunidad de reducir el coste por solicitud, y para el mercado, un recordatorio de que el software ya influye en la capitalización del hardware.
- 1 nov 2026Prueba de 16 modelos en 7 buscadores: Exa obtuvo una media de 10,5 puntos de 14; SearXNG, en torno a 3
- 1 nov 2026StreamVibe, el agente de vídeo de Google, supera en un 10,7 % a otros modelos en momento y calidad de respuesta
- 1 nov 2026OpenAI reescribe las reglas de comportamiento de GPT: cinco valores y una cadena de prioridades
- 1 nov 2026Los bots de voz con LLM recurren al clasificador rápido Jev: decisiones en 200–500 ms
Preguntas frecuentes sobre la noticia
¿Qué se sabe sobre Qué mostró Google?
TurboQuant ataca un punto estrecho pero costoso de la inferencia de los grandes modelos de lenguaje: la key-value cache, o KV cache. Es el almacén de contexto que permite al modelo no recalcular los tokens ya procesados. Cuanto más largo es el prompt, el documento o la conversación, más rápido crece esta caché y más memoria de la GPU ocupa. Según Google, el nuevo método comprime el KV cache a 3 bits por valor en lugar de los 16 bits estándar y reduce el consumo de memoria como mínimo seis veces. En la práctica esto importa tanto como en la ciencia. La memoria liberada permi
Cómo funciona el algoritmo?
TurboQuant se basa en un esquema de dos etapas. Primero, el método PolarQuant convierte los vectores a una representación polar para eliminar los datos auxiliares superfluos que suelen consumir parte de la ganancia de la cuantización tradicional. Después entra QJL, una técnica que codifica el error residual con un solo bit adicional por dimensión y reduce las distorsiones en la atención (attention). Así, la mayor parte del presupuesto de bits se dedica a conservar el significado de los datos originales y no a la sobrecarga técnica. Google llama al KV cache una «chuleta digi
¿Qué se sabe sobre Por qué reaccionó el mercado?
La bolsa no leyó esta publicación como un avance académico, sino como una señal de posible caída de la demanda de memoria para infraestructura de IA. En pocas horas tras la publicación, las acciones de Micron bajaron un 3 %, las de Western Digital un 4,7 % y las de SanDisk un 5,7 %. La lógica es simple: si un componente clave de la inferencia necesita de repente varias veces menos memoria, las compras futuras de HBM, DRAM y almacenamiento pueden parecer menos lineales de lo que habían previsto los inversores. Pero eso no significa que la industria vaya a necesitar de golpe
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.