AWS explica cómo acelerar el fine-tuning de Llama 3.2 Vision con datos de S3
AWS no ha presentado un modelo nuevo, sino una forma práctica de afinar más rápido LLM multimodales con datos de S3. En el ejemplo, el equipo conecta SageMaker Unified Studio, Catalog y S3, y luego usa ese circuito para hacer fine-tuning de Llama 3.2 11B Vision Instruct en visual question answering. Para las empresas es una señal importante: los archivos no estructurados pueden conectarse a un pipeline de ML sin un montaje manual adicional.
Procesado por IA desde AWS Machine Learning Blog; editado por Hamidun News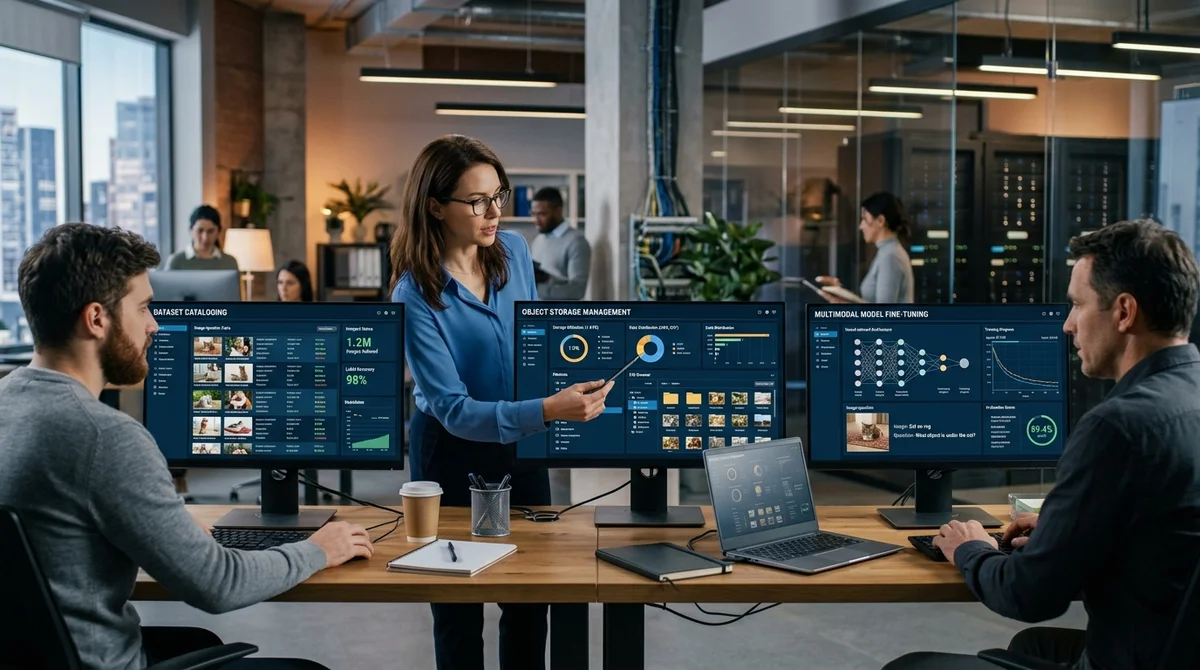
AWS ha mostrado un escenario práctico para trabajar con datos no estructurados en el ecosistema de SageMaker. La compañía describió cómo conectar Amazon S3 con SageMaker Catalog y Unified Studio, y después usar ese circuito para hacer fine-tuning del modelo Llama 3.2 11B Vision Instruct en tareas de visual question answering.
Cómo funciona la combinación
El caso se apoya en una integración que AWS anunció el año pasado: Amazon SageMaker Unified Studio puede trabajar con buckets de S3 corrientes, y no solo con conjuntos de datos preparados por separado dentro del entorno de ML. Para los equipos es un cambio importante, porque la mayor parte del material útil está en el almacenamiento de objetos: imágenes, PDF, escaneos, presentaciones, documentos internos, exportaciones y otros archivos no estructurados.
Antes, entre el almacenamiento y el entrenamiento del modelo solía aparecer una capa manual añadida: traslado, duplicación, etiquetado y catalogación aparte. Ahora AWS muestra un esquema más directo. S3 actúa como almacenamiento base, SageMaker Catalog ayuda a describir y organizar los datos, y Unified Studio se convierte en un entorno de trabajo común para analistas e ingenieros de ML. Con este enfoque, los datos no simplemente «están en un bucket», sino que pasan a ser un activo accesible y gestionado dentro del pipeline. Esto reduce la fricción entre equipos y permite pasar antes de los archivos en bruto al experimento con el modelo, sin montar una infraestructura aparte para cada proyecto.
Qué muestra el ejemplo
Para la demostración, AWS eligió Llama 3.2 11B Vision Instruct y la tarea de visual question answering, o VQA. En este escenario el modelo debe mirar una imagen y responder preguntas sobre su contenido. Tareas así aparecen en el procesamiento de documentos, el comercio electrónico, el soporte, las inspecciones y las bases de conocimiento internas, donde importa no solo guardar la imagen, sino extraer de ella una respuesta en texto comprensible. Para este tipo de fine-tuning es especialmente crítico que los datos visuales y las anotaciones asociadas estén reunidos en un circuito claro.
El valor práctico de la publicación está en que AWS pone el énfasis no en los benchmarks del modelo, sino en la velocidad para montar el flujo de trabajo. Para muchas empresas el cuello de botella no es elegir la LLM, sino el camino que va de «tenemos un archivo de ficheros» a «hemos lanzado el reentrenamiento para una tarea de negocio concreta». La integración de S3 con Catalog y Unified Studio acorta justo ese camino. En lugar de pasos manuales dispersos, el equipo obtiene un proceso más conectado, más fácil de repetir, documentar y escalar a otros conjuntos de datos.
- Se pueden usar buckets de S3 existentes sin migrarlos a un almacenamiento nuevo
- El equipo dispone de un espacio único para trabajar con datos, analítica y experimentos de ML
- Es más fácil convertir archivos no estructurados en conjuntos de datos reutilizables
- Los modelos multimodales pueden adaptarse a casos de uso aplicados como VQA
- Disminuye el volumen de operaciones manuales entre el almacenamiento de datos y el inicio del fine-tuning
Eso sí, AWS no promete que el fine-tuning se haya vuelto una tarea «de un clic». La calidad del resultado sigue dependiendo del etiquetado, la limpieza de los datos, el planteamiento de la pregunta y lo bien elegido que esté el conjunto base de ejemplos. Pero la parte de infraestructura se simplifica: el almacenamiento de objetos deja de ser un archivo pasivo y se convierte en una fuente de trabajo para ML y analítica. Para empresas con grandes volúmenes de imágenes y documentos, esto puede reducir de forma notable el tiempo hasta el primer prototipo útil.
Qué significa
AWS empuja al mercado de las conversaciones abstractas sobre las capacidades de los modelos hacia el montaje práctico de un pipeline de datos a modelo. La conclusión para las empresas es sencilla: la ventaja la crea cada vez más no solo elegir una LLM potente, sino la rapidez con que el equipo sabe conectar sus datos no estructurados, describirlos y convertirlos en un circuito gestionado para un fine-tuning repetible. Cuantas menos uniones manuales haya entre almacenamiento, catálogo y entrenamiento, antes aparecen modelos aplicados a procesos concretos.
- 19 nov 2026SageMaker ya envía las solicitudes LLM al GPU con la caché lista: el primer token llega un 97% más rápido
- 19 nov 2026Los modelos de IA incluyeron una escuela en la lista de objetivos militares en el 70% de las pruebas de Vals AI
- 19 nov 2026Q.ANT y AMD ejecutan un LLM de 1 mil millones de parámetros con un chip óptico en lugar de la atención
- 19 nov 2026La palabra «videojuego» elevó la disposición de GPT-6 Astra a elegir objetivos del 6% al 92%
Preguntas frecuentes sobre la noticia
Cómo funciona la combinación?
El caso se apoya en una integración que AWS anunció el año pasado: Amazon SageMaker Unified Studio puede trabajar con buckets de S3 corrientes, y no solo con conjuntos de datos preparados por separado dentro del entorno de ML. Para los equipos es un cambio importante, porque la mayor parte del material útil está en el almacenamiento de objetos: imágenes, PDF, escaneos, presentaciones, documentos internos, exportaciones y otros archivos no estructurados.
¿Qué se sabe sobre Qué muestra el ejemplo?
Para la demostración, AWS eligió Llama 3.2 11B Vision Instruct y la tarea de visual question answering, o VQA. En este escenario el modelo debe mirar una imagen y responder preguntas sobre su contenido. Tareas así aparecen en el procesamiento de documentos, el comercio electrónico, el soporte, las inspecciones y las bases de conocimiento internas, donde importa no solo guardar la imagen, sino extraer de ella una respuesta en texto comprensible.
¿Qué se sabe sobre Qué significa?
AWS empuja al mercado de las conversaciones abstractas sobre las capacidades de los modelos hacia el montaje práctico de un pipeline de datos a modelo. La conclusión para las empresas es sencilla: la ventaja la crea cada vez más no solo elegir una LLM potente, sino la rapidez con que el equipo sabe conectar sus datos no estructurados, describirlos y convertirlos en un circuito gestionado para un fine-tuning repetible.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.