AWS explica cómo escalar la memoria de los agentes de IA con patrones de namespace en AgentCore Memory
AWS ha publicado una guía detallada sobre cómo organizar la memoria de los agentes de IA en AgentCore Memory, el componente de Bedrock que almacena contexto a largo plazo en sistemas escalables. Describe cinco patrones de namespace, desde los acotados por usuario hasta las jerarquías multi-tenant, y tres estrategias de recuperación de datos. El servicio se integra de forma nativa con AWS IAM, de modo que los equipos pueden controlar el acceso de los agentes a la memoria con las mismas políticas que usan para el resto de su infraestructura.
Procesado por IA desde AWS Machine Learning Blog; editado por Hamidun News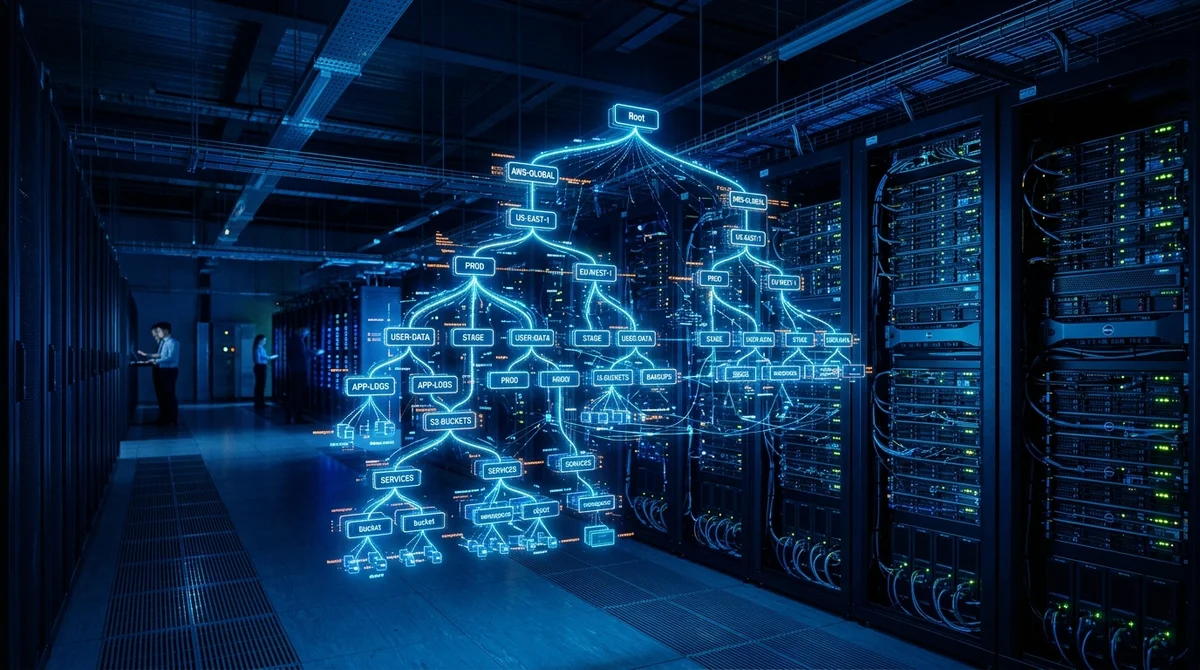
AWS ha publicado una guía sobre cómo organizar la memoria de los agentes de IA en AgentCore Memory, un servicio de la plataforma Bedrock para almacenar y estructurar contexto a largo plazo en sistemas de agentes escalables.
Qué es AgentCore Memory
AgentCore Memory es uno de los componentes de AWS Bedrock AgentCore, que apareció en 2025 como respuesta a las crecientes exigencias de los sistemas de agentes de nivel producción. El servicio resuelve un problema concreto: en las arquitecturas multiagente no basta con guardar el contexto en variables o en la sesión. Los datos deben estar disponibles entre solicitudes, agentes y usuarios al mismo tiempo.
La abstracción clave es el namespace (espacio de nombres), que define a quién pertenece cada fragmento de memoria y quién puede leerlo. Sin una estructura de namespace clara, los agentes empiezan a mezclar el contexto de distintos usuarios o pierden acceso a los datos que necesitan.
Patrones de jerarquías de namespace
Una estructura de namespace adecuada determina la velocidad y la precisión de la recuperación de memoria. AWS describe cinco patrones básicos:
- User-scoped: un namespace independiente para cada usuario. Aislamiento total, sin solapamientos entre cuentas.
- Session-scoped: la memoria vive solo dentro de una sesión. Es adecuado para tareas de corta duración que no requieren almacenamiento a largo plazo.
- Project-scoped: varios agentes comparten una memoria común dentro de un mismo proyecto o flujo de trabajo.
- Tenant-scoped: para productos SaaS, aislamiento estricto entre clientes a nivel de infraestructura.
- Hierarchical mix: combinaciones de varios niveles, por ejemplo `tenant/user/project`, para sistemas multi-tenant complejos.
Para la mayoría de los sistemas en producción, AWS recomienda un enfoque jerárquico de dos o tres niveles: ofrece flexibilidad sin complicar en exceso las consultas.
Patrones de recuperación de datos
Elegir la estrategia de recuperación es tan importante como la estructura de almacenamiento. La búsqueda semántica vectorial no es la única opción. AgentCore Memory admite varios modos: búsqueda directa por clave (rápida cuando la estructura de namespace está bien planificada), búsqueda semántica (para consultas difusas como «qué dijo el usuario sobre sus preferencias») y un modo híbrido, en el que primero el filtrado por namespace reduce el espacio de búsqueda y después la búsqueda semántica opera dentro de él.
El enfoque híbrido resulta especialmente valioso con grandes volúmenes de memoria: el prefiltrado reduce la latencia y mejora la precisión de los resultados.
Control de acceso mediante IAM
La integración nativa con AWS IAM es uno de los principales argumentos a favor de AgentCore Memory frente a las soluciones personalizadas. El acceso a los namespace se gestiona con las mismas políticas y roles que el resto de la infraestructura de AWS, sin un sistema de autorización aparte para la memoria de los agentes. En la práctica, esto permite construir un modelo de acceso claro:
- Un agente lee solo el namespace de su usuario y no ve los datos de otros
- Un agente orquestador obtiene acceso de lectura y escritura a todos los namespace del proyecto
- Una cuenta de servicio de CI/CD elimina namespace temporales sin acceso a los datos de los usuarios
- Los registros de auditoría de CloudTrail anotan automáticamente cada acceso de un agente a la memoria
Este modelo es especialmente importante en sectores regulados, como la banca, la sanidad o la abogacía, donde el aislamiento de datos entre clientes es un requisito legal y no una recomendación.
Qué significa
AWS va cerrando de forma sistemática las lagunas de infraestructura en los sistemas de agentes de nivel producción. Los patrones de namespace y la integración con IAM en AgentCore Memory abordan uno de los problemas más espinosos de las arquitecturas multiagente: quién puede leer qué de la memoria compartida, y cuándo. Los equipos reciben patrones listos para usar en lugar de soluciones a medida, y los clientes corporativos obtienen el cumplimiento de los requisitos de seguridad desde el primer momento.
- 31 oct 2026Worldwide Express encargó las facturas en disputa a agentes de IA y redujo su deuda un 75%
- 30 oct 2026AWS ofrece a los agentes de código una vista previa en vivo del sitio desde la sesión aislada
- 30 oct 2026MoEngage abre 400 API cerradas a agentes de IA con AgentCore Gateway, sin servidores MCP propios
- 29 oct 2026NVIDIA Nemotron 3.5 Super VL: 120 mil millones de parámetros, 12 mil millones activos, despliegue en AWS
Preguntas frecuentes sobre la noticia
¿Qué se sabe sobre Qué es AgentCore Memory?
AgentCore Memory es uno de los componentes de AWS Bedrock AgentCore, que apareció en 2025 como respuesta a las crecientes exigencias de los sistemas de agentes de nivel producción. El servicio resuelve un problema concreto: en las arquitecturas multiagente no basta con guardar el contexto en variables o en la sesión. Los datos deben estar disponibles entre solicitudes, agentes y usuarios al mismo tiempo. La abstracción clave es el namespace (espacio de nombres), que define a quién pertenece cada fragmento de memoria y quién puede leerlo. Sin una estructura de namespace clar
¿Qué se sabe sobre Patrones de jerarquías de namespace?
Una estructura de namespace adecuada determina la velocidad y la precisión de la recuperación de memoria. AWS describe cinco patrones básicos: User-scoped: un namespace independiente para cada usuario. Aislamiento total, sin solapamientos entre cuentas. Session-scoped: la memoria vive solo dentro de una sesión. Es adecuado para tareas de corta duración que no requieren almacenamiento a largo plazo. Project-scoped: varios agentes comparten una memoria común dentro de un mismo proyecto o flujo de trabajo. Tenant-scoped: para productos SaaS, aislamiento estricto entre clientes
¿Qué se sabe sobre Patrones de recuperación de datos?
Elegir la estrategia de recuperación es tan importante como la estructura de almacenamiento. La búsqueda semántica vectorial no es la única opción. AgentCore Memory admite varios modos: búsqueda directa por clave (rápida cuando la estructura de namespace está bien planificada), búsqueda semántica (para consultas difusas como «qué dijo el usuario sobre sus preferencias») y un modo híbrido, en el que primero el filtrado por namespace reduce el espacio de búsqueda y después la búsqueda semántica opera dentro de él. El enfoque híbrido resulta especialmente valioso con grandes v
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.