Micro1 contrata a personas de todo el mundo para entrenar humanoides mientras el mercado de la IA necesita nuevas pruebas
Mientras el mercado de los humanoides acelera, Micro1, Scale AI y DoorDash ya pagan a personas por grabar tareas domésticas cotidianas, desde planchar hasta fregar los platos. Los robots necesitan estos vídeos para aprender en el mundo real. Pero junto a este nuevo mercado de datos crecen también las dudas sobre la privacidad, el consentimiento y la calidad de las propias pruebas de IA: las puntuaciones altas en los benchmarks coinciden cada vez menos con la utilidad real en los flujos de trabajo.
Procesado por IA desde MIT Technology Review; editado por Hamidun News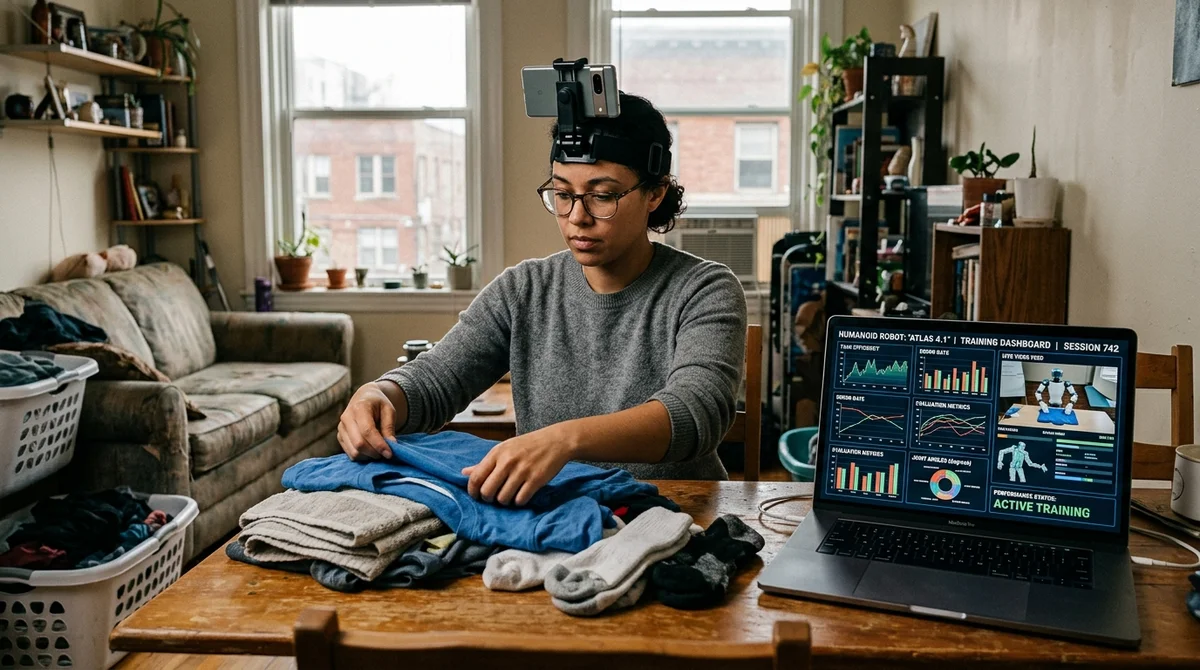
El mercado de la embodied AI ya no choca solo con los límites del hardware, sino también con los de los datos humanos: miles de personas en todo el mundo se graban en vídeo mientras lavan, planchan y limpian en casa para entrenar humanoides. En este contexto, cada vez más investigadores advierten de que las pruebas habituales de IA apenas dicen nada sobre cómo se comportarán estos sistemas en un trabajo real.
Cómo se entrena a los humanoides
Una de las empresas más visibles en esta nueva capa del mercado es Micro1. La compañía contrata a colaboradores externos en más de 50 países, entre ellos Nigeria, India y Argentina, para que graben acciones domésticas en primera persona: doblar ropa, fregar los platos, limpiar una mesa, servir agua o abrir la nevera. Para ello, se colocan un iPhone en la cabeza y graban clips cortos con las manos dentro del encuadre.
Después, los vídeos se revisan, se etiquetan y acaban en datasets que compran las empresas de robótica. La lógica es sencilla: a los grandes modelos de lenguaje les bastó con internet, pero los robots humanoides necesitan el mundo físico real. Las simulaciones ayudan a practicar movimientos, pero reproducen mal el caos de un piso normal: iluminación variable, cocinas estrechas, superficies resbaladizas, decenas de tipos de objetos y formas de interactuar con ellos.
Por eso en el mercado no solo aparecen Micro1 y Scale AI, que ha reunido más de 100.000 horas de este material, sino también nuevos canales como DoorDash Tasks. El 19 de marzo de 2026, DoorDash lanzó oficialmente un piloto en el que paga a sus repartidores por grabar acciones domésticas y registros de voz para IA y robótica.
Ni siquiera cientos de miles de horas de vídeo parecen, por ahora, cubrir la demanda del mercado.
«Esto llevará más tiempo del que mucha gente piensa», afirma el especialista en robótica
Ken Goldberg.
El precio de estos datos
Para muchos participantes es un buen trabajo complementario: una tarifa de unos 15 dólares por hora resulta competitiva en varios países. Pero el trabajo se vuelve monótono enseguida. Los participantes tienen que grabar una y otra vez acciones parecidas, inventar escenarios nuevos dentro de un piso pequeño y asegurarse de que la grabación cumple las instrucciones. Un trabajador de Delhi contaba que un vídeo útil de quince minutos puede costarle casi una hora, simplemente porque en casa no hay tantas tareas distintas que grabar.
- El iPhone u otro smartphone compatible se fija a la altura de la cabeza Los clips se graban en primera persona, normalmente de 1–2 minutos Las manos y el objeto deben permanecer en el encuadre casi todo el tiempo Se necesitan variaciones de iluminación, habitaciones, superficies y objetos Se procura no mostrar rostros, nombres ni otros datos personales La gran cuestión aquí no es tanto la rutina como la privacidad. Aunque la cara no aparezca, el vídeo recoge el interior de la vivienda, los medicamentos de la cocina, las cosas de los niños, la rutina diaria y a vecinos que se cuelan en el fondo. Además, los propios participantes a menudo no saben a quién se venden después sus grabaciones, cuánto tiempo se conservan ni si pueden conseguir que se borren. La investigadora Yasmine Kotturi sostiene sin rodeos que las empresas deben explicar de antemano a las personas hacia dónde puede llevar esta tecnología y cómo les afectará en el futuro.
Por qué fallan las pruebas
En paralelo a la carrera por los datos, se intensifica otro debate: cómo medir la calidad de la IA. La investigadora Angela Aristidou cree que el sector ha vivido demasiado tiempo con la lógica del examen escolar, en el que se compara al modelo con una persona en una tarea aislada con una respuesta correcta o incorrecta. En la vida real, eso casi nunca ocurre.
La IA se integra en equipos, normativas y procesos largos, donde no solo importan la precisión y la velocidad, sino también cómo influye el sistema en la coordinación entre personas, la carga de trabajo, la confianza y el número de errores en los pasos siguientes. Como alternativa, Aristidou propone el enfoque HAIC (Human–AI, Context-Specific Evaluation). La idea es evaluar no el modelo en el vacío, sino el funcionamiento del sistema dentro de la organización y a largo plazo.
En sus ejemplos, algunas IA médicas daban buenos resultados en las pruebas, pero en los hospitales ralentizaban el trabajo porque los médicos tenían que adaptar sus conclusiones a los estándares locales de documentación y a los requisitos de los reguladores. Este enfoque desplaza el foco en varias direcciones a la vez: De la tarea individual al trabajo en equipo y al flujo de trabajo De la prueba puntual al efecto a largo plazo De la precisión pura a la calidad de la coordinación y la detección de errores De la respuesta aislada a las consecuencias antes y después de su uso Para las empresas, es una idea incómoda pero útil. Una puntuación alta en un benchmark no significa todavía que la herramienta vaya a agilizar un hospital, un almacén, un servicio de atención al cliente o una organización humanitaria.
En uno de los casos que cita Aristidou, el sistema se evaluó durante 18 meses dentro de procesos reales y se midió por separado con qué facilidad las personas detectaban y corregían sus errores. Solo esa evaluación reveló qué mecanismos de protección hacían falta antes de un despliegue a gran escala.
Qué significa esto
La historia de los entrenadores domésticos de robots y el debate sobre los nuevos benchmarks comparten una conclusión: la industria de la IA depende cada vez menos de demos vistosas y cada vez más de la calidad de su infraestructura invisible. No ganarán solo quienes tengan el robot más espectacular o la puntuación más alta en los tests, sino quienes sepan recopilar datos reales de forma ética, explicar con claridad las reglas para su uso y demostrar la utilidad del sistema dentro de procesos reales, y no solo sobre un escenario.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.