El MIT desarrolla una metodología para detectar discriminación en sistemas de IA de apoyo a la decisión
Investigadores del MIT han desarrollado un marco para probar la ética de los sistemas autónomos de IA. La herramienta identifica con precisión en qué situaciones los sistemas de IA de apoyo a la decisión tratan a las personas de forma injusta. El método abarca la sanidad, el crédito y la justicia penal, es decir, todos los ámbitos donde los algoritmos toman decisiones que afectan a personas reales. El marco permite a desarrolladores y reguladores detectar sesgos antes de desplegar los sistemas.
Procesado por IA desde MIT News; editado por Hamidun News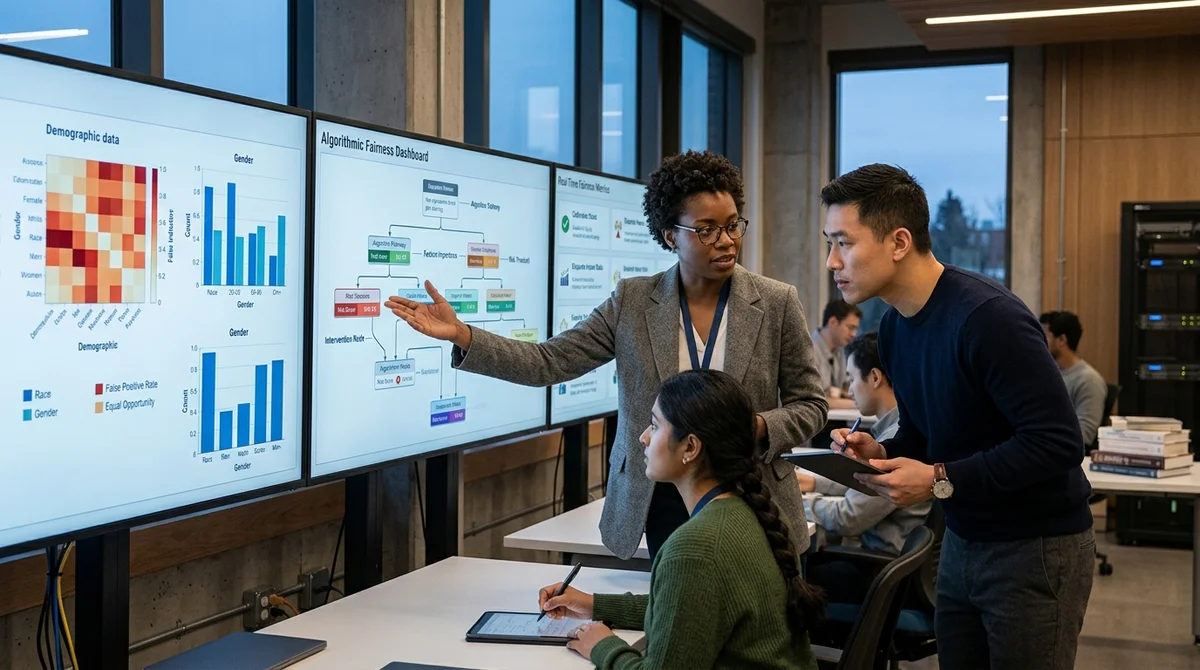
Investigadores del Instituto Tecnológico de Massachusetts han desarrollado un marco de pruebas que identifica de forma sistemática las situaciones en las que los sistemas autónomos de IA toman decisiones injustas sobre personas concretas y comunidades enteras. El trabajo cubre una de las lagunas clave en las herramientas de evaluación de la ética de la inteligencia artificial: la falta de una metodología capaz de encontrar discriminación no solo a nivel estadístico, sino también en escenarios concretos.
Dónde el sesgo causa daño
Los sistemas de apoyo a la decisión, es decir, los algoritmos que ayudan a decidir en sanidad, crédito, educación, selección de personal y justicia penal, se integran cada vez más en los procesos cotidianos. Es en esos ámbitos donde el sesgo algorítmico causa el daño real más palpable. Una persona recibe una negativa a su hipoteca, su currículum se descarta antes de la fase de entrevista o le imponen una pena más severa, todo ello sin una justificación explícita y, a menudo, sin posibilidad de recurrir la decisión.
Límites de los métodos existentes
Los enfoques actuales de auditoría de sistemas de IA suelen medir desigualdades demográficas en resultados agregados. Este análisis permite detectar grandes sesgos sistemáticos, pero pasa por alto casos sutiles de discriminación que dependen del contexto. Un sistema puede mostrar igualdad estadística en conjunto y, al mismo tiempo, dar de forma sistemática recomendaciones desfavorables a miembros de ciertos grupos cuando concurren circunstancias concretas del caso. Las métricas clásicas de equidad sencillamente no ven estas infracciones localizadas.
El enfoque por escenarios del MIT
El marco del MIT aborda el problema con un enfoque basado en escenarios. La herramienta genera automáticamente conjuntos de pruebas: situaciones en las que varían parámetros concretos, como las características demográficas del solicitante, su historial de solicitudes, la formulación de las preguntas y el contexto asociado. Después, el sistema analiza cómo reacciona el modelo de IA a estas variaciones e identifica patrones que apuntan a un trato injusto.
La diferencia clave es que el marco busca no solo brechas estadísticas entre grupos demográficos, sino también los desencadenantes situacionales concretos que provocan conclusiones sesgadas. En las pruebas con varios sistemas de IA reales, los investigadores confirmaron que el sesgo se concentra con frecuencia en escenarios estrechos y específicos que una auditoría estándar sencillamente pasa por alto. Esto significa que los desarrolladores y reguladores que se apoyan solo en métricas agregadas pueden tener una falsa sensación de seguridad, mientras la discriminación real sigue ocurriendo en casos individuales.
Aplicación práctica y regulación
El equipo del MIT diseñó la herramienta deliberadamente para que sea práctica y no solo de investigación. La metodología es compatible con los estándares existentes de IA responsable, en particular con el NIST AI Risk Management Framework, y potencialmente podría integrarse en los procedimientos obligatorios de verificación de sistemas antes de su salida al mercado. Los autores describen posibles usos, desde revisiones internas en las empresas desarrolladoras hasta auditorías independientes por parte de los reguladores.
El estudio llega en un contexto de creciente presión regulatoria sobre la industria de la IA. En Europa, la AI Act obliga a los proveedores de sistemas de alto riesgo a someterse a una evaluación de riesgos y a mantener documentación. En Estados Unidos, varios estados ya han introducido legislación sobre responsabilidad algorítmica, y las agencias federales prestan cada vez más atención a la discriminación algorítmica.
En este contexto, las herramientas de prueba estandarizadas son justo lo que hoy les falta a los reguladores.
Conclusión
El trabajo del MIT plantea una conclusión sencilla pero importante: la ética de la IA no es solo una cuestión de intenciones y declaraciones, sino también de verificación. Sin herramientas capaces de detectar la injusticia en situaciones concretas, incluso los desarrolladores más diligentes corren el riesgo de lanzar un sistema con infracciones inadvertidas. El nuevo marco ofrece un paso concreto para que las promesas de una IA justa sean verificables en la práctica.
- 31 oct 2026Un autor sometió su guion a un jurado de IA: el veredicto costó 850.000 tokens
- 29 oct 2026OvisOCR3: un modelo de 0,8 mil millones de parámetros que lee documentos mejor que los sistemas especializados
- 29 oct 2026Tencent lanza Youtu-Parsing-Omni: un solo modelo analiza documentos, audio y video
- 28 oct 2026Liquid AI lanza LFM2.5-24B-A2B: un modelo para agentes con 2B de parámetros activos
Preguntas frecuentes sobre la noticia
Dónde el sesgo causa daño?
Los sistemas de apoyo a la decisión, es decir, los algoritmos que ayudan a decidir en sanidad, crédito, educación, selección de personal y justicia penal, se integran cada vez más en los procesos cotidianos. Es en esos ámbitos donde el sesgo algorítmico causa el daño real más palpable. Una persona recibe una negativa a su hipoteca, su currículum se descarta antes de la fase de entrevista o le imponen una pena más severa, todo ello sin una justificación explícita y, a menudo, sin posibilidad de recurrir la decisión.
¿Qué se sabe sobre Límites de los métodos existentes?
Los enfoques actuales de auditoría de sistemas de IA suelen medir desigualdades demográficas en resultados agregados. Este análisis permite detectar grandes sesgos sistemáticos, pero pasa por alto casos sutiles de discriminación que dependen del contexto. Un sistema puede mostrar igualdad estadística en conjunto y, al mismo tiempo, dar de forma sistemática recomendaciones desfavorables a miembros de ciertos grupos cuando concurren circunstancias concretas del caso. Las métricas clásicas de equidad sencillamente no ven estas infracciones localizadas.
¿Qué se sabe sobre El enfoque por escenarios del MIT?
El marco del MIT aborda el problema con un enfoque basado en escenarios. La herramienta genera automáticamente conjuntos de pruebas: situaciones en las que varían parámetros concretos, como las características demográficas del solicitante, su historial de solicitudes, la formulación de las preguntas y el contexto asociado. Después, el sistema analiza cómo reacciona el modelo de IA a estas variaciones e identifica patrones que apuntan a un trato injusto. La diferencia clave es que el marco busca no solo brechas estadísticas entre grupos demográficos, sino también los desenca
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.