PageIndex, de VectifyAI, propone búsquedas sin embeddings para documentos largos
PageIndex, de VectifyAI, plantea otra forma de trabajar con documentos largos: en lugar de chunks y una base de datos vectorial, el sistema genera un índice jerárquico con resúmenes y solo entrega al LLM las páginas necesarias. La idea resulta potente para PDF financieros, jurídicos y técnicos, pero la precisión tiene un precio en tokens, en velocidad y en una escalabilidad limitada cuando se trata de grandes colecciones de documentos.
Procesado por IA desde Habr AI; editado por Hamidun News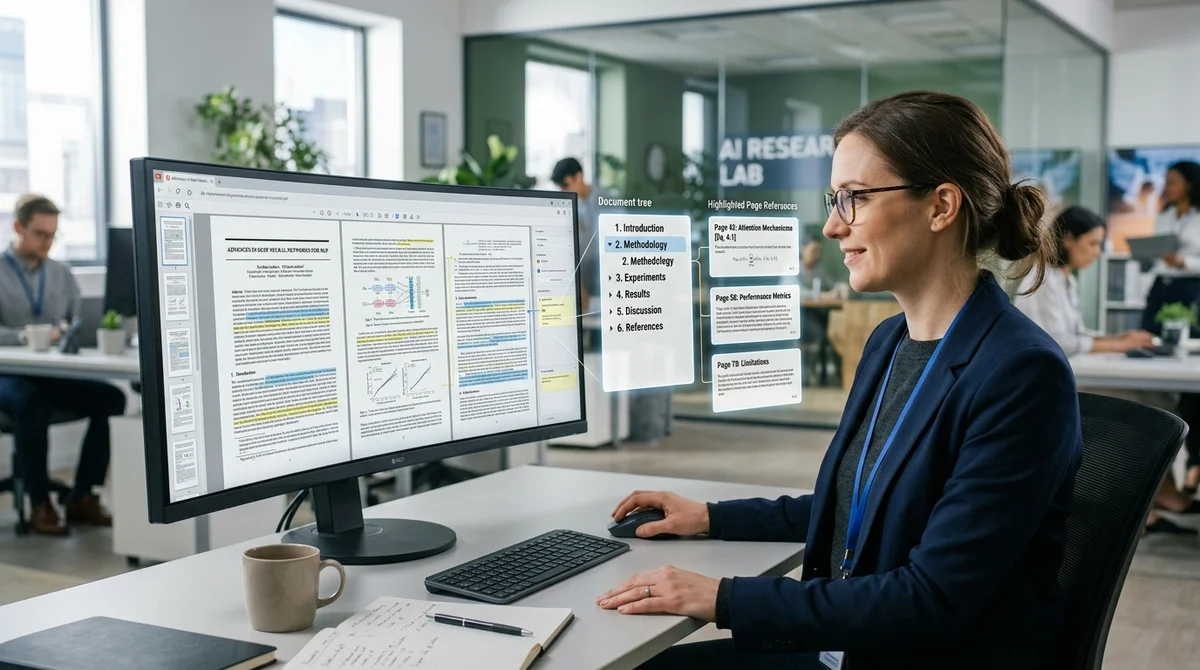
PageIndex es uno de los nuevos aspirantes más visibles al papel de «RAG sin base de datos vectorial». En lugar del esquema habitual con embeddings y chunks, el sistema crea para cada documento un índice jerárquico con breves descripciones de cada sección y después pide a un LLM que elija, mediante razonamiento, los nodos relevantes y las páginas asociadas. El enfoque resulta novedoso y, con PDF largos y bien estructurados, realmente puede funcionar de una forma más parecida a como una persona lee un documento.
Cómo funciona PageIndex
La mecánica de PageIndex es relativamente sencilla. Primero, el documento se divide por páginas. Después, el modelo y un código auxiliar construyen un TOC ampliado: un árbol de secciones con títulos, rangos de páginas y un resumen de cada nodo. Cuando llega una pregunta, el prompt no recibe el documento completo ni un conjunto de fragmentos de texto al azar, sino precisamente esa estructura. El LLM selecciona las ramas relevantes del árbol y, a continuación, la consulta final incluye solo las páginas vinculadas a ellas. Así, el sistema prescinde de embeddings, de almacenamiento vectorial y del chunking artificial, que a menudo rompe el sentido en los límites entre fragmentos.
Por qué despierta interés el proyecto
Por eso PageIndex genera tanto interés. Con informes financieros extensos, documentos jurídicos, manuales técnicos y materiales educativos, este enfoque resulta natural: una persona también suele empezar por el índice, no por repasar el texto a trozos. En el repositorio del proyecto, los desarrolladores de VectifyAI presentan abiertamente el sistema como reasoning-based retrieval y afirman que en FinanceBench ayudó a alcanzar una precisión del 98,7%. Para los equipos que trabajan con un único documento grande o con una pequeña colección de PDF complejos, suena como una alternativa sólida al pipeline de RAG convencional, sobre todo si buscan una recuperación más interpretable, con referencias claras a secciones y páginas.
Dónde están los límites del enfoque
Sin embargo, la cuestión principal no es si se puede sustituir la búsqueda vectorial por PageIndex, sino dónde están los límites de este enfoque. Las críticas son bastante prosaicas. En primer lugar, el TOC también hay que almacenarlo en algún sitio, sobre todo si hay más de un documento, así que hablar de algo «totalmente sin índice» es algo engañoso.
En segundo lugar, todavía no se ve una estrategia convincente para seleccionar documentos en colecciones grandes: los metadatos, la keyword search, TF-IDF y BM25 no desaparecen y a menudo siguen siendo un primer filtro barato. En tercer lugar, el reasoning retrieval resulta casi inevitablemente más caro en tokens y más lento en tiempo de respuesta. Si un buen RAG vectorial ya ofrece alrededor del 90% de calidad, los puntos adicionales de precisión pueden salir varias veces más caros, y no para todos los productos es un intercambio razonable.
Limitaciones prácticas y puesta en marcha
La práctica también revela limitaciones. Un análisis señala que PageIndex se desenvolvió mal con textos literarios sin una estructura explícita: si el documento no tiene secciones ni títulos, no hay nada sobre lo que construir un «índice inteligente». Con textos académicos los resultados fueron mejores, porque cuentan con una jerarquía de secciones normal.
El sistema se puede ejecutar en local a partir del repositorio abierto: hay que instalar las dependencias, configurar la clave de API de un LLM compatible a través de LiteLLM y procesar un PDF o un markdown con run_pageindex.py. Pero aquí también hay matices: el autor advierte específicamente sobre la versión de LiteLLM, desaconseja instalar el paquete en la nube pageindex desde pip para trabajar en local y explica que, con modelos locales poco potentes, la calidad del árbol cae de forma notable, y que el proceso puede tardar decenas de minutos incluso con un documento relativamente pequeño.
Qué significa esto en la práctica
¿Qué significa esto en la práctica? PageIndex no parece un asesino de la búsqueda vectorial, pero sí una nueva capa útil en la arquitectura RAG. Lo más lógico es verlo no como un sustituto directo, sino como una herramienta especializada para documentos largos y estructurados, donde importan la explicabilidad, la precisión en la navegación y el trabajo por páginas. El escenario más realista es híbrido: primero, una búsqueda barata por metadatos o vectores; después, PageIndex para seleccionar con precisión las secciones. Este compromiso refleja mejor la realidad: todavía no ha aparecido un sustituto universal del RAG vectorial, pero los enfoques document-first como PageIndex ya tienen su propio nicho bien definido.
En resumen:
- PageIndex, de VectifyAI, es un «RAG sin base de datos vectorial»: construye un índice jerárquico y pide a un LLM que elija los nodos y páginas relevantes.
- El sistema prescinde de embeddings y de chunking; sus desarrolladores afirman haber alcanzado una precisión del 98,7% en FinanceBench.
- Es más realista ver PageIndex como una capa para documentos largos y estructurados dentro de un esquema híbrido, y no como un sustituto del RAG vectorial.
- 28 oct 2026Anthropic revela cómo construye Claude con el propio Claude: el cerebro, separado de las manos
- 28 oct 2026Bayer lanza un motor multiagente sobre AgentCore: el 80% de las consultas, sin ingenieros
- 28 oct 2026Liquid AI lanza LFM2.5-24B-A2B: un modelo para agentes con 2B de parámetros activos
- 28 oct 2026AgentOrch: el plan de IA trazado por adelantado ya solo pierde por 8,5 puntos frente al paso a paso
Preguntas frecuentes sobre la noticia
Cómo funciona PageIndex?
La mecánica de PageIndex es relativamente sencilla. Primero, el documento se divide por páginas. Después, el modelo y un código auxiliar construyen un TOC ampliado: un árbol de secciones con títulos, rangos de páginas y un resumen de cada nodo. Cuando llega una pregunta, el prompt no recibe el documento completo ni un conjunto de fragmentos de texto al azar, sino precisamente esa estructura. El LLM selecciona las ramas relevantes del árbol y, a continuación, la consulta final incluye solo las páginas vinculadas a ellas. Así, el sistema prescinde de embeddings, de almacenami
¿Qué se sabe sobre Por qué despierta interés el proyecto?
Por eso PageIndex genera tanto interés. Con informes financieros extensos, documentos jurídicos, manuales técnicos y materiales educativos, este enfoque resulta natural: una persona también suele empezar por el índice, no por repasar el texto a trozos. En el repositorio del proyecto, los desarrolladores de VectifyAI presentan abiertamente el sistema como reasoning-based retrieval y afirman que en FinanceBench ayudó a alcanzar una precisión del 98,7%. Para los equipos que trabajan con un único documento grande o con una pequeña colección de PDF complejos, suena como una alte
Dónde están los límites del enfoque?
Sin embargo, la cuestión principal no es si se puede sustituir la búsqueda vectorial por PageIndex, sino dónde están los límites de este enfoque. Las críticas son bastante prosaicas. En primer lugar, el TOC también hay que almacenarlo en algún sitio, sobre todo si hay más de un documento, así que hablar de algo «totalmente sin índice» es algo engañoso. En segundo lugar, todavía no se ve una estrategia convincente para seleccionar documentos en colecciones grandes: los metadatos, la keyword search, TF-IDF y BM25 no desaparecen y a menudo siguen siendo un primer filtro barato
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.