Habr: cómo los datos sintéticos ayudan a entrenar modelos y por qué el self-training lleva al colapso
La industria de la IA recurre cada vez más a los datos sintéticos como sustituto de unos datos humanos caros y escasos. Aceleran el entrenamiento, ayudan a cubrir escenarios poco frecuentes y permiten escalar los experimentos. Pero si un modelo se entrena durante demasiado tiempo con sus propias generaciones, corre el riesgo de sufrir un colapso del modelo: la distribución se estrecha, los casos raros desaparecen, las respuestas se vuelven monótonas y la transferencia a tareas nuevas empeora con el tiempo.
Procesado por IA desde Habr AI; editado por Hamidun News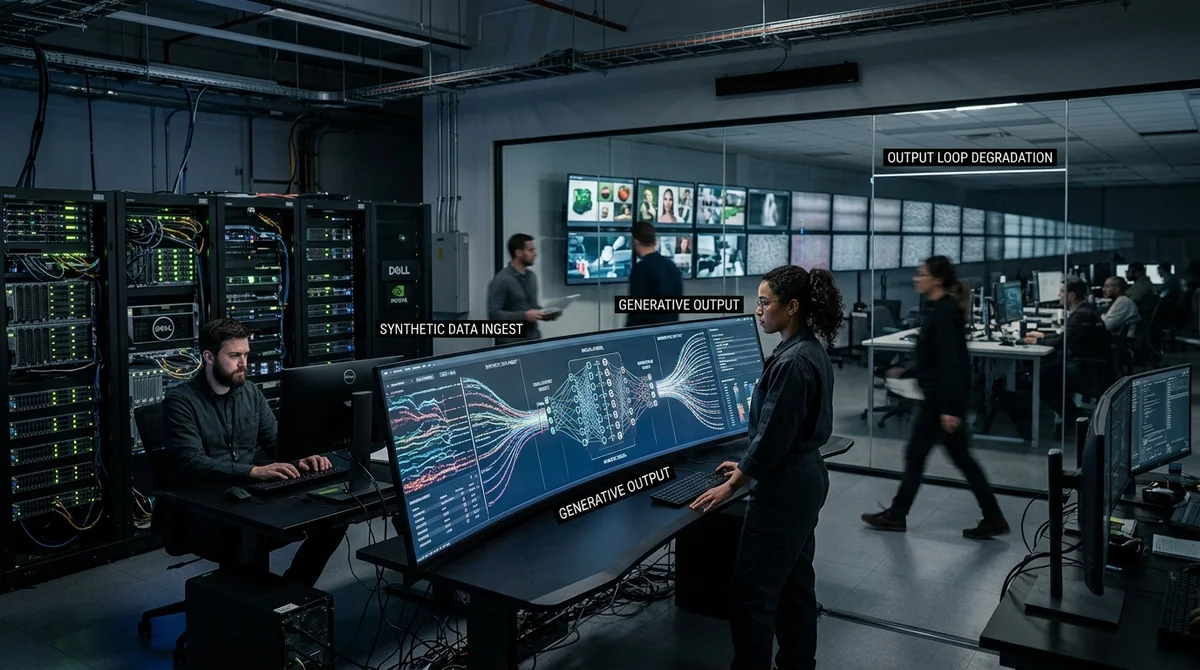
Para la industria de la IA, los datos sintéticos no son un truco de moda, sino una forma de prolongar el crecimiento de los modelos ante la escasez de corpus humano de calidad. La capacidad de cómputo se puede comprar, pero los buenos datos son cada vez más caros, se limpian despacio y a menudo chocan con límites de privacidad, derechos de autor y disponibilidad. Por eso las empresas crean cada vez más datos por sí mismas: generan textos, diálogos, imágenes, anotaciones y escenarios, y luego los usan para seguir entrenando.
Funciona, pero solo hasta el punto en que el modelo empieza a encerrarse en sus propias respuestas y pierde poco a poco el contacto con la distribución real del mundo.
La razón es clara: buena parte de internet abierto ya se ha agotado, los nuevos conjuntos de datos son caros y las exigencias de calidad no dejan de crecer. Para un modelo potente no basta con reunir miles de millones de tokens; además hay que eliminar basura, repeticiones, errores, fragmentos legalmente dudosos y toxicidad accidental. En este contexto, los datos sintéticos parecen el combustible casi ideal. Se pueden producir rápido, para una tarea concreta y con el equilibrio de clases deseado. Si al sistema le faltan ejemplos de rechazos poco frecuentes, diálogos largos, instrucciones especializadas o casos límite, la síntesis permite cubrir esos huecos mucho más deprisa que la recopilación y el etiquetado manuales.
Aquí entra el self-training, o autoentrenamiento: se entrena el modelo con respuestas que generó antes él mismo u otro modelo de la misma familia. En su forma moderada, este enfoque es útil. Primero un sistema potente crea ejemplos preliminares; después un filtro más estricto, una regla o una persona descarta las variantes débiles, y el conjunto final pasa al entrenamiento. Así se pueden escalar instrucciones, sintetizar combinaciones raras de rasgos y obtener datos adicionales donde las personas no dan abasto con el ritmo de los experimentos. En aplicaciones prácticas resulta especialmente valioso para probar asistentes, entrenar sistemas con reglas formales y equilibrar conjuntos de datos en los que las observaciones reales están sesgadas de antemano.
Los problemas empiezan cuando la recursión deja de estar controlada. Si un modelo aprende muchas veces seguidas de sus propias generaciones, amplifica no solo los patrones útiles, sino también sus propias distorsiones. Las respuestas más frecuentes se vuelven aún más probables, mientras que los casos raros, ruidosos y poco convencionales se diluyen.
Eso es lo que se llama colapso del modelo (model collapse): la distribución de los datos se contrae, la diversidad disminuye y el sistema distingue peor los límites de la realidad. Desde fuera, la degradación puede no parecer dramática, porque el modelo sigue escribiendo con fluidez y seguridad, pero por dentro pierde profundidad. Se topa menos con ejemplos inesperados, transfiere peor el conocimiento a dominios nuevos y reproduce con más frecuencia una versión promediada del mundo en la que todo lo complejo ya se ha borrado.
Por eso los datos sintéticos son útiles no como sustituto total de los datos humanos, sino como una capa sobre ellos. Un esquema de trabajo habitual es este: el corpus real fija la distribución de referencia, los datos sintéticos amplían la cobertura y el control de calidad impide que el modelo caiga en un circuito cerrado. Para ello hacen falta validación con conjuntos independientes, mezcla de datos humanos recientes, comprobación de casos raros y filtros que descarten generaciones demasiado formulaicas.
Cuanto mayor es la proporción de datos sintéticos, más importante es recordar que aquí la calidad no la determina el volumen, sino la diversidad y la cercanía a la realidad. De lo contrario, la ganancia rápida en coste y velocidad se convierte en una degradación oculta, que puede notarse solo cuando el producto ya ha empezado a funcionar peor con usuarios reales.
La conclusión principal es que los datos sintéticos y el self-training no eliminan el problema de los datos, solo cambian la forma de abordarlo. Son un acelerador potente si se usan en dosis medidas y bajo control. Pero si la generación se convierte en un espejo infinito, el modelo empezará a aprender no del mundo, sino de su propia sombra estadística. En la próxima etapa de la IA no ganarán quienes simplemente sinteticen más, sino quienes logren mantener el contacto con la realidad y con la diversidad de los datos originales.
- 2 may 2026Meta presenta Autodata, un sistema agéntico para crear datos de entrenamiento de calidad
- 31 may 2026LangChain lanza Mission Control para gestionar LangSmith en Kubernetes
- 14 feb 2026Guía para crear un pipeline de datos sintéticos con CTGAN y SDV
- 2 may 2026Mantis Biotech crea gemelos digitales de personas para paliar la escasez de datos médicos
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.