NVIDIA muestra un pipeline completo de optimización de modelos con FastNAS pruning y fine-tuning
NVIDIA ha publicado una guía paso a paso de Model Optimizer que monta en Google Colab un ciclo completo de optimización de modelos: entrenamiento de ResNet20 en CIFAR-10, FastNAS pruning con un límite de 60 millones de FLOPs y posterior fine-tuning. La guía es útil porque no enseña un truco aislado, sino un pipeline de ingeniería reproducible, con checkpoints guardados, restauración del modelo podado y comparación de la precisión antes y después de la compresión.
Procesado por IA desde MarkTechPost; editado por Hamidun News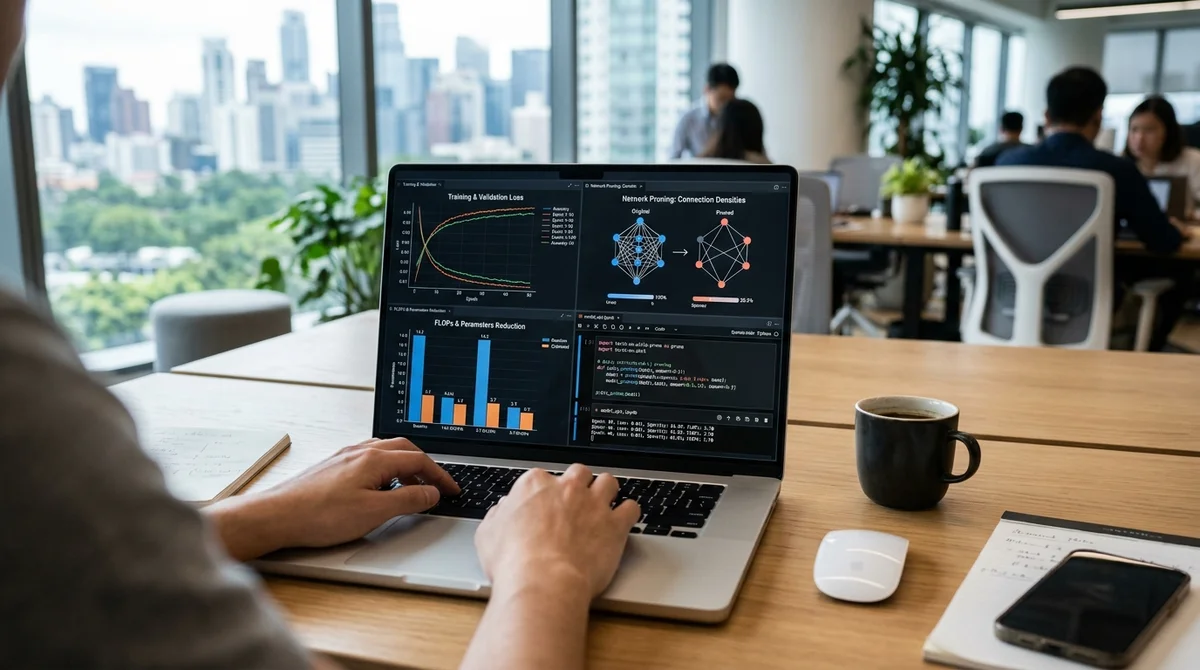
NVIDIA ha publicado una guía práctica que recorre el ciclo completo de optimización de una red neuronal en un único notebook de Google Colab: del entrenamiento base al pruning estructural y el posterior reentrenamiento. Como ejemplo, la compañía usa su biblioteca NVIDIA Model Optimizer, el dataset CIFAR-10 y el modelo ResNet20, y muestra con código real cómo reducir la carga computacional de la red sin convertir el proceso en un conjunto de scripts sueltos y experimentos manuales.
La guía arranca con la preparación del entorno y de un experimento reproducible. Se instalan nvidia-modelopt, torchvision, torchprofile y otras dependencias auxiliares, se fijan la semilla aleatoria y los parámetros de ejecución, y después se monta una configuración simplificada pero funcional para Colab. El batch size es de 256, el modelo base se entrena durante 20 épocas y la fase de fine-tuning posterior al pruning dura otras 12 épocas.
Para acelerar el proceso se usan subconjuntos de CIFAR-10: 12 mil imágenes para entrenamiento, 2 mil para validación y 4 mil para test. Después, los autores definen a mano ResNet20 en PyTorch, con bloques residuales, inicialización propia de pesos y lógica explícita de conexiones shortcut. No es una caja negra, sino una arquitectura que se puede adaptar rápidamente a la tarea de cada uno.
La guía pone un énfasis especial en la infraestructura de ingeniería. Para el entrenamiento se aplican aumentos de datos estándar, como el recorte aleatorio de 32x32 y el volteo horizontal, mientras que para la evaluación solo se mantiene la normalización. El entrenamiento usa SGD con momentum 0.
9, weight decay 1e-4 y un planificador de tasa de aprendizaje con cosine decay y warmup. El código incluye funciones separadas para una época de entrenamiento, validación, test y guardado del mejor checkpoint según la precisión en validación. El detalle es importante: NVIDIA no demuestra solo la técnica de compresión, sino un pipeline completo y reproducible en el que se puede controlar la calidad del modelo antes y después de la optimización, en lugar de lanzar el pruning como un truco puntual.
La etapa clave es el FastNAS pruning. El ejemplo fija un límite de 60 millones de FLOPs y configura la búsqueda para que el número de canales y de características sea múltiplo de 16. Como score function se usa la precisión en validación y, antes de la ejecución, los autores corrigen por separado la compatibilidad con torchprofile para que los FLOPs se calculen bien en Colab. Después, Model Optimizer construye una subred más ligera, la guarda y permite restaurar la arquitectura ya optimizada para el siguiente paso.
Aquí se ve cómo posiciona NVIDIA a Model Optimizer: no solo como biblioteca de pruning, sino como una capa única para técnicas de optimización de modelos. En el repositorio oficial, la compañía lo describe como un conjunto de herramientas para pruning, quantization, distillation, sparsity y otros métodos, que luego pueden integrarse en infraestructura de inferencia como TensorRT, TensorRT-LLM o vLLM.
Tras encontrar la subred optimizada empieza el fine-tuning. Primero se vuelve a evaluar el modelo podado restaurado, luego se reentrena con un learning rate más suave y, al final, se comparan la precisión antes del pruning, después del pruning y después del reentrenamiento. Además se calculan el número total de parámetros, la cantidad de pesos distintos de cero y el tiempo dedicado a cada etapa: entrenamiento base, búsqueda con FastNAS y recuperación de la calidad. También se guardan todos los artefactos clave: el state dict base, el checkpoint de la búsqueda, el modelo podado y la versión optimizada final.
Para los ingenieros de ML en activo, el valor está en que el escenario se puede repetir casi sin cambios sobre una arquitectura propia e integrar en el proceso de preparación de un modelo para una inferencia más barata y rápida.
La conclusión principal es que NVIDIA convierte la optimización de modelos en parte del pipeline estándar de ML, y no en una tarea aparte en la fase final previa al despliegue. Este enfoque importa especialmente ahora, cuando el coste de cómputo, las restricciones de latencia y los requisitos de despliegue influyen cada vez más en las decisiones de arquitectura, tanto como la propia precisión.
El material es útil por su lógica aplicada: muestra cómo pasar de una red base densa a una versión más eficiente mediante un proceso reproducible y comprensible, que de verdad se puede ejecutar incluso en Google Colab.
- 1 nov 2026Prueba de 16 modelos en 7 buscadores: Exa obtuvo una media de 10,5 puntos de 14; SearXNG, en torno a 3
- 1 nov 2026StreamVibe, el agente de vídeo de Google, supera en un 10,7 % a otros modelos en momento y calidad de respuesta
- 1 nov 2026OpenAI reescribe las reglas de comportamiento de GPT: cinco valores y una cadena de prioridades
- 1 nov 2026Los bots de voz con LLM recurren al clasificador rápido Jev: decisiones en 200–500 ms
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.