TII lanza Falcon Perception, un modelo de 0,6B para segmentar y localizar objetos a partir de texto
TII ha lanzado Falcon Perception, un modelo de 0,6 mil millones de parámetros que entiende consultas de texto sobre imágenes y devuelve directamente máscaras precisas de los objetos. En lugar del esquema clásico de «codificador visual + decodificador», usa un único Transformer de fusión temprana. En SA-Co el modelo obtuvo 68,0 de Macro-F1 frente a 62,3 de SAM 3, y la ventaja es aún mayor en consultas espaciales y de OCR difíciles.
Procesado por IA desde MarkTechPost; editado por Hamidun News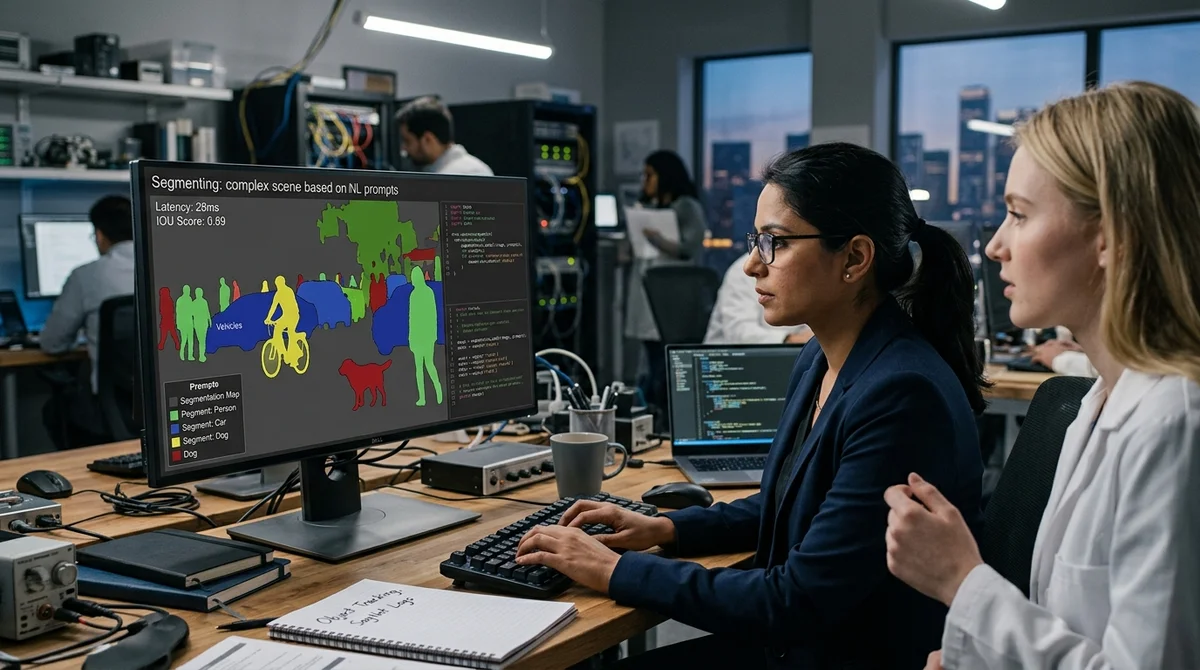
El 1 de abril de 2026, TII presentó Falcon Perception, un modelo multimodal compacto de 0,6 mil millones de parámetros que puede encontrar y segmentar objetos en una imagen a partir de una consulta de texto simple, sin una lista fija de clases. Para el mercado es una señal importante: las tareas de comprensión visual, que durante mucho tiempo se resolvieron con complejas cadenas de bloques separados, ahora pueden abordarse con una única arquitectura común, con licencia abierta y sin un modelo gigantesco.
La mayoría de los sistemas modernos de visión por computador siguen construyéndose de forma modular: un codificador extrae características visuales, otro bloque las mezcla con el texto y después un decodificador independiente predice recuadros, máscaras o respuestas. Este enfoque funciona, pero escala mal: cada nuevo tipo de error suele corregirse con un módulo nuevo, y la interacción entre lenguaje e imagen sigue siendo limitada. Con Falcon Perception, el equipo del Technology Innovation Institute de Abu Dabi apuesta por la fusión temprana: imagen y texto entran en una misma secuencia de tokens desde la primera capa del transformer.
Arquitectónicamente, el modelo es un único Transformer con un esquema de atención híbrido. Los tokens de imagen se ven entre sí de forma bidireccional y construyen un contexto visual global, mientras que los tokens de texto y los especiales se decodifican de forma causal, apoyándose en la imagen ya procesada. Por cada objeto encontrado, el modelo recorre una cadena corta de pasos: primero determina las coordenadas del centro, luego el tamaño y después construye la máscara de segmentación. Esta interfaz permite trabajar con un número variable de objetos, desde cero hasta cientos en una misma imagen, y evita que la generación de máscaras resulte demasiado costosa en cómputo.
Detrás hay una preparación de datos considerable. La inicialización se hizo mediante destilación de DINOv3 y SigLIP2, para combinar sólidas características visuales locales con un mejor anclaje al lenguaje. Después se entrenó el modelo con un conjunto de 54 millones de imágenes, 195 millones de expresiones de texto positivas y 488 millones de ejemplos hard negative. Para la anotación automática y la selección se usó un conjunto de SAM 3, Qwen3-VL-30B y Moondream3, y los casos dudosos se enviaron a revisión manual. Por separado, TII presentó PBench, un nuevo benchmark de diagnóstico que desglosa los resultados por nivel de dificultad: desde objetos simples hasta indicaciones con OCR, relaciones espaciales y escenas densas con cientos de instancias.
Las métricas resultan convincentes. En SA-Co, uno de los benchmarks de segmentación abierta, Falcon Perception obtuvo 68,0 de Macro-F1 frente a 62,3 de SAM 3. La mejora es especialmente notable donde no basta con «reconocer el objeto»: atributos y subtipos, consultas con texto dentro de la imagen y formulaciones espaciales como «el coche de la izquierda» o «la tercera ventana por la izquierda».
En PBench la diferencia en objetos simples es pequeña, pero en tareas espaciales llega a 21,9 puntos, en consultas guiadas por OCR a 13,4 y en tareas relacionales a 15,8. El punto débil por ahora es la calibración de presencia: en MCC el modelo queda por detrás de SAM 3, con 0,64 frente a 0,82, es decir, en escenarios negativos difíciles todavía se equivoca más a menudo al responder «el objeto no está».
El modelo también tiene un lado práctico. Falcon Perception se distribuye con licencia Apache 2.0, está disponible en Hugging Face y GitHub, y está pensado no solo para experimentos de laboratorio, sino también para su uso en aplicaciones. La inferencia emplea una pila basada en PyTorch FlexAttention y paged KV cache; según el equipo, en una H100 las latencias típicas son de unos 100 ms para el prefill, unos 200 ms para el upsampling de características y aproximadamente 50 ms para decodificar varias instancias. TII también demostró que la misma receta de fusión temprana se traslada al OCR: el modelo complementario Falcon OCR, de 0,3 mil millones de parámetros, obtuvo 80,3 en olmOCR y 88,64 en OmniDocBench.
La conclusión principal no es que TII haya lanzado otro modelo visión-lenguaje compacto. Lo más relevante es que Falcon Perception demuestra la viabilidad de un enfoque más simple e integrado de la comprensión visual: una arquitectura, una pila común y menos parches entre lenguaje y visión. Si el equipo mejora la calibración de presencia y reduce los falsos positivos en escenarios hard negative, Falcon tiene opciones de convertirse en una base sólida para asistentes, robótica, búsqueda visual e interfaces donde la imagen debe entenderse a partir de texto humano y no de una lista de clases predefinida.
- 2 nov 2026Karpathy montó en dos horas un clon de YouTube con 6454 vídeos recomendados en Hacker News
- 2 nov 2026Karpathy usó Claude para crear HackerTube, con 6454 vídeos recomendados en Hacker News
- 2 nov 2026Microsoft lanza Mage-VL-Cowork, un modelo de 4B que resuelve el 66,0% de las tareas de OSWorld-Verified
- 1 nov 2026Los modelos locales pierden ante Opus y Codex: 0,21 puntos en un MacBook frente a 1,00 de Codex
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.