ClawRouter redujo el gasto en la API de LLM de 47 a 1,80 dólares en una semana: análisis del router inteligente
Una factura semanal de 47 dólares en la API de LLM bajó a 1,80 dólares tras instalar ClawRouter, un router de código abierto que analiza cada prompt con 15 parámetros y lo envía al modelo adecuado más barato. La mitad de las solicitudes resultó ser trivial y la atendieron modelos económicos sin pérdida de calidad. ClawRouter es compatible con la API de OpenAI, se coloca como proxy y no exige cambios en el código de la aplicación.
Procesado por IA desde Habr AI; editado por Hamidun News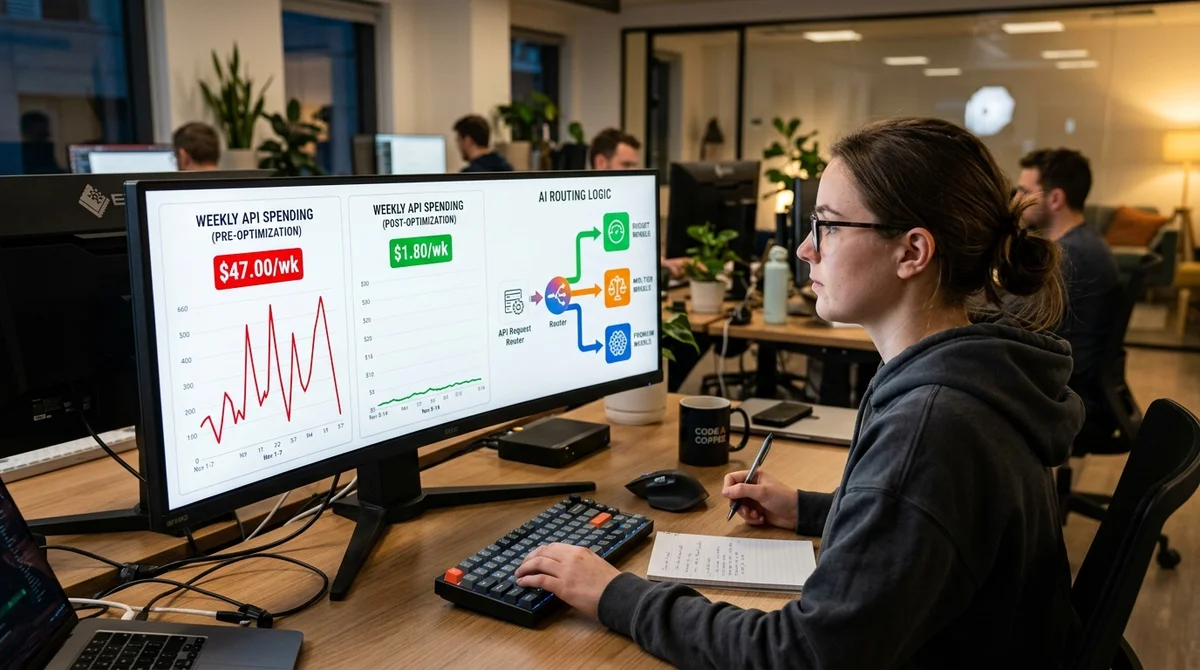
Los desarrolladores que usan activamente APIs de LLM en proyectos de producción suelen llevarse un disgusto: buena parte de las solicitudes a modelos insignia caros son tareas elementales que un modelo económico habría resuelto. Eso fue lo que descubrió un autor de Habr: en una sola semana de trabajo gastó 47 dólares en APIs de LLM, aunque, según su propia estimación, la mitad de los prompts era trivial. Tras instalar ClawRouter, un router de código abierto para solicitudes a LLM, reprodujo la misma semana por 1,80 dólares. El ahorro fue de más del 96%.
La lógica detrás de esa cifra es simple: no todas las tareas son igual de complejas, pero sin enrutamiento cada solicitud se cobra a la tarifa del modelo elegido, sin importar su complejidad real. Si usas Claude Sonnet o GPT-4o por defecto para todo, pagas un precio premium por respuestas a preguntas triviales y transformaciones simples de texto.
El coste de las APIs de LLM se vuelve más acuciante a medida que los desarrolladores pasan de los experimentos a las cargas de producción. En la fase de prototipo el gasto es insignificante, pero en producción crece en proporción a la actividad de los usuarios. Una solicitud a GPT-4o cuesta entre 20 y 30 veces más que una equivalente a GPT-4o Mini, y en la mayoría de las tareas la diferencia de calidad es imperceptible. La arquitectura de «un prompt, un modelo caro» es la más extendida, aunque también la menos óptima.
ClawRouter es un servidor proxy de código abierto que se sitúa entre tu aplicación y los proveedores de LLM. Cada prompt entrante se analiza con 15 parámetros: complejidad de la tarea, longitud y estructura del contexto, necesidad de razonamiento paso a paso, trabajo con código, requisitos de formato de salida, sensibilidad a los errores y otros rasgos. Con esa clasificación, la solicitud se dirige automáticamente al modelo más barato capaz de resolver la tarea con un nivel de calidad aceptable.
Una pregunta sencilla va a GPT-4o Mini o Claude Haiku. Una solicitud compleja de varios pasos, a GPT-4o o Claude Sonnet. Las tareas que exigen razonamiento muy preciso o un trabajo delicado con código se envían a los modelos de gama alta.
La integración es mínima: ClawRouter es compatible con el formato de la API de OpenAI, así que basta con cambiar la URL base en el código de la aplicación. No hace falta tocar la lógica. Admite OpenAI, Anthropic, Google y otros proveedores.
Como ventajas, el enrutamiento es predecible y unos registros detallados explican por qué una solicitud concreta fue a un modelo u otro, lo que ayuda a entender y mejorar la clasificación. Las reglas se ajustan con flexibilidad a cada proyecto y tipo de tarea.
Como limitaciones, los casos límite a veces se clasifican mal: el router subestima la complejidad de la tarea y la manda a un modelo más barato, lo que reduce la calidad de la respuesta. Estas situaciones requieren ajustar a mano los umbrales.
Entre las alternativas hay varias herramientas maduras. LiteLLM ofrece amplias capacidades de gestión de varios proveedores, balanceo de carga, lógica de fallback y analítica detallada, pero su curva de entrada es más alta. RouteLLM, de Lmarena, usa un clasificador entrenado con datos reales. OpenRouter es una opción en la nube que evita desplegar infraestructura propia. Cada solución implica sus propios equilibrios entre complejidad de configuración, nivel de control y coste de la capa de enrutamiento.
La conclusión clave: las cargas de trabajo reales son heterogéneas. La solicitud «diseña la arquitectura de un sistema distribuido» y la solicitud «corrige una errata en el texto» requieren recursos radicalmente distintos, pero sin enrutamiento ambas las procesa el mismo modelo caro. El enrutamiento inteligente elimina ese desequilibrio de forma automática, sin cambios en la lógica de la aplicación y sin pérdida de calidad en las tareas complejas.
Para desarrolladores individuales y equipos pequeños que gastan 50 dólares al mes o más en APIs de LLM, herramientas como ClawRouter se amortizan en la primera semana. En cargas mayores, el ahorro puede ser aún más significativo.
- 2 nov 2026TJ Digital: el 23% de las páginas que cita la IA empiezan con una respuesta directa, frente al 14% de las que no cita
- 2 nov 2026Arca encarga a agentes de IA tareas financieras de hasta 10 días y deja las operaciones en manos de personas
- 2 nov 2026El asistente Muse de Meta mantiene dosieres de las personas cercanas y obtiene root en Ubuntu por defecto
- 1 nov 2026Los modelos locales pierden ante Opus y Codex: 0,21 puntos en un MacBook frente a 1,00 de Codex
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.