Por qué los agentes de IA fracasan en producción: de qué se compone un sistema LLM maduro en una empresa
Los agentes de IA resultan convincentes en las demos, pero fallan con regularidad en producción. La causa no está en el modelo: un LLM desnudo aporta por sí solo muy poco valor al negocio. El valor real aparece solo cuando hay un contexto correcto, métricas de calidad, restricciones, integraciones seguras y un papel del humano en el ciclo claramente definido. El autor analiza de qué se compone un sistema LLM maduro y por qué el futuro no pertenece al «modelo más inteligente», sino al más controlable.
Procesado por IA desde Habr AI; editado por Hamidun News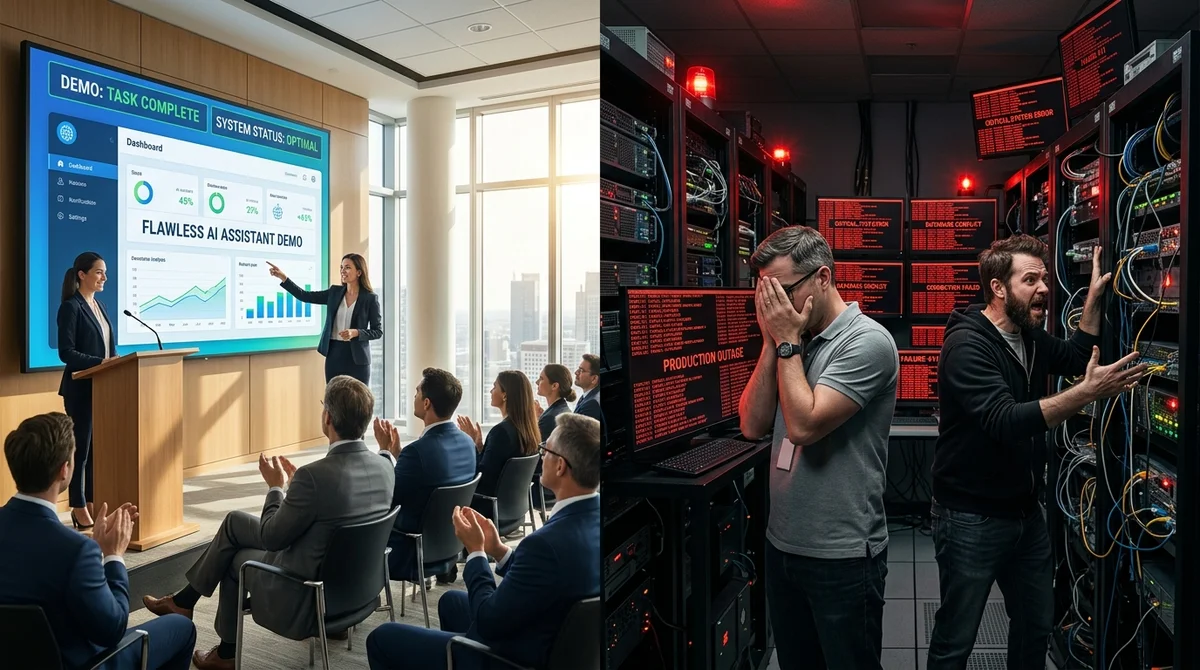
Un agente de IA puede causar buena impresión en una demo: respuestas seguras, instrucciones cumplidas y ningún error grave a la vista. Pero en cuanto entra en un proceso de negocio real, el panorama cambia: el agente se confunde con el contexto, da respuestas irrelevantes, «alucina» hechos y no sabe manejar los casos límite.
La brecha entre la demo y producción es uno de los problemas más dolorosos para los equipos que intentan implantar IA en la empresa. La causa de esa brecha casi nunca está en el modelo. Un LLM por sí solo es una herramienta potente, pero ciega: no conoce el contexto del negocio, ni las restricciones de la compañía, ni lo que ocurrió hace una hora en los sistemas relacionados.
La demo funciona porque alguien seleccionó de antemano el contexto correcto y los datos necesarios, y formuló la consulta con cuidado. En la realidad no existe esa configuración manual, y el modelo trabaja a ciegas.
Un sistema LLM maduro en una empresa es un ensamblaje de varios componentes obligatorios, y cada uno es crítico.
El primero es el contexto: datos relevantes, documentos, historial de interacciones y políticas de la empresa que el modelo recibe en el momento de la consulta mediante RAG o inyección directa. Sin ello, incluso el modelo más avanzado responderá fuera de lugar.
El segundo son las métricas de calidad: sin mediciones no se puede saber si las cosas mejoraron tras un cambio de prompt o una actualización del modelo. Los equipos que no miden trabajan a ciegas.
El tercero son las restricciones y las barreras de protección (guardrails): el modelo debe saber qué no puede hacer, qué tono es admisible y qué datos no puede enviar al exterior.
El cuarto son las integraciones seguras: conexión con API internas y bases de datos con los niveles de acceso adecuados y con registro de cada llamada.
El quinto, el más infravalorado, es un papel del humano en el proceso claramente definido: saber en qué casos el agente actúa de forma autónoma y en cuáles hace falta una revisión manual o una confirmación.
Muchos equipos omiten uno o varios de estos componentes, y casi siempre se nota precisamente en producción, porque en la demo simplemente no hacen falta. La demo es un escenario optimista, con datos seleccionados de antemano y consultas claras. Producción significa usuarios caóticos, datos sucios y no estructurados, combinaciones imprevistas de consultas y situaciones que los desarrolladores no incluyeron en los casos de prueba. Ahí es donde se rompen los sistemas que carecen de estructura interna y de mecanismos de protección.
Un asunto aparte, y a menudo ignorado, es la monitorización y la capacidad de control. La mayoría de los equipos de ingeniería sabe monitorizar código convencional: métricas, logs, alertas por umbral. Con los sistemas LLM es mucho más difícil, porque la «corrección» de una respuesta es algo subjetivo y dependiente del contexto. Aquí ayudan los conjuntos de evaluación (evals): ejemplos seleccionados con un resultado esperado conocido, la comparación automática con respuestas de referencia y LLM-jueces independientes que evalúan la calidad de las respuestas del sistema principal según criterios definidos. Todo esto es infraestructura que hay que construir de forma deliberada, en lugar de esperar que el modelo «se las arregle solo».
Otro aspecto infravalorado es el control de versiones y la gestión de cambios. En el desarrollo convencional existen git, CI/CD y pruebas antes del despliegue. En los sistemas LLM hay que versionar los prompts, las plantillas de contexto, las configuraciones de RAG y los índices vectoriales. Cambiar un prompt es, en la práctica, un release, y hay que tratarlo como tal: con pruebas sobre datos reales, auditoría del impacto en el comportamiento del sistema y posibilidad de rollback. Sin esto, cada «mejora» puede convertirse en fuente de regresiones impredecibles.
El futuro de la IA corporativa no pertenece a la empresa que implante primero el modelo más potente. Pertenece a la que construya el sistema de IA más controlable, medible y seguro. Los modelos se abaratan cada trimestre y ya son una commodity. La ventaja competitiva está en cómo la empresa sabe integrarlos en sus procesos, controlar la calidad y escalar sin perder fiabilidad.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.