Cómo montar el pipeline Netflix Void para eliminar objetos de vídeo con CogVideoX
Una nueva guía muestra cómo montar un pipeline de Void para eliminar objetos de vídeo sobre CogVideoX. Cubre la configuración del entorno, la descarga del modelo base y del checkpoint, la preparación de sample inputs y la ejecución de toda la cadena de inferencia con prompts personalizados. Para los equipos de posproducción de vídeo, lo relevante es que no se trata de una demo, sino de un flujo de trabajo reproducible en local.
Procesado por IA desde MarkTechPost; editado por Hamidun News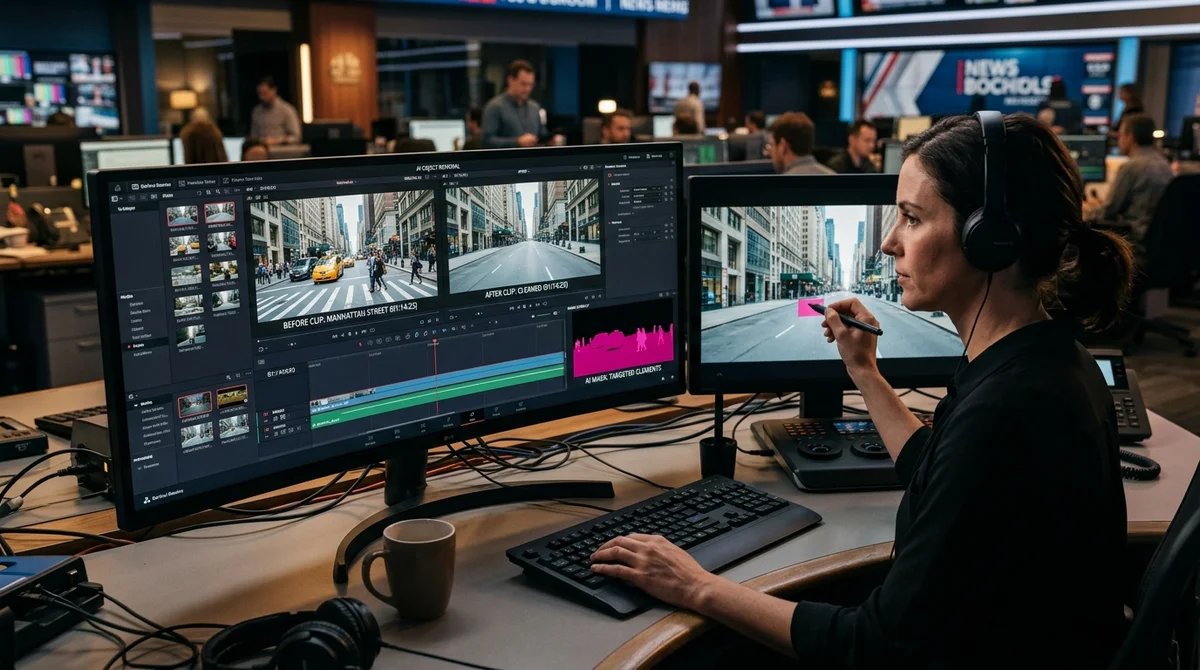
Una nueva guía muestra en detalle cómo montar un pipeline funcional para eliminar objetos de vídeo con el modelo Void de Netflix: desde instalar las dependencias y descargar los pesos hasta ejecutar la cadena completa de inferencia con prompts personalizados y ejemplos listos. Para los equipos de posproducción, montaje generativo y edición de vídeo, lo importante no es la demostración de calidad, sino un proceso reproducible que se puede levantar en local, probar con datos de prueba y adaptar a la propia producción.
El centro del material es el modelo Void, pensado para tareas de video object removal e inpainting: eliminar objetos no deseados del encuadre y reconstruir después el fondo y el movimiento para que el resultado resulte natural de un fotograma a otro. En estos escenarios no basta con restaurar un solo fotograma: si el fondo tiembla, las texturas flotan y la iluminación cambia a saltos, el espectador percibe enseguida la intervención. Por eso la guía combina CogVideoX con un checkpoint específico. El modelo de vídeo base se encarga de la dinámica general de la escena, mientras que el ajuste especializado ayuda a resolver con más precisión la edición local sin destruir el resto del vídeo.
Desde el punto de vista práctico, es una guía de ingeniería completa. Primero se prepara el entorno, se instalan todas las dependencias necesarias y se clona el repositorio. Después hay que descargar el modelo base oficial y el checkpoint de Void, y preparar los sample inputs para una ejecución de prueba: el vídeo original, una máscara u otros artefactos de entrada que indiquen qué objeto debe eliminarse.
Este orden importa de verdad, no solo por formalismo. En la inferencia de vídeo, la mayoría de los fallos no surge en la arquitectura del modelo, sino en la unión entre versiones de bibliotecas, estructura de directorios, formatos de archivo, límites de memoria de vídeo y rutas a los pesos mal indicadas.
La guía pone un énfasis especial en los prompts personalizados y en una inferencia de muestra completa de extremo a extremo. Es crítico porque la calidad del vídeo final no depende solo de la máscara, sino de cómo el modelo interpreta la escena tras la edición: qué fondo debe aparecer donde estaba el objeto eliminado, cómo continúa el movimiento de cámara, qué elementos deben conservarse intactos y con cuánto cuidado se restauran los detalles pequeños.
El material destaca también una forma más práctica de interactuar con el pipeline, mediante una introducción segura de parámetros al estilo terminal. Para un equipo de ingeniería, esto supone ejecuciones más predecibles, menos rutina manual y una automatización más cómoda en tareas repetitivas de montaje de vídeo.
El interés por estos sistemas no es casual. El vídeo se ha convertido en un formato clave para el marketing, la formación, los medios y las demostraciones de producto, y con ello ha crecido la demanda de herramientas que quiten rápidamente del encuadre objetos sobrantes, reflejos, logotipos, transeúntes casuales o artefactos técnicos sin retoque manual fotograma a fotograma. Más importante aún, los modelos generativos pasan poco a poco de las demos impresionantes a las herramientas de producción.
En ese contexto no solo importa la calidad de la salida, sino también la repetibilidad del resultado, una instalación clara, una configuración transparente y la posibilidad de integrar la solución en un pipeline de procesamiento de contenido existente. Guías como esta aceleran la adopción más que los anuncios sonoros.
La conclusión principal es que esta guía no muestra una idea de investigación abstracta, sino un esquema de edición de vídeo con IA casi listo para producción. Cuando se describen juntos los pasos de instalación, las dependencias, los pesos, la lógica de ejecución y los ejemplos de prueba, la tecnología se acerca notablemente al uso real. Si el ecosistema en torno a Void y CogVideoX sigue desarrollándose, la barrera de entrada a una eliminación de objetos de vídeo de calidad bajará para estudios, equipos de producto y servicios de montaje automatizado. Para el mercado es una señal clara: el video inpainting pasa cada vez más rápido de función experimental a herramienta de trabajo.
- 2 nov 2026Cosmos generó vídeo de entrenamiento para drones: el mAP@50–95 del detector subió un 10,3%
- 2 nov 2026Karpathy montó en dos horas un clon de YouTube con 6454 vídeos recomendados en Hacker News
- 2 nov 2026Karpathy usó Claude para crear HackerTube, con 6454 vídeos recomendados en Hacker News
- 2 nov 2026Un periodista de The Verge construye con Claude Code un equivalente del Meta Muse Charm por 50 dólares
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.