MarkTechPost desglosa el ciclo completo de entrenamiento de los grandes modelos de lenguaje, de los datos al despliegue
Un LLM moderno no es una gran ejecución de entrenamiento, sino un largo pipeline: preentrenamiento, SFT, LoRA/QLoRA, RLHF, optimización del razonamiento y despliegue. El análisis de MarkTechPost muestra que las capacidades básicas del modelo surgen al trabajar con datos en bruto, mientras que su utilidad real llega después, cuando se ajusta a una tarea, se alinea con las expectativas humanas y se prepara para funcionar bajo carga. La conclusión principal es que la calidad de un LLM depende de una cadena de decisiones a lo largo de todo el recorrido, no de una única etapa secreta.
Procesado por IA desde MarkTechPost; editado por Hamidun News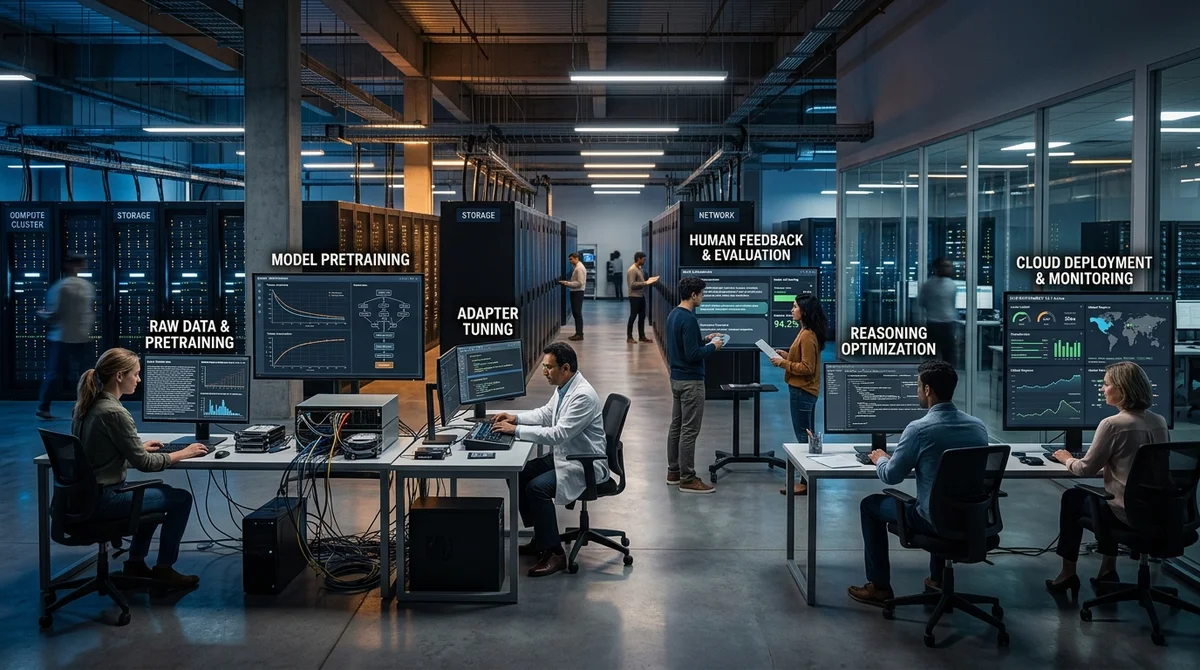
Un gran modelo de lenguaje no nace en una sola pasada por los datos: es una larga cadena de ingeniería en la que un error en cualquier etapa afecta a la calidad, la seguridad y el coste de operación. El análisis técnico de MarkTechPost describe el recorrido completo de un LLM moderno, del preentrenamiento al despliegue en producción, y explica por qué dos modelos de tamaño similar pueden comportarse de forma muy distinta. La diferencia no la crea solo la arquitectura, sino la calidad de todo el pipeline: datos, ajuste del comportamiento, alineación e infraestructura.
La primera etapa es el preentrenamiento. Aquí el modelo recibe enormes volúmenes de datos en bruto: libros, sitios web, documentación, código y otros corpus de texto. No se le enseña una tarea de negocio concreta; en cambio, asimila patrones generales del lenguaje, relaciones entre conceptos, la estructura de la argumentación y patrones básicos de razonamiento. Los objetivos típicos son la predicción del siguiente token o la reconstrucción de huecos. En esencia, el preentrenamiento convierte una red neuronal inicializada al azar en un sistema capaz de continuar un texto con sentido y mantener el contexto. Si esta base es débil, ninguna mejora posterior dará un resultado realmente sólido.
Después llega el ajuste fino supervisado, o SFT. Al modelo ya no se le alimenta con una masa de texto sin más, sino que se lo entrena con pares «entrada-salida» etiquetados. Esto permite adaptarlo a instrucciones concretas, al estilo de respuesta, al tono de comunicación y a las normas de un sector.
La diferencia se ve bien con un ejemplo sencillo: un modelo base puede responder a la queja de un usuario de forma seca y breve, y tras el SFT dar una respuesta estructurada, cortés y útil, con pasos claros. En esta etapa se incorporan al modelo la experiencia en un dominio, los requisitos de la empresa y el formato de comunicación deseado. Es decir, el preentrenamiento responde a la pregunta de qué sabe hacer el modelo en general, y el SFT, a cómo debe comportarse exactamente en un escenario aplicado.
Pero el reentrenamiento completo de modelos grandes es demasiado caro, así que en la práctica se usan métodos de adaptación económicos. MarkTechPost destaca LoRA y QLoRA. En LoRA, los pesos base del modelo se congelan y el entrenamiento se realiza solo a través de pequeñas matrices de bajo rango insertadas en determinadas capas.
Esto reduce de forma drástica el número de parámetros entrenables, el uso de memoria y el tiempo de entrenamiento. QLoRA va más allá: combina el mismo enfoque con la cuantización del modelo base, por ejemplo a 4 bits, de modo que se pueden adaptar incluso modelos muy grandes sin exigencias excesivas de infraestructura. El sentido práctico es simple: ya no hace falta que una empresa recurra a un reentrenamiento completo para cada tarea nueva.
Puede tomar una base sólida y ajustarla a un coste relativamente bajo para abogados, soporte, analistas o un asistente interno.
Después entra en juego la alineación. Aunque el modelo sepa mucho y siga bien las instrucciones, aún puede responder de forma demasiado brusca, insegura o simplemente distinta de lo que espera el usuario. Para ello se aplica RLHF, aprendizaje por refuerzo a partir de retroalimentación humana. Las personas comparan varias respuestas del modelo y las ordenan; con ese material se entrena un modelo de recompensa, y después el propio LLM se optimiza para generar con más frecuencia las variantes preferidas.
El texto menciona también GRPO, un enfoque más reciente orientado a mejorar el razonamiento y las soluciones de varios pasos. El modelo genera varias respuestas a una misma consulta y el entrenamiento se basa no en una puntuación absoluta de cada respuesta, sino en la comparación dentro del grupo. Este mecanismo es especialmente útil cuando importa no solo la respuesta final, sino la calidad del razonamiento: matemáticas, problemas lógicos, explicaciones paso a paso.
La etapa final es el despliegue, y es aquí donde un modelo de investigación se convierte en producto. En producción ya no importan por sí solos la pérdida ni la calidad del dataset, sino la latencia, el coste de inferencia, el rendimiento, el uso de GPU y la estabilidad bajo carga real. Por eso los modelos se optimizan además: se cuantizan, se ejecutan con motores de inferencia especializados como vLLM, TensorRT-LLM o SGLang, se envuelven en una API y se alojan en la nube o en un entorno autoalojado cuando importan el control de los datos y la economía.
Encima se construye la observabilidad: monitorización de latencia, rendimiento y consumo de memoria, y escalado automático. Sin ello, incluso un modelo potente se convierte rápido en un servicio caro e inestable.
La conclusión principal del análisis de MarkTechPost es que la calidad de un LLM no la determina una etapa «secreta», sino el conjunto de decisiones a lo largo de todo el recorrido. El preentrenamiento aporta la inteligencia en bruto, el SFT hace útil al modelo para una tarea concreta, LoRA y QLoRA abaratan la adaptación, RLHF y GRPO pulen el comportamiento y la lógica, y el despliegue decide si todo el sistema puede funcionar en vivo, con rapidez y de forma predecible. Para el mercado es una señal importante: la competencia entre productos de IA se desplaza cada vez más del tamaño del modelo en sí a la calidad del entorno de ingeniería que lo rodea.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.