AWS muestra cómo abaratar la búsqueda semántica de vídeo con Amazon Nova en Bedrock
AWS ha explicado cómo trasladar la lógica de enrutamiento semántico de un sistema de búsqueda de vídeo desde Amazon Nova Premier a la más compacta Nova Micro mediante la destilación de modelos en Bedrock. Según la compañía, este enfoque reduce el coste de inferencia en más de un 95% y la latencia en un 50%. AWS afirma que se mantiene la calidad necesaria para entender con precisión las consultas de los usuarios y enrutar correctamente las búsquedas.
Procesado por IA desde AWS Machine Learning Blog; editado por Hamidun News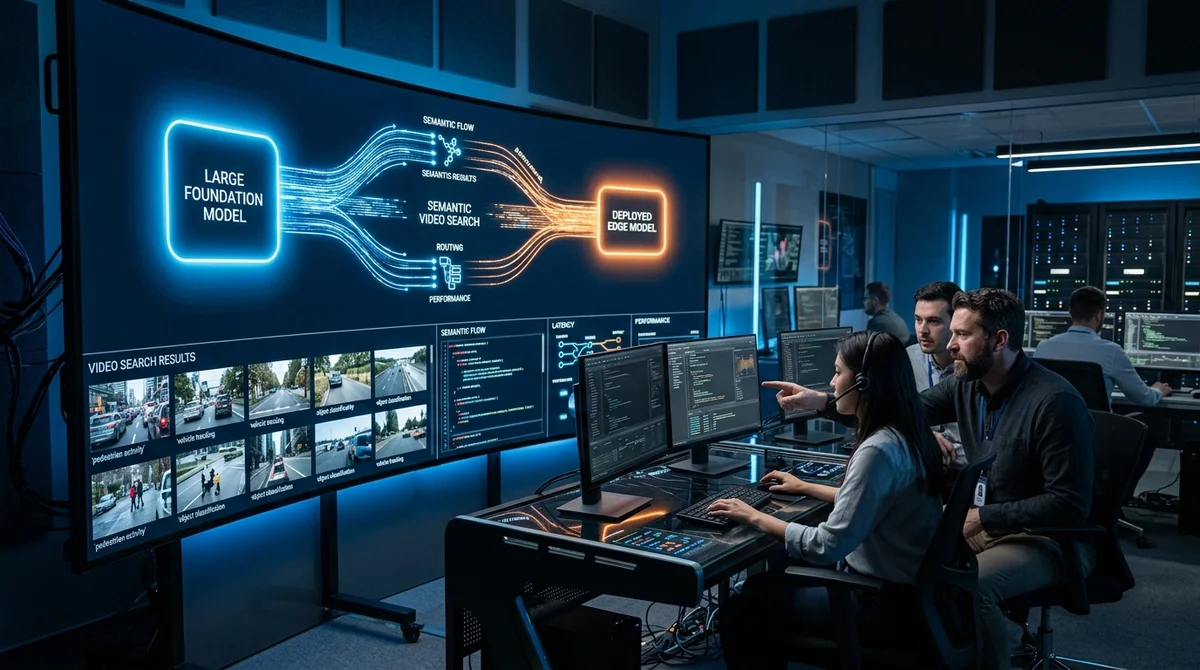
AWS ha mostrado una forma práctica de abaratar y acelerar de manera drástica la búsqueda semántica de vídeo sin una pérdida apreciable de calidad. La compañía propone usar la destilación de modelos en Amazon Bedrock para trasladar la «inteligencia de enrutamiento» de la gran Amazon Nova Premier a la compacta Amazon Nova Micro. El resultado: el coste de inferencia baja más de un 95% y la latencia, aproximadamente un 50%.
La tarea solo parece sencilla en la superficie. La búsqueda semántica de vídeo debe entender no solo las palabras sueltas de la consulta, sino la intención del usuario: si busca un episodio concreto, un tema, un objeto en el plano, un momento emotivo o un fragmento con una acción determinada. Los modelos grandes se adaptan mejor a este enrutamiento de consultas, porque captan los matices con más precisión. Pero en producción esto se convierte rápidamente en un equilibrio entre calidad, velocidad de respuesta y coste de cada consulta, sobre todo si el servicio gestiona un catálogo de vídeo extenso y un gran volumen de peticiones.
AWS propone resolver ese dilema con Model Distillation en Amazon Bedrock. El esquema es estándar en el ML actual, pero aquí se muestra en un caso bastante aplicado. El modelo maestro, Amazon Nova Premier, demuestra primero cómo interpretar las consultas y elegir la vía de procesamiento correcta, y después esos patrones de comportamiento se transfieren al modelo más pequeño, Amazon Nova Micro. La idea es conservar no la coincidencia literal de las respuestas, sino la lógica fina de toma de decisiones que influye en la relevancia de los resultados.
Para las empresas, este matiz es importante. En muchos sistemas el punto débil no es la generación de texto en sí, sino la fase de clasificación y orquestación, en la que el modelo debe entender rápidamente qué quiere el usuario y qué pipeline lanzar después. Si se mantiene siempre un modelo grande en el circuito para esta tarea, los gastos crecen demasiado rápido. Si se pasa directamente a un modelo pequeño sin entrenamiento, la calidad del enrutamiento puede resentirse. La destilación permite tomar las fortalezas de un modelo grande y empaquetarlas en un circuito de servicio más barato.
Las cifras declaradas resultan especialmente relevantes para los equipos que calculan la economía a escala. Una reducción del coste de inferencia de más del 95% hace que los escenarios con consultas frecuentes sobre vídeo, mediatecas, plataformas educativas, archivos de emisiones y bibliotecas corporativas internas sean claramente más realistas en términos de presupuesto. Al mismo tiempo, la reducción de la latencia del 50% importa para la experiencia de usuario: en la búsqueda de vídeo, los segundos de más resultan especialmente molestos, porque la persona espera una navegación casi instantánea por un gran volumen de contenido, no una larga espera antes de ver resultados.
Otro punto importante es que AWS no promociona solo un modelo, sino un patrón de desarrollo en Bedrock. Para las empresas, es una señal de que la personalización de modelos base va dejando de ser una rareza de los equipos de investigación y se convierte en una herramienta de trabajo de los ingenieros de producto. En lugar de elegir entre «muy inteligente o barato», aparece un camino intermedio: usar el modelo grande como portador de la experiencia y luego trasladarla a modelos compactos para una tarea concreta. En la semántica de vídeo esto resulta especialmente lógico, porque las consultas de los usuarios repiten las mismas clases de intención y, por tanto, estas habilidades se transfieren bien.
La conclusión es sencilla: AWS muestra cómo convertir un costoso enrutamiento inteligente en un servicio más masivo y económicamente sostenible. Si el enfoque realmente mantiene la calidad a un nivel suficiente para producción real, los equipos disponen de una receta práctica para la búsqueda de vídeo con IA: entrenar la lógica en un modelo potente y servir el tráfico con uno pequeño y rápido.
- 31 oct 2026Worldwide Express encargó las facturas en disputa a agentes de IA y redujo su deuda un 75%
- 30 oct 2026AWS ofrece a los agentes de código una vista previa en vivo del sitio desde la sesión aislada
- 30 oct 2026MoEngage abre 400 API cerradas a agentes de IA con AgentCore Gateway, sin servidores MCP propios
- 29 oct 2026NVIDIA Nemotron 3.5 Super VL: 120 mil millones de parámetros, 12 mil millones activos, despliegue en AWS
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.