Meta presenta Sapiens2, un único modelo de visión para pose, segmentación y 3D
Meta ha lanzado Sapiens2, una nueva familia de modelos de visión de alta resolución para tareas centradas en el ser humano. Una única arquitectura cubre la estimación de pose, la segmentación de partes del cuerpo, las surface normals, el pointmap y el albedo. La gama escala de 0,4 a 5.000 millones de parámetros, se entrenó con 1.000 millones de imágenes de personas y, según la compañía, supera de forma notable en precisión a la primera generación de Sapiens. *Meta ha sido declarada organización extremista y está prohibida en Rusia.
Procesado por IA desde MarkTechPost; editado por Hamidun News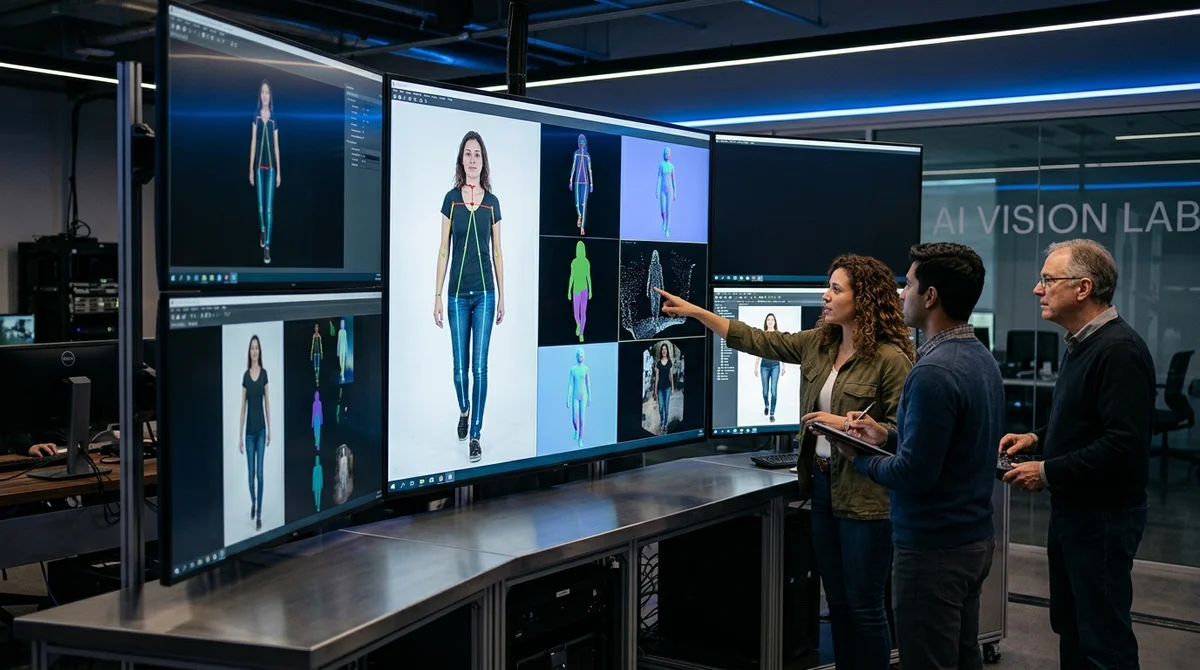
Meta Reality Labs ha lanzado Sapiens2, una nueva generación de modelos de visión centrados en el ser humano que intenta sustituir un conjunto disperso de redes especializadas por una única base común. En una sola gama, la compañía reúne tareas que normalmente van por separado: estimación de la pose humana, segmentación de partes del cuerpo, recuperación de normales de superficie, pointmap para geometría 3D y estimación de albedo. Para el mercado es una señal importante: Meta sigue apostando no solo por la IA generativa, sino también por la visión por computador aplicada, necesaria para dispositivos de RA, avatares digitales, probadores virtuales, motion capture y análisis de vídeo.
La idea central de Sapiens2 es que una arquitectura base puede trabajar a la vez en varios niveles de comprensión de una persona en la imagen. Ya no hace falta una red para el esqueleto, otra para el etiquetado del cuerpo y una tercera para la geometría de la superficie. Meta afirma que un único backbone cubre todos estos escenarios tras el ajuste fino.
En términos prácticos, esto simplifica el pipeline de producción: menos componentes, menos desincronización entre modelos y menores costes de mantenimiento. Entre los checkpoints publicados hay, en particular, un modelo de estimación de pose top-down con 308 puntos clave, que incluye puntos detallados de rostro, manos y pies, así como segmentación en 29 clases de partes del cuerpo. La actualización clave no está solo en el conjunto de tareas, sino también en cómo se entrenó el modelo.
Sapiens2 se preentrenó con un conjunto de datos curado de 1.000 millones de imágenes de personas de alta calidad. En el preentrenamiento, Meta combinó la reconstrucción de imágenes enmascaradas con un objetivo contrastivo autodestilado, para que el modelo conserve a la vez los detalles de bajo nivel para la predicción densa y la semántica de alto nivel para escenarios zero-shot y con pocas etiquetas.
En la arquitectura también se emplearon técnicas de modelos frontier más recientes para soportar ciclos de entrenamiento más largos sin perder estabilidad. La gama escala de 0,4 a 5.000 millones de parámetros, trabaja en resolución nativa de 1K, y las variantes jerárquicas admiten 4K y usan windowed attention para un contexto espacial más largo.
Frente a la primera generación de Sapiens, Meta asegura una mejora notable en casi todas las métricas clave. En estimación de pose, la nueva versión suma 4 puntos de mAP; en segmentación de partes del cuerpo, 24,3 puntos de mIoU; y en surface normals reduce el error angular un 45,6 %. También es relevante que Sapiens2 va más allá de las tareas habituales del primer lanzamiento.
Ahora la familia puede construir un pointmap, es decir, predecir para cada píxel las coordenadas 3D en el sistema de la cámara, y trabajar con albedo, el color base de la superficie sin influencia de la iluminación. Para avatares, RA y probadores digitales esto es especialmente útil: estas representaciones ayudan a reconstruir con más precisión la forma de la persona, transferir la iluminación y construir escenas 3D más verosímiles a partir de una foto normal. El valor práctico del lanzamiento es que Meta no se ha limitado a una publicación de investigación.
La compañía ya ha publicado la familia Sapiens2 en Hugging Face y el código en GitHub, y la colección incluye variantes independientes para pose, segmentación, normals y pointmap. Esto reduce la barrera de entrada para los equipos que construyen productos de visión por computador centrada en personas, desde apps de fitness y sistemas de videoanálisis hasta interfaces XR y personajes virtuales. Conviene recordar, eso sí, que Sapiens2 no es un modelo universal para cualquier tarea de visión, sino un stack sólido específicamente para imágenes centradas en el ser humano.
Es decir, su punto fuerte son los encuadres en los que la persona sigue siendo el objeto central, con su pose, superficie, ropa y geometría corporal. Qué significa en la práctica: Meta da un paso más hacia un backbone visual unificado para todo lo relacionado con una persona en la imagen. Si los resultados declarados se confirman en escenarios reales de producción, la compañía tendrá una base sólida para sus propios productos XR y fijará un nuevo listón para la investigación abierta en visión centrada en personas.
Para el mercado, es un buen ejemplo de cómo los foundation models empiezan a rendir no solo en texto y generación, sino también en tareas precisas y de ingeniería de visión por computador.
*Meta ha sido declarada organización extremista y está prohibida en Rusia.
- 2 nov 2026El asistente Muse de Meta mantiene dosieres de las personas cercanas y obtiene root en Ubuntu por defecto
- 2 nov 2026Un periodista de The Verge construye con Claude Code un equivalente del Meta Muse Charm por 50 dólares
- 1 nov 2026La capa de seguridad MoneyGate frenó las 42 peticiones fraudulentas a IA locales
- 31 oct 2026KTMS 1.0, el gateway LLM open source, conecta GPU propias a la nube y resiste fallos de dependencias
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.