GPT-5.2 supera a los aspirantes de este año en las pruebas de acceso de la Universidad de Tokio y la Universidad de Kioto
GPT-5.2 en modo de razonamiento obtuvo el mejor resultado en ejercicios de los exámenes de acceso de la Universidad de Tokio y la Universidad de Kioto. En la prueba de LifePrompt, el modelo superó a los aspirantes de este año e incluso las puntuaciones máximas de admisión en los programas de medicina más competitivos. El resultado importa más allá del récord: muestra que los modelos de razonamiento potentes ya superan con solvencia filtros académicos que hasta hace poco se consideraban exclusivamente humanos.
Procesado por IA desde 3DNews AI; editado por Hamidun News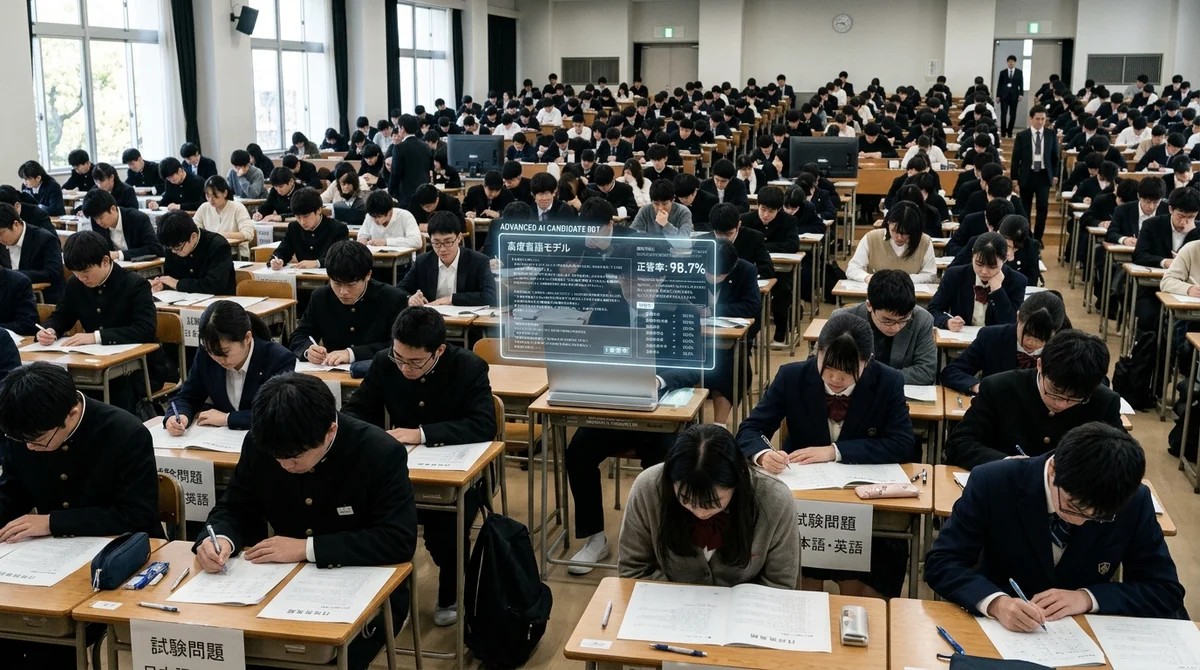
GPT-5.2 ha alcanzado otro hito que durante mucho tiempo se consideró territorio humano: en una prueba con ejercicios de los exámenes de acceso de la Universidad de Tokio y la Universidad de Kioto, el modelo obtuvo un resultado superior al de los aspirantes de este año. Y no se trata solo de superar un umbral: según LifePrompt, el sistema en modo de razonamiento alcanzó un nivel que supera incluso las puntuaciones de admisión más altas en varios programas, incluida la medicina.
Las pruebas las realizó LifePrompt, que comparó las respuestas del modelo con los ejercicios de examen actuales y los resultados del proceso de admisión real. Es importante subrayar que no se trata de una participación oficial de la red neuronal en las admisiones japonesas ni de una historia sobre una matrícula universitaria: es más bien una prueba de estrés de las capacidades académicas del modelo en un entorno extremadamente competitivo. Pero ese formato es precisamente lo valioso: permite evaluar no un benchmark abstracto, sino cómo resuelve la IA tareas complejas con las que se descarta a los candidatos más fuertes.
La elección del escenario tampoco es casual. La Universidad de Tokio y la Universidad de Kioto son las dos universidades más prestigiosas y selectivas de Japón, y los programas de medicina figuran tradicionalmente entre los más difíciles de acceder. Si el modelo realmente supera el techo de las puntuaciones de admisión en esos programas, eso significa algo más que buena erudición. Es señal de una capacidad sólida para trabajar con tareas que exigen lógica, largas cadenas de razonamiento, cálculos precisos y la habilidad de no perder el contexto entre varias condiciones.
Según la descripción de la prueba, el modo de razonamiento desempeñó el papel clave. En él, el modelo dedica más tiempo a analizar internamente el problema antes de dar la respuesta final. Para los exámenes de acceso esto es especialmente importante: este tipo de ejercicios suele penalizar no el desconocimiento de un dato, sino un solo eslabón intermedio erróneo.
Por eso, el avance de estos sistemas se parece cada vez menos a «adivinar por estadística» y cada vez más a resolver problemas paso a paso. Al mismo tiempo, esto no elimina las limitaciones: incluso una puntuación sobresaliente en conjuntos de exámenes todavía no demuestra que el modelo sea igual de fiable en un diálogo real, en trabajo de investigación o en decisiones clínicas.
Para la educación, es una señal en varias direcciones a la vez. Primero, los exámenes tipo funcionan cada vez peor como filtro puro de conocimientos si un modelo de razonamiento potente puede superarlos de forma estable mejor que la mayoría de las personas. Segundo, cambia el valor de la propia preparación: pasa a importar menos resolver mecánicamente problemas conocidos y más saber formular preguntas, comprobar pasos intermedios, defender conclusiones y trabajar en tándem con herramientas de IA. Por último, estos resultados empujan a las universidades a revisar sus métodos de evaluación: añadir más componentes orales, trabajo por proyectos y tareas en las que la argumentación propia sea crítica, y no solo la respuesta final en la hoja.
Para el mercado de la IA, es además una muestra de hacia dónde va la competencia entre modelos. Ya no gana el sistema que redacta mejor un texto, sino el que soporta cargas cognitivas largas y mantiene la precisión bajo la presión de condiciones complejas. Los exámenes académicos son útiles precisamente porque el error es costoso y el criterio de éxito está claro. Si un modelo empieza a ganar con solvencia en ese entorno, su potencial se extiende rápidamente más allá de la educación: hacia el análisis, los cálculos de ingeniería, la preparación de certificaciones y otros ámbitos que requieren disciplina de pensamiento.
La conclusión principal es sencilla: el listón de la IA «inteligente» ha vuelto a subir, y la cuestión ya no es si un modelo puede aprobar un examen difícil, sino cómo deben reconstruir las personas y las instituciones las reglas en torno a ese hecho. Por ahora, estas pruebas siguen siendo más una demostración de capacidades que un sustituto de la experiencia real. Pero la brecha entre las tareas académicas para una persona y para un modelo potente sigue reduciéndose rápidamente.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.