Cómo puede un product manager evaluar la calidad de un producto de IA: guía de evals
Los evals, la evaluación de la calidad de un producto de IA, se han convertido de repente en la habilidad clave para los product managers. Altos directivos de Anthropic y OpenAI lo dicen sin rodeos: hace dos años nadie conocía la palabra y hoy es una competencia obligatoria. En el pódcast de Lenny Rachitsky, los investigadores Hamel Husain y Shreya Shankar desglosaron el proceso paso a paso: desde definir los criterios de éxito y armar un «conjunto dorado» de ejemplos hasta construir un pipeline de evaluación automático.
Procesado por IA desde Habr AI; editado por Hamidun News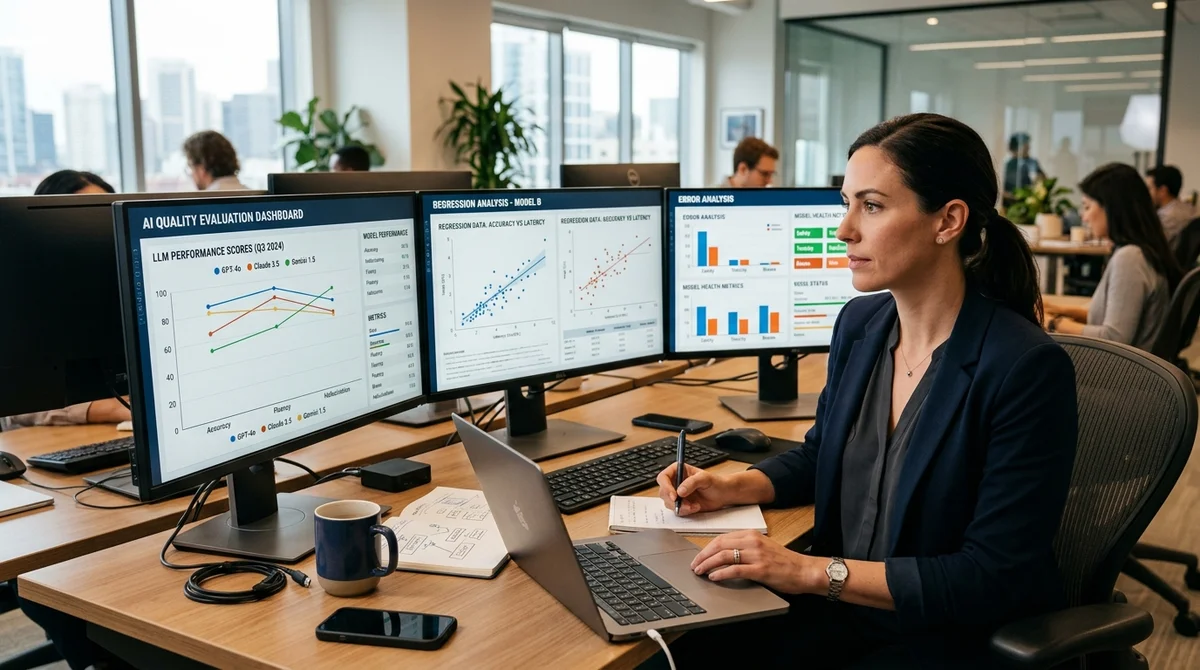
Los evals, la evaluación de la calidad de un producto basado en LLM, se han convertido de repente en la habilidad más comentada entre los product managers de las empresas de IA. Altos directivos de Anthropic y OpenAI afirman abiertamente que saber construir sistemas de evaluación es una competencia clave para cualquier product manager que trabaje con modelos de lenguaje. En el pódcast de Lenny Rachitsky, los investigadores Hamel Husain y Shreya Shankar explicaron cómo debe abordar un PM la evaluación de un producto de IA y por qué aquí la intuición no funciona.
Qué es un eval y para qué sirve
Un eval es una comprobación sistemática de lo bien que un modelo de lenguaje resuelve una tarea concreta en el contexto concreto de tu producto. A diferencia del testing de software clásico, donde la respuesta es correcta o no lo es, en los productos con LLM la respuesta casi siempre se sitúa en un punto intermedio. Una misma consulta puede generar decenas de respuestas distintas pero igualmente aceptables, y la tarea del PM es entender cuál es la mejor para un usuario concreto en una situación concreta.
La mayoría de los equipos empieza evaluando los modelos de forma subjetiva: miran unos cuantos ejemplos y sacan una conclusión. Eso funciona para funciones sencillas, pero se rompe por completo al escalar. Cuando un producto recibe un millón de solicitudes al día, la revisión manual es imposible: hace falta un sistema que funcione de forma automática y reproducible.
Tres niveles de evaluación de un producto de IA
Los expertos proponen construir los evals en tres capas sucesivas.
La primera es definir los criterios de éxito. Antes de medir nada, el PM debe responder a una pregunta: ¿qué significa una «buena respuesta» para nuestro producto? Puede ser la exactitud de los hechos, la coherencia con el tono de la marca, la longitud, la estructura, la ausencia de toxicidad o la seguridad. Sin este paso, cualquier métrica carece de sentido: se mediría algo distinto de lo que le importa al usuario.
El segundo nivel es armar un «conjunto dorado». Se trata de una colección de consultas de ejemplo con respuestas ideales, creadas a mano o seleccionadas a partir de datos reales. Contra este conjunto se prueba el modelo en cada actualización. La calidad del conjunto dorado determina directamente la calidad de todo el sistema de evaluación, y ahí residen la mayor dificultad y la mayor responsabilidad del PM.
El tercer nivel es automatizar la evaluación. En esta etapa el equipo construye un pipeline: una nueva versión del modelo o del prompt se pasa por el conjunto dorado y los resultados se comparan con las referencias, ya sea de forma automática o mediante un modelo juez, es decir, otro LLM que puntúa las respuestas. La regresión se ve de inmediato en las cifras, en lugar de descubrirse en las opiniones de los usuarios una semana después del lanzamiento.
Por qué el PM no puede delegar esto en los ingenieros
La tentación de pasar los evals al equipo técnico es grande, pero es un error. Los evals son decisiones de producto: qué le importa al usuario, qué considera una buena respuesta y qué compromisos estamos dispuestos a asumir por la velocidad o el coste. Un ingeniero no sabe por qué el usuario prefiere una respuesta breve a una extensa, ni por qué un tono «cercano pero profesional» pesa más que una respuesta un tres por ciento más precisa.
Es el PM quien conecta las métricas de los evals con los resultados reales de negocio. Si el modelo es un cinco por ciento más preciso pero la satisfacción de los usuarios no cambia, algo falla en el propio criterio de evaluación. Encontrar y corregir ese desajuste es una tarea de producto, no de ingeniería.
Qué significa para el mercado y las carreras
Hace dos años la palabra «evals» aparecía sobre todo en artículos académicos. Hoy forma parte estándar del roadmap de cualquier producto de IA serio. Las empresas que han aprendido a medir de forma sistemática la calidad de sus soluciones con LLM obtienen una ventaja competitiva duradera: detectan antes las regresiones, comparan con más precisión unos modelos con otros y toman decisiones de actualización basadas en datos, no en las sensaciones subjetivas del equipo.
Para la carrera de un product manager, la conclusión es directa: si trabajas con productos de IA y no sabes construir evals, pierdes frente a los colegas que sí saben. Esta habilidad se ha vuelto tan obligatoria como saber trabajar con el embudo de ventas o realizar pruebas A/B.
- 2 nov 2026El asistente Muse de Meta mantiene dosieres de las personas cercanas y obtiene root en Ubuntu por defecto
- 1 nov 2026Los modelos locales pierden ante Opus y Codex: 0,21 puntos en un MacBook frente a 1,00 de Codex
- 1 nov 2026Kimi logra un 96,2 % en un test de analítica sobre una base de 1C y se perfila como plan B ante un bloqueo de Claude
- 1 nov 2026OpenAI reescribe las reglas de comportamiento de GPT: cinco valores y una cadena de prioridades
Preguntas frecuentes sobre la noticia
¿Qué se sabe sobre Qué es un eval y para qué sirve?
Un eval es una comprobación sistemática de lo bien que un modelo de lenguaje resuelve una tarea concreta en el contexto concreto de tu producto. A diferencia del testing de software clásico, donde la respuesta es correcta o no lo es, en los productos con LLM la respuesta casi siempre se sitúa en un punto intermedio. Una misma consulta puede generar decenas de respuestas distintas pero igualmente aceptables, y la tarea del PM es entender cuál es la mejor para un usuario concreto en una situación concreta. La mayoría de los equipos empieza evaluando los modelos de forma subje
¿Qué se sabe sobre Tres niveles de evaluación de un producto de IA?
Los expertos proponen construir los evals en tres capas sucesivas. La primera es definir los criterios de éxito. Antes de medir nada, el PM debe responder a una pregunta: ¿qué significa una «buena respuesta» para nuestro producto? Puede ser la exactitud de los hechos, la coherencia con el tono de la marca, la longitud, la estructura, la ausencia de toxicidad o la seguridad. Sin este paso, cualquier métrica carece de sentido: se mediría algo distinto de lo que le importa al usuario. El segundo nivel es armar un «conjunto dorado». Se trata de una colección de consultas de eje
¿Qué se sabe sobre Por qué el PM no puede delegar esto en los ingenieros?
La tentación de pasar los evals al equipo técnico es grande, pero es un error. Los evals son decisiones de producto: qué le importa al usuario, qué considera una buena respuesta y qué compromisos estamos dispuestos a asumir por la velocidad o el coste. Un ingeniero no sabe por qué el usuario prefiere una respuesta breve a una extensa, ni por qué un tono «cercano pero profesional» pesa más que una respuesta un tres por ciento más precisa. Es el PM quien conecta las métricas de los evals con los resultados reales de negocio. Si el modelo es un cinco por ciento más preciso per
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.