llm-checker: una utilidad que muestra qué LLM aguanta tu hardware
Ha aparecido llm-checker, una herramienta CLI de código abierto que analiza la configuración de hardware de un ordenador y determina qué modelos de lenguaje se pueden ejecutar en local con Ollama. Escanea la GPU, la memoria RAM y el procesador, y después evalúa la compatibilidad, la velocidad y la calidad de cada uno de más de 35 modelos, desde los compactos de 1000 millones de parámetros hasta los exigentes de 32 000 millones. La lista de modelos se cura a mano, lo que mantiene las recomendaciones al día. La herramienta ataca uno de los grandes quebraderos de cabeza de los aficionados a la IA local: dejar de adivinar y saber con exactitud qué aguanta el hardware que ya tienen.
Procesado por IA desde Habr AI; editado por Hamidun News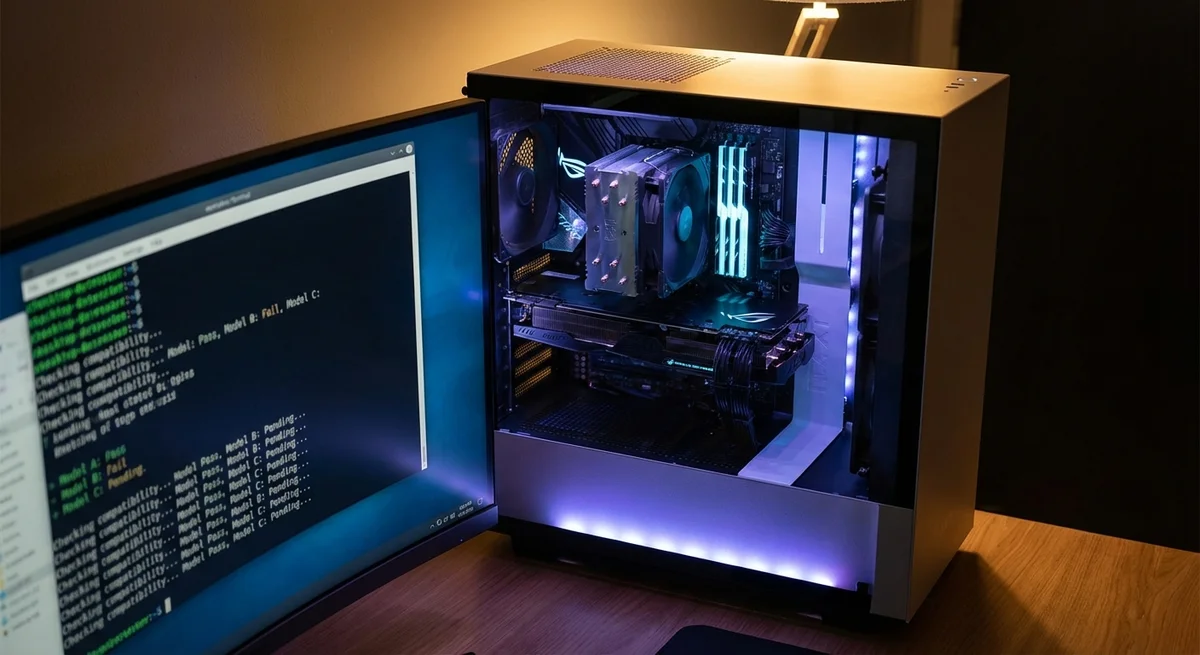
Una de las preguntas más habituales entre quienes ejecutan modelos de lenguaje en local suena engañosamente sencilla: ¿lo aguantará mi hardware? Hasta ahora, la respuesta había que armarla a retazos, con benchmarks dispersos, hilos de Reddit y pruebas propias a base de ensayo y error. Una nueva herramienta de código abierto, llm-checker, intenta resolver la duda con un solo comando en la terminal.
llm-checker es una utilidad CLI que escanea la configuración de hardware del ordenador y ofrece un veredicto concreto: qué modelos de lenguaje del ecosistema Ollama puedes ejecutar, con qué velocidad y con qué calidad. La herramienta analiza tres componentes clave, la tarjeta gráfica, la memoria RAM y el procesador, y con esos datos genera un informe personalizado para más de 35 modelos, desde los compactos de 1000 millones de parámetros hasta los imponentes de 32 000 millones.
Para entender por qué importa, conviene recordar el contexto. En los últimos dos años, el movimiento de ejecutar grandes modelos de lenguaje en local ha pasado de ser un pasatiempo marginal a una corriente de pleno derecho. Ollama se ha convertido en el estándar de facto para quien quiere correr un LLM en su propio ordenador, sin suscripciones en la nube y sin enviar datos a servidores ajenos.
Llama, Mistral, Gemma, Phi, DeepSeek, Qwen: el número de modelos disponibles crece cada mes y cada uno exige un hardware distinto. El problema es que nadie ha sistematizado esos requisitos en función de configuraciones concretas. Quien tiene una RTX 3060 con 12 GB de VRAM y 32 GB de RAM debe averiguar por su cuenta si puede con Llama 3.
1 de 8000 millones de parámetros en cuantización Q4, o si es mejor ni intentarlo.
llm-checker cubre justo ese hueco entre la abundancia de modelos y la opacidad de los requisitos de hardware. La utilidad funciona de forma muy directa: lanzas el comando, consulta el sistema, compara las características con una base de conocimiento interna de modelos y devuelve un resultado. Cada modelo se puntúa en tres ejes: compatibilidad (si arrancará siquiera), velocidad (si la generación de tokens será fluida) y calidad (si habrá que sacrificar precisión a cambio de rendimiento). No son puntuaciones abstractas, sino información útil en la práctica que ahorra horas de experimentos.
Merece atención aparte el enfoque con el que se cura la lista de modelos. Los autores renunciaron a propósito a analizar automáticamente todo el catálogo de Ollama y moderan la lista a mano. Es una decisión deliberada: el catálogo de Ollama contiene cientos de modelos de calidad desigual, entre ellos obsoletos, experimentales y abiertamente inútiles. La curación manual significa que el usuario recibe recomendaciones solo sobre modelos contrastados y actuales que de verdad merece la pena ejecutar. En un mundo donde el número de LLM abiertos se duplica cada pocos meses, un filtro así es una ventaja, no una limitación.
Técnicamente, la herramienta resuelve un problema nada trivial. El rendimiento de un LLM local depende de muchos factores: la cantidad de VRAM determina si el modelo cabe entero en la GPU; la velocidad de la RAM influye en el offloading de las capas que no caben en la VRAM; la arquitectura del procesador importa para los modelos que funcionan en modo CPU. La cuantización añade otra dimensión: el mismo modelo en Q8 puede no caber en memoria, mientras que en Q4 funciona, aunque con una pérdida de calidad apreciable. llm-checker se encarga de todos estos cálculos y los traduce en recomendaciones claras.
En un contexto más amplio, la aparición de herramientas así indica que el ecosistema de la IA local madura. Cuando una tecnología sale del círculo de desarrolladores y aficionados, necesita puentes entre la complejidad y la sencillez. llm-checker es uno de ellos. No hace nada revolucionario desde el punto de vista tecnológico, pero resuelve un problema real de los usuarios que hasta ahora se había ignorado.
Por supuesto, la herramienta tiene limitaciones evidentes. Su dependencia de Ollama deja fuera a quienes usan llama.cpp, vLLM u otros backends. La moderación manual de la lista de modelos es a la vez una fortaleza y una debilidad, porque la actualidad depende de la actividad de los mantenedores. El rendimiento real siempre diferirá de las previsiones, porque lo afectan decenas de variables imposibles de tener en cuenta a distancia, desde la temperatura de la GPU bajo carga hasta los procesos en segundo plano del sistema.
Aun así, llm-checker marca la dirección correcta. A medida que la ejecución local de LLM se vuelve masiva, y todas las tendencias apuntan a ello, la necesidad de herramientas sencillas de diagnóstico y recomendación no hará más que crecer. Hoy es una utilidad CLI para usuarios avanzados. Mañana, una funcionalidad similar bien puede acabar integrada en la propia Ollama o en sus equivalentes. Porque la mejor manera de atraer usuarios a la IA local es eliminar la barrera de la incertidumbre y dar una respuesta honesta a una pregunta simple: qué puedo ejecutar exactamente ahora mismo.
- 2 nov 2026El asistente Muse de Meta mantiene dosieres de las personas cercanas y obtiene root en Ubuntu por defecto
- 2 nov 2026Un periodista de The Verge construye con Claude Code un equivalente del Meta Muse Charm por 50 dólares
- 1 nov 2026La capa de seguridad MoneyGate frenó las 42 peticiones fraudulentas a IA locales
- 31 oct 2026KTMS 1.0, el gateway LLM open source, conecta GPU propias a la nube y resiste fallos de dependencias
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.