Un autor da vida a un cuadro del siglo XIX capa por capa: por cada clip logrado, 4–5 fallidos
Si se le entrega a un modelo de vídeo el cuadro completo, redibujará los rostros, los uniformes y el puente. Por eso el autor separó el cuadro de Alma-Tadema sobre el cruce del Berézina en capas en Photoshop, animó las figuras una por una con MiniMax H3 y montó la escena en After Effects. El precio del control es el tiempo: por cada clip válido había 4–5 fallidos. En escenas complejas, conviene dividir la tarea y revisar cada fragmento.
Procesado por IA desde Habr AI; editado por Hamidun News
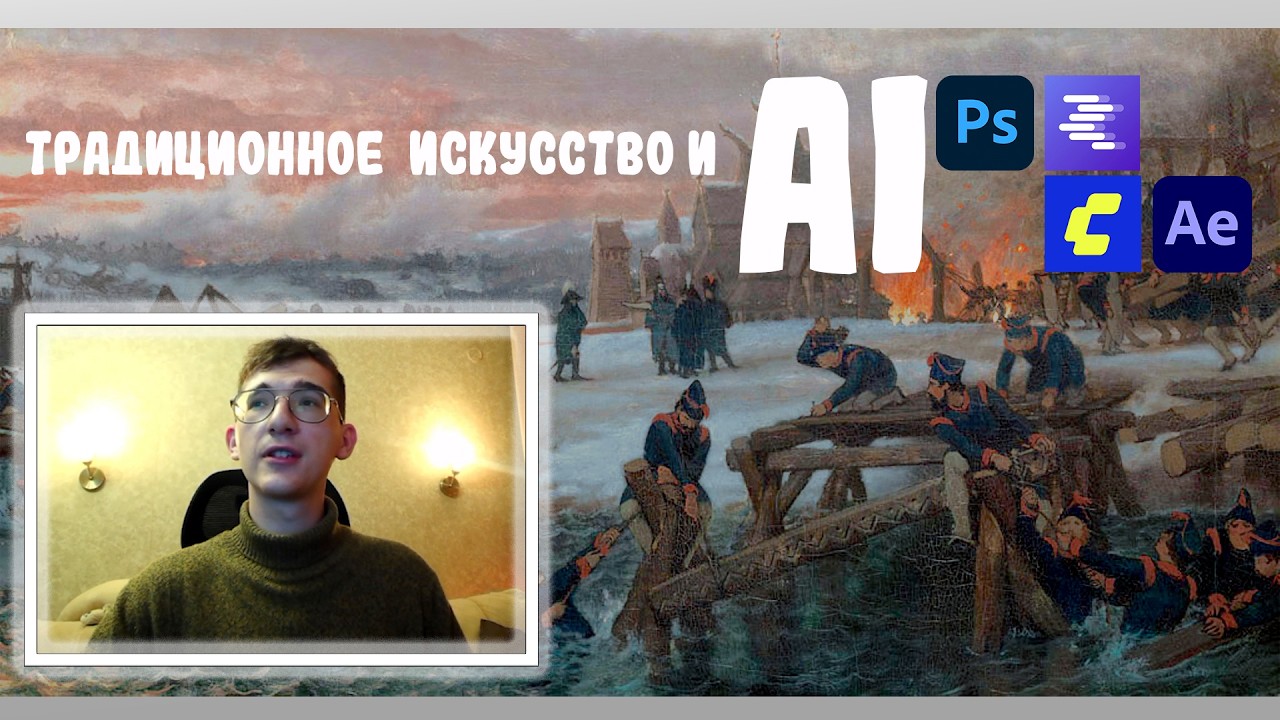
Los generadores de vídeo han aprendido a mover imágenes con gran acierto, pero al enfrentarlos a una escena compleja con decenas de personas, empiezan a inventar por su cuenta: cambian rostros, uniformes, arquitectura e incluso el número de manos. Imagine que pide a un modelo que anime un cuadro histórico y el resultado es que un soldado lleva otra ropa en lugar de su capote, y el puente se construye en dirección contraria. El autor de Habr Dmitrii (canal Dmitrii DAK) esquivó este problema con el ejemplo del cuadro de Lawrence Alma-Tadema «Anno 1812.
Kapitein Benthien aan de Beresina»: en él, pontoneros neerlandeses construyen un cruce sobre el Berézina durante la retirada del ejército de Napoleón. En lugar de una única solicitud de «anima todo», dividió el trabajo en piezas pequeñas y controlables. El precio de ese control es el tiempo: según su observación, por cada clip válido hay 4–5 generaciones fallidas o «casi» válidas.
Se trata de la experiencia de un solo proceso, no de una estadística universal, pero muestra bien dónde se va realmente el esfuerzo.
Primero las capas, luego el movimiento
La primera etapa se realiza en Photoshop. El autor selecciona personajes y objetos, pasa cada uno a una capa separada y agrupa las capas por significado: agua, personas, estructuras. La regla principal: los fragmentos conservan el sistema de coordenadas original del lienzo, sin recortarse al rectángulo mínimo. Así, en After Effects las capas encajan entre sí sin ajustar a mano la escala ni la posición.
Después aparece el problema de los huecos. Si se quita un soldado, detrás deben quedar tablas, el hombro de otra persona, nieve. Estas zonas se rellenan mediante inpainting (repintado del fondo con una red neuronal) de forma que coincidan color, luz, dirección de las pinceladas y perspectiva. En una imagen fija la costura puede pasar desapercibida, pero en movimiento el fondo empieza a «desplazarse» respecto a la figura, por lo que el autor revisa las uniones con especial cuidado.
Un paso aparte son los rostros. En el cuadro muchas figuras son pequeñas, y en la animación un rostro «borroso» delata la sustitución. A los personajes se les aplica una mejora de detalle con la condición de no cambiar la pose, las proporciones ni el carácter pictórico. Además, el fondo detrás de ellos se sustituye por verde: después se elimina en la composición con un cuentagotas, porque detrás hay otros personajes animados.
Un LLM local escribe los prompts, MiniMax H3 mueve los fragmentos
Para no redactar a mano descripciones largas, el autor ejecuta en LM Studio un modelo multimodal local, Qwen 3.8 27B en la cuantización Q5_K_XL (una versión comprimida que cabe en la memoria de vídeo). Se le proporcionan tres cosas: una descripción básica del movimiento deseado, el propio fragmento del cuadro y una lista de restricciones (vestimenta, apariencia, posición de los vecinos, cámara fija). El modelo mira la imagen y genera un prompt detallado en inglés. Por ejemplo: ocho soldados con uniformes oscuros avanzan de izquierda a derecha por la orilla nevada cargando troncos, cámara estática, plano medio con objetivo de 35 mm, textura del lienzo.
El vídeo se genera en ComfyUI con el modelo de vídeo MiniMax H3. Para acelerar, el autor emplea una LoRA de 10 pasos (un pequeño complemento que permite calcular más rápido), SageAttention y el nodo Spectrum. El primer plano se realizó a una resolución de 1,8 megapíxeles (1824×1024), y el resto de planos, a 0,3 megapíxeles (736×416).
El resultado se evalúa no por su belleza, sino por su aptitud para el montaje:
- si se conservó la pose original;
- si no cambió el número de objetos y extremidades;
- si la mano o la pierna de un personaje no atraviesa a otro;
- si el movimiento se ajusta a la física del entorno.
Es precisamente con estos criterios como se acumulan los famosos 4–5 intentos fallidos por cada acierto. La escena con oficiales y troncos tuvo que rehacerse más de 15 veces: un oficial atravesaba a un soldado que reparaba el puente. Las personas en el agua helada hasta la cintura, empujando troncos y sujetándose unas a otras, salían peor que las figuras de la orilla.
Montaje en After Effects y el coste del experimento
En After Effects, las capas y los clips generados se colocan según las coordenadas originales. Para separar las figuras del fondo se usa Roto Brush: el autor comprueba la estabilidad de la máscara, corrige los bordes y revisa por separado la ropa, las manos y los pies, donde los errores se notan más. Al final unifica color y luz para que los fragmentos no desentonen con la pintura general.
El trabajo se realizó en una estación con Intel Core i9-14900K y NVIDIA GeForce RTX 5090 con 32 GB de memoria de vídeo, íntegramente en local. El autor subraya que esa tarjeta gráfica no es imprescindible: las etapas pueden ejecutarse en hardware más modesto, usando versiones simplificadas de los modelos o trasladando la generación a la nube. En ese caso cambiarían la resolución, la velocidad y el conjunto de modelos disponibles.
Qué implica esto en la práctica
El artículo describe la experiencia de un solo autor, no un benchmark reproducible, y esa es su principal limitación. Pero la conclusión es aplicable más allá. Cuanto más compleja es la escena, más conviene dividirla en piezas independientes e incluir a una persona en la revisión de cada paso.
La duración del vídeo final refleja mal el esfuerzo: unos pocos segundos de animación pueden costar decenas de generaciones y retoques manuales. Si se calcula lo mismo en la nube, se trata de tokens o créditos, y conviene presupuestar con margen de 4–5 intentos por cada fragmento. Para instalaciones en museos, exposiciones y proyectos educativos, este flujo de trabajo ofrece algo que una única solicitud al modelo de vídeo no proporciona: la composición original preservada.
- 21 nov 2026MLCommons empieza a medir las API de IA bajo carga real: 7 mediciones para agentes
- 21 nov 2026Unsloth actualizó los Qwen3.8-27B comprimidos: la precisión sube un 5–10% con el mismo tamaño
- 21 nov 2026Google abre la preventa de sus gafas inteligentes con Gemini desde 395 $: las ventas empiezan el 10 de diciembre
- 21 nov 2026Durante tres días, a través de OpenRouter respondió un DeepSeek manipulado: las negativas cayeron del 83–98 % a un 1 %
Preguntas frecuentes sobre la noticia
¿Qué se sabe sobre Primero las capas, luego el movimiento?
La primera etapa se realiza en Photoshop. El autor selecciona personajes y objetos, pasa cada uno a una capa separada y agrupa las capas por significado: agua, personas, estructuras. La regla principal: los fragmentos conservan el sistema de coordenadas original del lienzo, sin recortarse al rectángulo mínimo. Así, en After Effects las capas encajan entre sí sin ajustar a mano la escala ni la posición. Después aparece el problema de los huecos.
¿Qué se sabe sobre Un LLM local escribe los prompts, MiniMax H3 mueve los fragmentos?
Para no redactar a mano descripciones largas, el autor ejecuta en LM Studio un modelo multimodal local, Qwen 3.8 27B en la cuantización Q5_K_XL (una versión comprimida que cabe en la memoria de vídeo). Se le proporcionan tres cosas: una descripción básica del movimiento deseado, el propio fragmento del cuadro y una lista de restricciones (vestimenta, apariencia, posición de los vecinos, cámara fija). El modelo mira la imagen y genera un prompt detallado en inglés.
¿Qué se sabe sobre Montaje en After Effects y el coste del experimento?
En After Effects, las capas y los clips generados se colocan según las coordenadas originales. Para separar las figuras del fondo se usa Roto Brush: el autor comprueba la estabilidad de la máscara, corrige los bordes y revisa por separado la ropa, las manos y los pies, donde los errores se notan más. Al final unifica color y luz para que los fragmentos no desentonen con la pintura general.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.