PostgreSQL en OpenAI: cómo escalar la base de datos de ChatGPT
OpenAI ha compartido su experiencia escalando PostgreSQL para sostener ChatGPT. El equipo usó replicación, caché, limitación de velocidad y aislamiento de cargas de trabajo para alcanzar millones de consultas por segundo. Este artículo analiza la arquitectura y las decisiones adoptadas.
Procesado por IA desde OpenAI Blog; editado por Hamidun News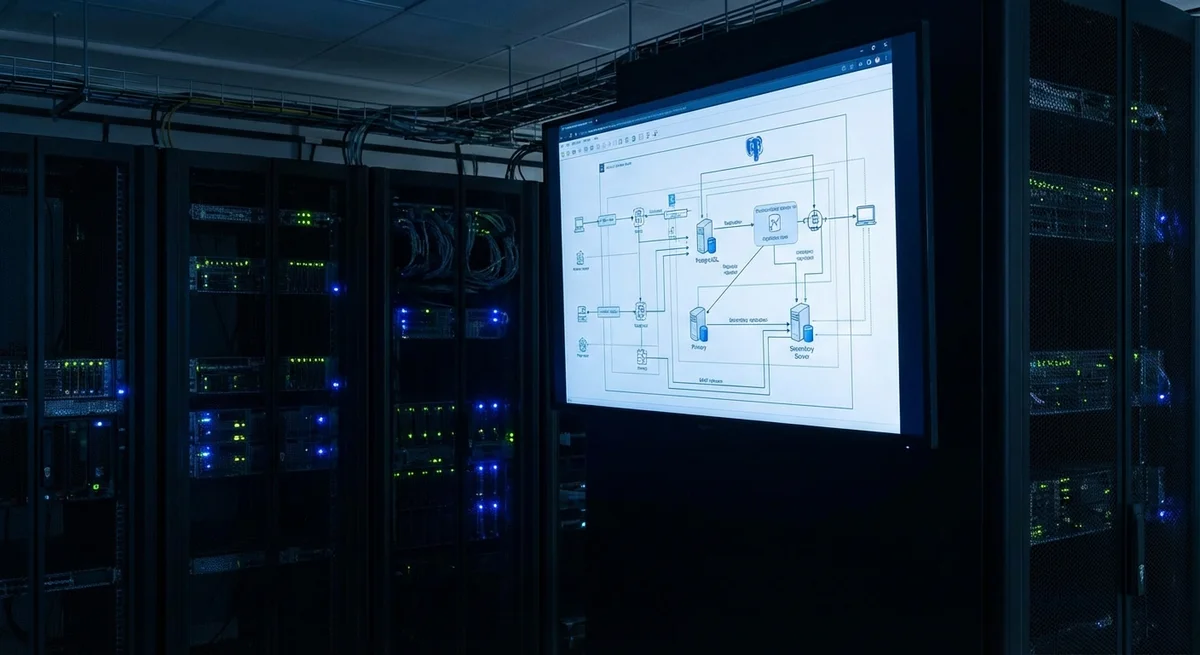
Cuando ChatGPT despegó, el equipo de OpenAI se enfrentó a un reto serio: garantizar que PostgreSQL, la base de datos sobre la que descansa todo, funcionara de forma estable y rápida. Había que atender a cientos de millones de usuarios y procesar millones de consultas por segundo. Resolverlo exigió bastante más que añadir hardware: hizo falta replantear a fondo la arquitectura y aplicar una serie de trucos de ingeniería.
A pesar de su madurez y fiabilidad, PostgreSQL no se diseñó originalmente para cargas tan extremas. Los métodos tradicionales de escalado, como el vertical (aumentar la potencia de un único servidor), tocaron techo enseguida. Quedó claro que hacía falta un enfoque horizontal: repartir la carga entre muchos servidores. En OpenAI optaron por la replicación y crearon numerosas copias de la base de datos de solo lectura. Eso alivió de forma notable al servidor principal y elevó el rendimiento global.
Sin embargo, la replicación es solo una parte de la solución. Para seguir optimizando se usó caché, es decir, almacenar en memoria los datos más solicitados para no consultar la base de datos en cada petición. Además, se implantó un sistema de limitación de velocidad (rate limiting) que evitó la sobrecarga del sistema ante picos bruscos de tráfico. Por último, el aislamiento de cargas de trabajo desempeñó un papel importante: los distintos tipos de consultas se repartieron entre servidores diferentes para evitar conflictos y dar prioridad a las operaciones más críticas.
Gracias a estos métodos, OpenAI no solo pudo con la carga actual, sino que creó una arquitectura escalable y preparada para seguir creciendo. Es un precedente importante para toda la industria: demuestra que incluso tecnologías maduras como PostgreSQL pueden sostener con éxito las aplicaciones de IA más exigentes. La experiencia de OpenAI muestra la importancia de un enfoque integral que combine replicación, caché, limitación de velocidad y aislamiento de cargas de trabajo.
Las consecuencias van mucho más allá de OpenAI. Otras empresas que manejan grandes volúmenes de datos y cargas elevadas pueden aprovechar estas prácticas para optimizar sus propios sistemas. Es especialmente relevante para plataformas de comercio electrónico, redes sociales y otros servicios que necesitan acceso instantáneo a grandes cantidades de información. Además, esta experiencia puede impulsar el desarrollo de PostgreSQL y otras bases de datos para mejorar su escalabilidad y rendimiento.
En conclusión, el éxito de OpenAI al escalar PostgreSQL no es solo un logro técnico, sino una lección importante para toda la industria. Demuestra que un buen enfoque de arquitectura y optimización puede permitir que incluso tecnologías maduras resuelvan las tareas más complejas. Esto abre nuevas posibilidades para la IA y otros campos que requieren procesar grandes volúmenes de datos.
- 2 nov 2026El marco AICG de NC State redujo un 50,3% el MAE al evaluar respuestas matemáticas
- 2 nov 2026Revisamos 929 automatizaciones en Alpina: cómo debería ser la formación corporativa en IA en 2026
- 2 nov 2026Interrogué a 6 redes neuronales sobre mí como lo haría un comprador corporativo: Amazon, esoterismo, «Telo Judelo» y 5 agujeros que cerramos en un día
- 2 nov 2026TJ Digital: el 23% de las páginas que cita la IA empiezan con una respuesta directa, frente al 14% de las que no cita
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.