AWS y NVIDIA lanzan el entrenamiento a gran escala del robot Unitree H1 en SageMaker AI
AWS y NVIDIA han mostrado cómo escalar en la nube el aprendizaje por refuerzo del robot humanoide Unitree H1. El simulador NVIDIA Isaac Lab ya funciona sobre Amazon SageMaker AI, con miles de entornos virtuales en paralelo y dos modos de ejecución: HyperPod para experimentos largos y Training Jobs para ejecuciones puntuales. Un solo nodo H100 puede entrenar 4096 entornos a la vez, y el tiempo de entrenamiento se reduce de días a horas.
Procesado por IA desde AWS Machine Learning Blog; editado por Hamidun News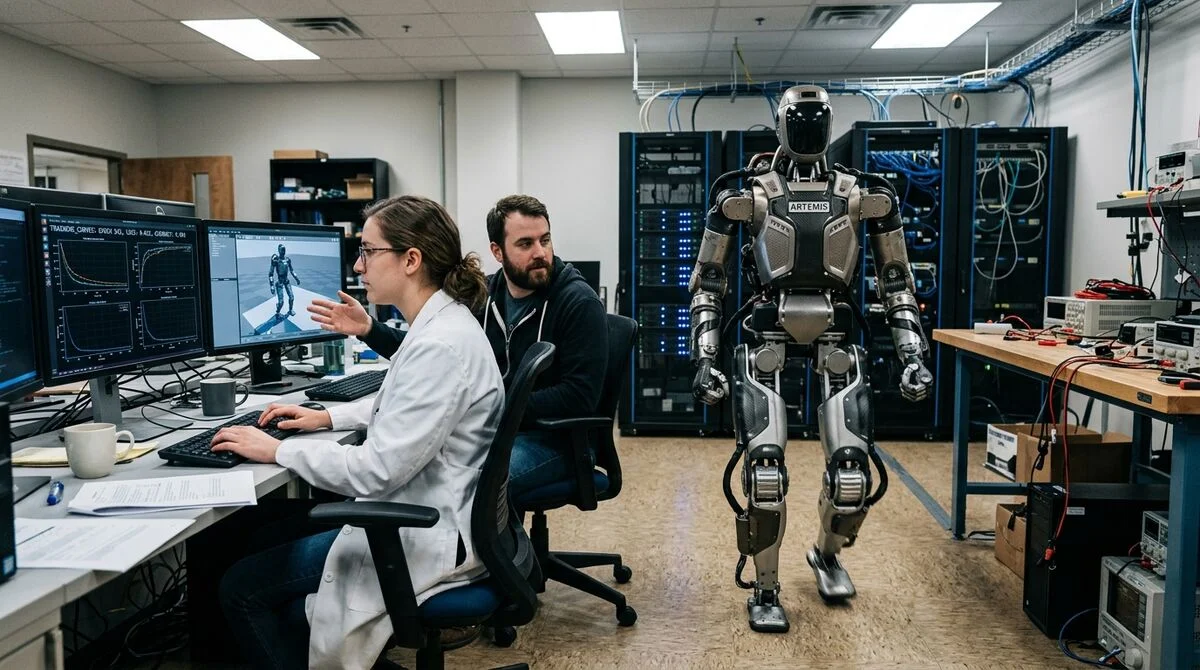
AWS, junto con NVIDIA, ha presentado un pipeline completo para entrenar políticas de control del robot humanoide Unitree H1 directamente en la nube, sin necesidad de un clúster de GPU propio.
Por qué la nube para los robots
El aprendizaje por refuerzo para robots físicos exige miles de millones de pasos de simulación, y no es una exageración. Para que un humanoide aprenda a caminar hacia delante sin caerse, la red neuronal debe pasar por decenas de miles de millones de interacciones entre un agente virtual y su entorno. Hacerlo en el mundo real es caro y peligroso: un experimento fallido puede suponer reparaciones de miles de dólares, y el proceso llevaría años en lugar de horas. Por eso el sector apuesta por la simulación física.
La carrera por una «ley de Moore para robots» ya ha empezado: Tesla, Figure, Boston Dynamics y decenas de startups invierten cientos de millones en crear entornos sintéticos de entrenamiento.
NVIDIA Isaac Lab es un simulador acelerado por GPU capaz de ejecutar a la vez miles de copias de un entorno virtual en un solo nodo. Hasta ahora se usaba sobre todo en grandes laboratorios corporativos y universitarios con hardware costoso.
Ahora Isaac Lab está integrado directamente con Amazon SageMaker AI. Esto significa que una solicitud de cientos de GPU se atiende en minutos y el ingeniero no tiene que pensar en la infraestructura, solo en el código de la política y en la configuración de la tarea.
Dos formas de ejecutarlo
AWS ofrece dos modos para distintos casos de uso:
- SageMaker HyperPod: un clúster gestionado y persistente; la infraestructura se conserva entre ejecuciones, lo que resulta práctico para investigaciones de varias semanas y para el ajuste iterativo de hiperparámetros
- SageMaker Training Jobs: una ejecución gestionada de un solo uso; los recursos se asignan estrictamente a la tarea y se liberan automáticamente al terminar, lo que facilita el control del presupuesto
- Se admiten instancias de las series p4d y p5, con NVIDIA A100 y H100 respectivamente
- Isaac Lab se despliega en un contenedor Docker estándar; los pesos del modelo y los checkpoints se guardan automáticamente en Amazon S3
- Las métricas de entrenamiento (reward, episode length, entropy loss) llegan a Amazon CloudWatch en tiempo real
La principal ventaja de ambas opciones es que eliminan la carga operativa. No hace falta configurar Kubernetes por cuenta propia, gestionar la red InfiniBand entre nodos ni equilibrar a mano la carga entre GPU.
Cómo se entrena el Unitree H1
El Unitree H1 es uno de los humanoides de serie más accesibles: mide unos 180 cm, pesa 47 kg y tiene 19 grados de libertad. Eso lo convierte en una plataforma popular para la investigación académica sobre control del movimiento.
En la simulación de Isaac Lab, miles de copias virtuales del robot aprenden a caminar en paralelo con el algoritmo Proximal Policy Optimization (PPO): se caen, se levantan, corrigen el equilibrio y reciben una recompensa por avanzar de forma estable. La política entrenada será tan buena como lo sea la precisión con que la función de recompensa describa el comportamiento deseado.
En un solo nodo H100, Isaac Lab puede ejecutar hasta 4096 simulaciones en paralelo a la vez. Al escalar a varios nodos se recurre al entrenamiento distribuido mediante PyTorch DDP, y la sincronización de gradientes entre GPU ocurre de forma automática.
«Escalar a cientos de GPU con
SageMaker reduce el tiempo de entrenamiento de varios días a unas pocas horas», señalan los autores de la publicación en el blog de AWS.
Al terminar, la política entrenada se exporta a los formatos ONNX o TorchScript y puede trasladarse al hardware real mediante NVIDIA Isaac ROS.
Qué significa
El aprendizaje por refuerzo en la nube para robots sale del ámbito de los laboratorios con presupuestos de hardware de varios millones. Cualquier equipo pequeño con una cuenta de AWS puede ahora lanzar un experimento serio de entrenamiento de un humanoide sin inversión de capital en infraestructura.
Esto cambia la economía de la robótica: la barrera de entrada baja, la velocidad de iteración sube y los próximos avances en el control de robots físicos bien podrían venir de equipos sorprendentemente pequeños.
- 31 oct 2026Worldwide Express encargó las facturas en disputa a agentes de IA y redujo su deuda un 75%
- 30 oct 2026AWS ofrece a los agentes de código una vista previa en vivo del sitio desde la sesión aislada
- 30 oct 2026MoEngage abre 400 API cerradas a agentes de IA con AgentCore Gateway, sin servidores MCP propios
- 29 oct 2026NVIDIA Nemotron 3.5 Super VL: 120 mil millones de parámetros, 12 mil millones activos, despliegue en AWS
Preguntas frecuentes sobre la noticia
¿Qué se sabe sobre Por qué la nube para los robots?
El aprendizaje por refuerzo para robots físicos exige miles de millones de pasos de simulación, y no es una exageración. Para que un humanoide aprenda a caminar hacia delante sin caerse, la red neuronal debe pasar por decenas de miles de millones de interacciones entre un agente virtual y su entorno. Hacerlo en el mundo real es caro y peligroso: un experimento fallido puede suponer reparaciones de miles de dólares, y el proceso llevaría años en lugar de horas. Por eso el sector apuesta por la simulación física. La carrera por una «ley de Moore para robots» ya ha empezado: T
¿Qué se sabe sobre Dos formas de ejecutarlo?
AWS ofrece dos modos para distintos casos de uso: SageMaker HyperPod: un clúster gestionado y persistente; la infraestructura se conserva entre ejecuciones, lo que resulta práctico para investigaciones de varias semanas y para el ajuste iterativo de hiperparámetros SageMaker Training Jobs: una ejecución gestionada de un solo uso; los recursos se asignan estrictamente a la tarea y se liberan automáticamente al terminar, lo que facilita el control del presupuesto Se admiten instancias de las series p4d y p5, con NVIDIA A100 y H100 respectivamente Isaac Lab se despliega en un
Cómo se entrena el Unitree H1?
El Unitree H1 es uno de los humanoides de serie más accesibles: mide unos 180 cm, pesa 47 kg y tiene 19 grados de libertad. Eso lo convierte en una plataforma popular para la investigación académica sobre control del movimiento. En la simulación de Isaac Lab, miles de copias virtuales del robot aprenden a caminar en paralelo con el algoritmo Proximal Policy Optimization (PPO): se caen, se levantan, corrigen el equilibrio y reciben una recompensa por avanzar de forma estable. La política entrenada será tan buena como lo sea la precisión con que la función de recompensa descr
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.