LangChain: cómo la ingeniería de bucles agénticos hace fiables a los agentes de IA
Un agente de IA fiable necesita algo más que un buen modelo. LangChain ha publicado un análisis de la «ingeniería de bucles»: cómo diseñar el agent loop para que el agente funcione de forma estable en tareas reales. La clave está en las capas. Los bucles internos resuelven subtareas concretas y los externos gestionan la orquestación. Los primitivos de LangChain ayudan a instrumentar cada nivel y a localizar dónde falla el agente.
Procesado por IA desde LangChain Blog; editado por Hamidun News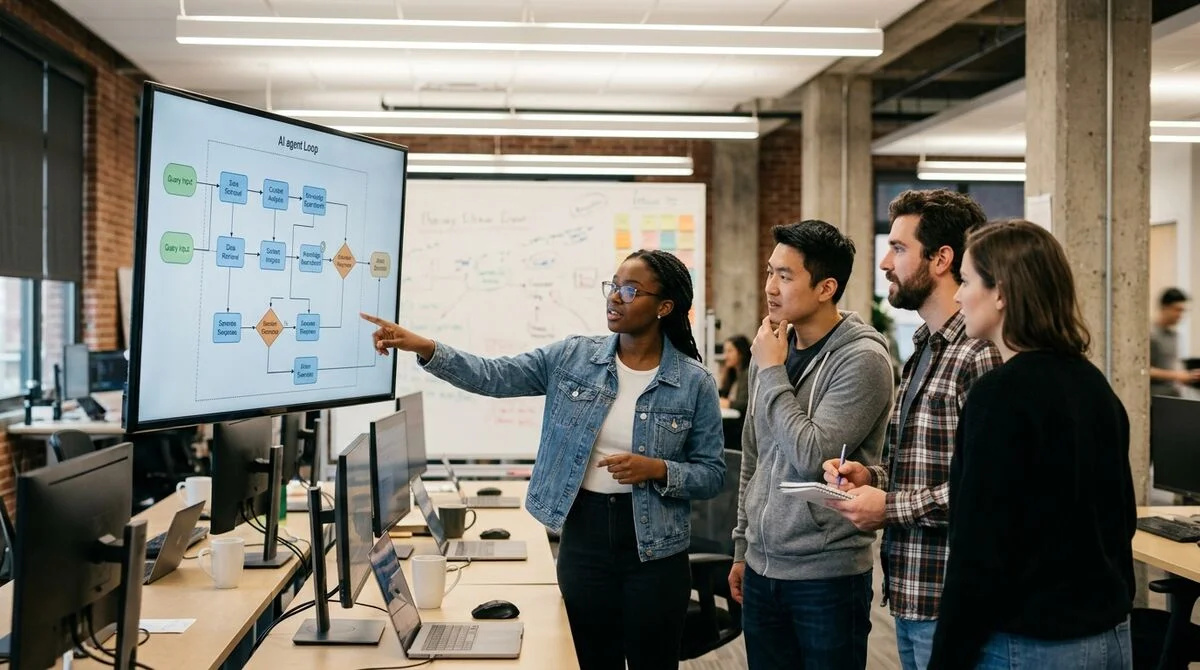
LangChain ha publicado un análisis de una de las decisiones arquitectónicas clave al crear agentes de IA: cómo diseñar correctamente el «bucle agéntico» y por qué la fiabilidad en producción depende de eso, y no de la elección del modelo.
Por qué el modelo no basta
La mayoría de los desarrolladores se topa con el mismo problema: el agente funciona bien en la demo, pero falla en tareas reales. LangChain afirma que rara vez el problema está en el modelo. El problema es la ausencia de un harness (arnés) bien pensado que rodee al modelo y controle el flujo de ejecución.
Un agente no es solo una llamada a un LLM con herramientas. Es un proceso iterativo controlado: observa el estado, elige una acción, recibe el resultado, actualiza el estado y repite. La fiabilidad depende de lo cuidadosamente que se haya diseñado este bucle.
Anatomía del agent loop
El bucle básico consta de cuatro pasos que se repiten hasta completar la tarea:
- Observación — el agente recibe el contexto actual: la tarea, el historial y los resultados de las herramientas anteriores
- Razonamiento — el LLM decide qué hacer a continuación: llamar a una herramienta, pedir una aclaración o terminar
- Acción — una llamada a una herramienta o la respuesta final
- Actualización — el resultado se guarda en el estado y el bucle continúa
La idea clave: cada nivel debe tener sus propias herramientas de observación. Sin registro en cada paso, es imposible saber dónde se equivoca exactamente el agente.
Apilar y ampliar bucles
Los agentes complejos usan bucles anidados con distintos horizontes de decisión. El bucle externo gestiona la tarea global: la divide en subtareas, sigue el progreso y decide cuándo terminar. Los bucles internos resuelven subtareas concretas, como la búsqueda, la escritura de código y la verificación.
LangChain identifica varios patrones de ampliación. Reflection loops: el agente revisa su propia salida antes de entregarla al usuario. Validation loops: un bucle independiente verifica los resultados, por ejemplo ejecutando pruebas sobre el código generado. Escalation loops: si el agente no puede resolver la tarea en N pasos, cede el control a una persona.
Cada capa añade fiabilidad, pero también aumenta la latencia. El trabajo del ingeniero es equilibrar la minuciosidad y la velocidad.
Primitivos de LangChain para la instrumentación
LangGraph permite describir los bucles agénticos como un grafo de estados (StateGraph), donde cada nodo es un paso del bucle y las aristas son las transiciones entre ellos. Esto ofrece tres ventajas prácticas.
Primero, transparencia: cada transición se registra y cualquier fallo se puede reproducir. Segundo, control: se pueden añadir «puntos de interrupción» en los que una persona revisa la decisión del agente antes de continuar. Tercero, capacidad de prueba: cada nodo se puede probar de forma aislada sin ejecutar todo el agente.
LangSmith cubre la observabilidad en producción. Sin él, es difícil saber en qué paso se degrada el agente al escalar.
Qué significa esto
La industria pasa de «llama a GPT-4 con herramientas» a una ingeniería completa de sistemas de agentes. Los equipos que invierten ahora en la arquitectura de bucles y en la observabilidad obtendrán agentes que funcionan en producción, y no solo en las demos.
- 1 nov 2026StreamVibe, el agente de vídeo de Google, supera en un 10,7 % a otros modelos en momento y calidad de respuesta
- 1 nov 2026Una nueva prueba detecta la colusión oculta entre agentes de IA a partir de cómo reacciona su socio a una paráfrasis
- 1 nov 2026Illinois reúne 12 151 problemas abiertos y comprueba si la IA puede resolverlos
- 31 oct 2026Un ingeniero de IA escribió una sola función de recompensa para equipos de agentes: la tasa de victorias subió del 51% al 90%
Preguntas frecuentes sobre la noticia
¿Qué se sabe sobre Por qué el modelo no basta?
La mayoría de los desarrolladores se topa con el mismo problema: el agente funciona bien en la demo, pero falla en tareas reales. LangChain afirma que rara vez el problema está en el modelo. El problema es la ausencia de un harness (arnés) bien pensado que rodee al modelo y controle el flujo de ejecución. Un agente no es solo una llamada a un LLM con herramientas. Es un proceso iterativo controlado: observa el estado, elige una acción, recibe el resultado, actualiza el estado y repite. La fiabilidad depende de lo cuidadosamente que se haya diseñado este bucle.
¿Qué se sabe sobre Anatomía del agent loop?
El bucle básico consta de cuatro pasos que se repiten hasta completar la tarea: Observación — el agente recibe el contexto actual: la tarea, el historial y los resultados de las herramientas anteriores Razonamiento — el LLM decide qué hacer a continuación: llamar a una herramienta, pedir una aclaración o terminar Acción — una llamada a una herramienta o la respuesta final Actualización — el resultado se guarda en el estado y el bucle continúa La idea clave: cada nivel debe tener sus propias herramientas de observación. Sin registro en cada paso, es imposible saber dónde se
¿Qué se sabe sobre Apilar y ampliar bucles?
Los agentes complejos usan bucles anidados con distintos horizontes de decisión. El bucle externo gestiona la tarea global: la divide en subtareas, sigue el progreso y decide cuándo terminar. Los bucles internos resuelven subtareas concretas, como la búsqueda, la escritura de código y la verificación. LangChain identifica varios patrones de ampliación. Reflection loops: el agente revisa su propia salida antes de entregarla al usuario. Validation loops: un bucle independiente verifica los resultados, por ejemplo ejecutando pruebas sobre el código generado. Escalation loops:
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.