AWS muestra cómo el data mesh se convierte en la base de la IA agéntica en producción
AWS ha publicado una guía para construir un data mesh en su plataforma como base fiable de la IA agéntica en producción. La idea: los agentes no pueden funcionar de forma estable sin un acceso gobernado a los datos. AWS propone un stack serverless con S3, Glue, Lake Formation y Athena, con acceso por roles a nivel de dominio, auditoría completa y contratos de datos para cada agente de IA.
Procesado por IA desde AWS Machine Learning Blog; editado por Hamidun News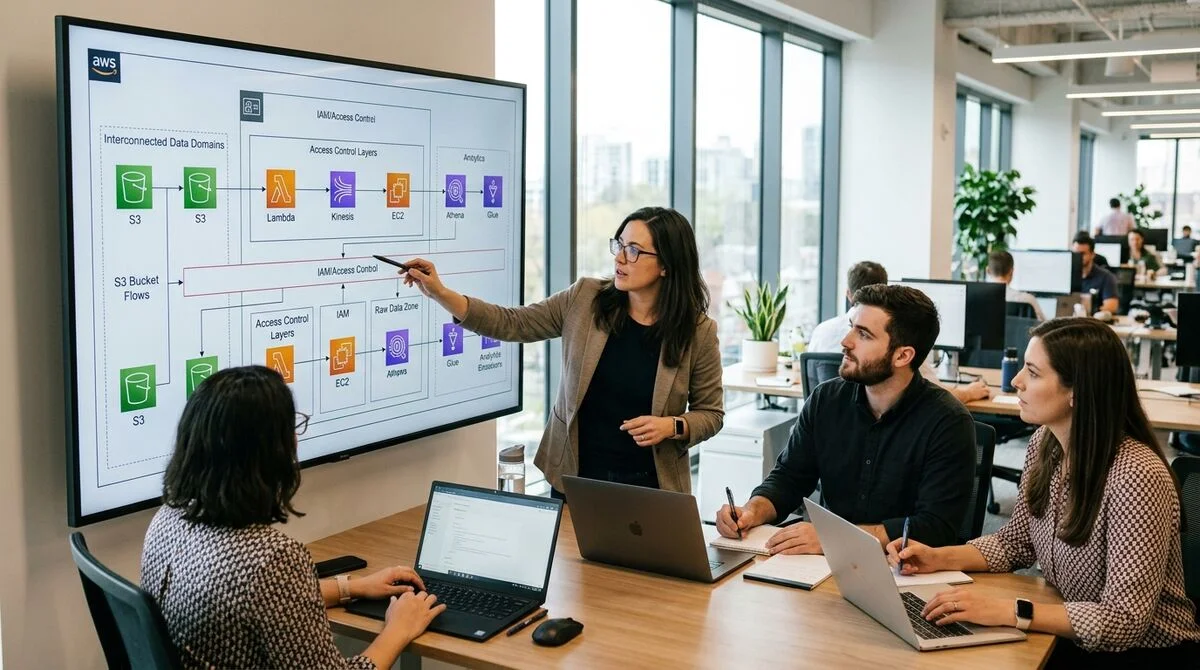
AWS ha publicado una guía técnica detallada para crear un data mesh serverless gobernado, una arquitectura que ofrece a la IA agéntica una base fiable, segura y escalable para trabajar en producción.
Por qué los agentes necesitan un data mesh
La IA agéntica se distingue de forma fundamental de los chatbots: genera por sí misma cadenas de acciones, recurre a herramientas y toma decisiones sin intervención humana. Para hacerlo con fiabilidad, el agente debe recibir datos corporativos actualizados en tiempo real, y siempre dentro de las políticas de seguridad.
El problema es que los datos corporativos suelen estar dispersos en decenas de sistemas, equipos y formatos. Los data warehouse y data lake centralizados resuelven una parte, pero crean un cuello de botella: los datos se quedan obsoletos, los esquemas divergen y un único equipo de ingenieros no da abasto con las peticiones de todos los departamentos.
El data mesh plantea otro enfoque: cada dominio (finanzas, marketing, logística) es dueño de sus datos y los publica como un «producto», con documentación, esquemas claros y contratos de acceso. El agente de IA se conecta directamente a ese producto, sin intermediarios.
Arquitectura en AWS
AWS ofrece un stack serverless que permite implantar un data mesh sin gestionar servidores:
- Amazon S3: almacenamiento descentralizado; cada dominio guarda sus datos en buckets separados
- AWS Glue Data Catalog: catálogo único de esquemas y metadatos para todos los dominios
- AWS Lake Formation: gestión de permisos de acceso a nivel de tabla, columna y fila
- Amazon Athena: consultas SQL serverless sobre los datos en S3 sin pipelines ETL adicionales
- AWS IAM: modelo basado en roles; cada agente recibe los permisos mínimos necesarios
Lo esencial: el agente no necesita conocer la ubicación física de los datos. Accede a un producto lógico a través del catálogo de Glue, no directamente a los buckets de S3. Así, los equipos pueden mover y reestructurar los datos sin cambiar la interfaz para los agentes.
En la práctica, el ciclo es este: el agente recibe un rol de IAM, Lake Formation comprueba los permisos en cada consulta, Athena ejecuta el SQL y el resultado vuelve al agente. Todo es serverless y todas las acciones son auditables.
Seguridad y control
La IA agéntica es impredecible: puede generar una consulta que sobrecargue el sistema o intentar leer datos fuera de su dominio. AWS lo aborda en varios niveles.
Las políticas de Lake Formation bloquean cualquier consulta fuera del ámbito permitido, incluso si el agente tiene acceso técnico a S3. CloudTrail mantiene un registro de auditoría completo de cada acción. Las cuotas de Athena limitan el volumen de datos escaneados por consulta, lo que protege frente a sobrecargas accidentales o deliberadas.
Otro detalle importante es la semántica de los datos. Glue Data Catalog almacena no solo esquemas, sino también descripciones de los campos: el agente entiende el significado de lo que lee, en lugar de recibir un conjunto de bytes sin contexto. El versionado de esquemas garantiza que un cambio de estructura en un dominio no romperá los agentes que trabajan con ese producto.
Qué significa
El data mesh deja de ser un concepto teórico y se convierte en un requisito práctico para quien construya IA en producción. Las empresas sin acceso gobernado a los datos acabarán con agentes poco fiables o inseguros, y con más frecuencia ambas cosas a la vez.
AWS ofrece un stack serverless listo para usar que cubre la mayoría de las tareas de serie.
- 31 oct 2026Worldwide Express encargó las facturas en disputa a agentes de IA y redujo su deuda un 75%
- 30 oct 2026AWS ofrece a los agentes de código una vista previa en vivo del sitio desde la sesión aislada
- 30 oct 2026MoEngage abre 400 API cerradas a agentes de IA con AgentCore Gateway, sin servidores MCP propios
- 29 oct 2026NVIDIA Nemotron 3.5 Super VL: 120 mil millones de parámetros, 12 mil millones activos, despliegue en AWS
Preguntas frecuentes sobre la noticia
¿Qué se sabe sobre Por qué los agentes necesitan un data mesh?
La IA agéntica se distingue de forma fundamental de los chatbots: genera por sí misma cadenas de acciones, recurre a herramientas y toma decisiones sin intervención humana. Para hacerlo con fiabilidad, el agente debe recibir datos corporativos actualizados en tiempo real, y siempre dentro de las políticas de seguridad. El problema es que los datos corporativos suelen estar dispersos en decenas de sistemas, equipos y formatos. Los data warehouse y data lake centralizados resuelven una parte, pero crean un cuello de botella: los datos se quedan obsoletos, los esquemas diverge
¿Qué se sabe sobre Arquitectura en AWS?
AWS ofrece un stack serverless que permite implantar un data mesh sin gestionar servidores: Amazon S3: almacenamiento descentralizado; cada dominio guarda sus datos en buckets separados AWS Glue Data Catalog: catálogo único de esquemas y metadatos para todos los dominios AWS Lake Formation: gestión de permisos de acceso a nivel de tabla, columna y fila Amazon Athena: consultas SQL serverless sobre los datos en S3 sin pipelines ETL adicionales AWS IAM: modelo basado en roles; cada agente recibe los permisos mínimos necesarios Lo esencial: el agente no necesita conocer la ubi
¿Qué se sabe sobre Seguridad y control?
La IA agéntica es impredecible: puede generar una consulta que sobrecargue el sistema o intentar leer datos fuera de su dominio. AWS lo aborda en varios niveles. Las políticas de Lake Formation bloquean cualquier consulta fuera del ámbito permitido, incluso si el agente tiene acceso técnico a S3. CloudTrail mantiene un registro de auditoría completo de cada acción. Las cuotas de Athena limitan el volumen de datos escaneados por consulta, lo que protege frente a sobrecargas accidentales o deliberadas. Otro detalle importante es la semántica de los datos. Glue Data Catalog al
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.