NVIDIA Open-SWE-Traces: cómo armar datos para afinar agentes que escriben código
NVIDIA ha publicado Open-SWE-Traces, un dataset con miles de sesiones reales de agentes de IA que resuelven tareas de programación. El tutorial explica cómo hacer streaming de los datos desde Hugging Face a Colab, normalizar los diálogos multiturno de los agentes, analizar los parches de código finales y seleccionar ejemplos de calidad para el ajuste fino supervisado según la etiqueta de éxito, el límite de tokens y el lenguaje. Cada registro incluye metadatos estructurados, desde la longitud de la trayectoria hasta el lenguaje de programación de la tarea, lo que facilita el filtrado.
Procesado por IA desde MarkTechPost; editado por Hamidun News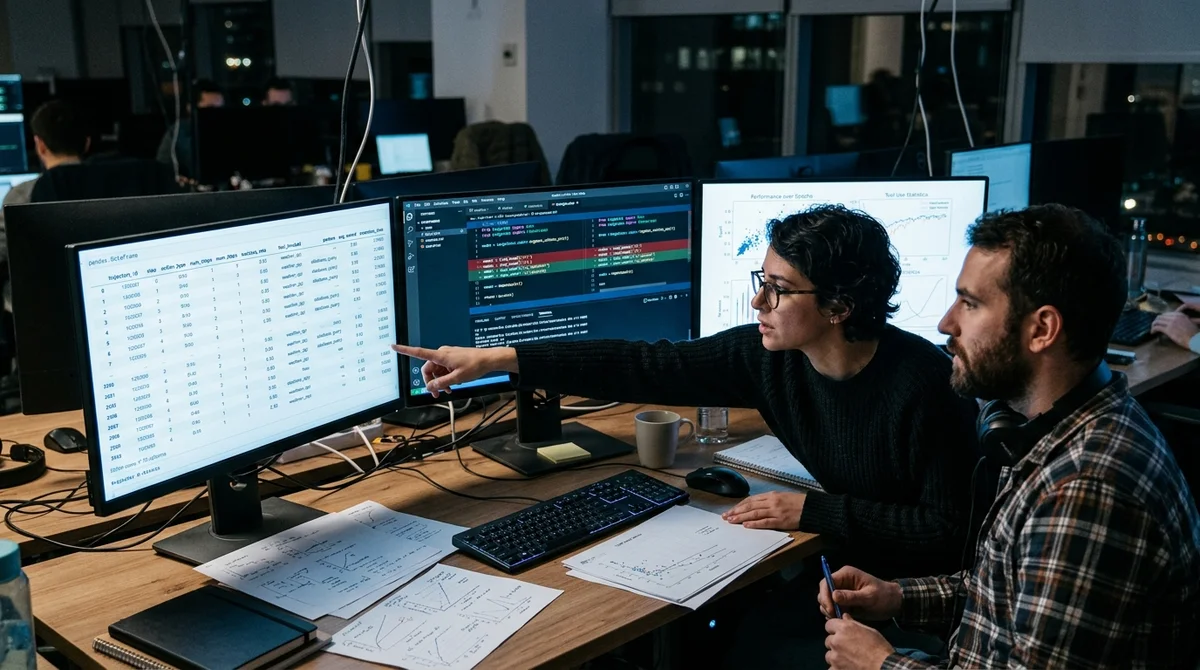
NVIDIA ha abierto el dataset Open-SWE-Traces, una colección de sesiones multiturno reales de agentes de IA que resuelven tareas de desarrollo de software. El tutorial recorre todo el pipeline, desde el streaming de los datos hasta una muestra lista para el ajuste fino supervisado (SFT).
Qué es Open-SWE-Traces
El dataset contiene miles de trayectorias de agentes. Cada una es el registro completo de una sesión en la que la IA recibe una tarea de ingeniería, llama a herramientas paso a paso (lectura de archivos, ejecución de pruebas, búsqueda en el código), itera sobre la solución y entrega un parche final. Es algo muy distinto de los datasets habituales de pregunta-respuesta: aquí queda registrado no solo qué se logró, sino cómo llegó el agente hasta ahí.
Cada registro incluye metadatos estructurados:
- longitud de la trayectoria: número de pasos del agente
- lista de herramientas usadas y frecuencia de llamadas
- tamaño del diff final en líneas de código
- lenguaje de programación de la tarea
- indicador de solución exitosa o fallida
Los datos están alojados en Hugging Face y admiten streaming. En Google Colab se puede trabajar con el dataset sin descargarlo por completo, algo importante con volúmenes de varios gigabytes.
Cómo se construye el pipeline
El tutorial guía por varias etapas de procesamiento.
La primera es la normalización de los diálogos. Las sesiones multiturno del agente se llevan a un formato único: los mensajes del usuario, las respuestas del agente y las llamadas a herramientas se alinean en una secuencia. Hace falta porque las distintas versiones de agentes registran las sesiones de forma diferente.
La segunda es el análisis de parches. Del resultado final del agente se extrae el propio código de los cambios en formato unified diff. Ese parche se convierte en la «respuesta» del ejemplo de entrenamiento.
La tercera es la construcción de un DataFrame analítico. Para cada trayectoria se calculan métricas clave: presupuestos de tokens en distintas fases del trabajo del agente, distribución por herramientas y estadísticas de éxito por lenguaje y tipo de tarea.
Filtrado para SFT
El último paso es la selección de ejemplos para el entrenamiento. Los autores aplican una cadena de filtros.
Por etiquetas de éxito: solo entran en la muestra las trayectorias con una solución exitosa. Entrenar con sesiones fallidas sin un etiquetado específico es peligroso: el modelo asimilará patrones erróneos.
Por tokens: se descartan las trayectorias que superan un límite establecido. Los ejemplos demasiado largos no caben en el contexto con los ajustes de entrenamiento estándar.
Por lenguaje: si se necesita un agente especializado en Python o JavaScript, el filtrado deja solo los ejemplos relevantes.
Por presencia de parche: las sesiones sin código final no sirven para SFT, donde el modelo debe aprender a producir un resultado concreto.
«La calidad de los datos de entrenamiento importa más que la cantidad,
sobre todo en las trazas de agentes, donde las sesiones fallidas pueden fijar malos patrones en el modelo».
Qué significa
Open-SWE-Traces de NVIDIA es uno de los primeros datasets públicos con trayectorias reales de agentes para tareas de ingeniería. El tutorial ofrece una plantilla funcional: de los datos en bruto en Hugging Face a una muestra SFT lista en pocas líneas de código. Para los equipos que construyen sus propios agentes de programación, es un punto de partida listo que evita recopilar datos desde cero.
- 1 nov 2026Prueba de 16 modelos en 7 buscadores: Exa obtuvo una media de 10,5 puntos de 14; SearXNG, en torno a 3
- 1 nov 2026StreamVibe, el agente de vídeo de Google, supera en un 10,7 % a otros modelos en momento y calidad de respuesta
- 1 nov 2026OpenAI reescribe las reglas de comportamiento de GPT: cinco valores y una cadena de prioridades
- 1 nov 2026Los bots de voz con LLM recurren al clasificador rápido Jev: decisiones en 200–500 ms
Preguntas frecuentes sobre la noticia
¿Qué se sabe sobre Qué es Open-SWE-Traces?
El dataset contiene miles de trayectorias de agentes. Cada una es el registro completo de una sesión en la que la IA recibe una tarea de ingeniería, llama a herramientas paso a paso (lectura de archivos, ejecución de pruebas, búsqueda en el código), itera sobre la solución y entrega un parche final. Es algo muy distinto de los datasets habituales de pregunta-respuesta: aquí queda registrado no solo qué se logró, sino cómo llegó el agente hasta ahí. Cada registro incluye metadatos estructurados: longitud de la trayectoria: número de pasos del agente lista de herramientas usa
Cómo se construye el pipeline?
El tutorial guía por varias etapas de procesamiento. La primera es la normalización de los diálogos. Las sesiones multiturno del agente se llevan a un formato único: los mensajes del usuario, las respuestas del agente y las llamadas a herramientas se alinean en una secuencia. Hace falta porque las distintas versiones de agentes registran las sesiones de forma diferente. La segunda es el análisis de parches. Del resultado final del agente se extrae el propio código de los cambios en formato unified diff. Ese parche se convierte en la «respuesta» del ejemplo de entrenamiento.
¿Qué se sabe sobre Filtrado para SFT?
El último paso es la selección de ejemplos para el entrenamiento. Los autores aplican una cadena de filtros. Por etiquetas de éxito: solo entran en la muestra las trayectorias con una solución exitosa. Entrenar con sesiones fallidas sin un etiquetado específico es peligroso: el modelo asimilará patrones erróneos. Por tokens: se descartan las trayectorias que superan un límite establecido. Los ejemplos demasiado largos no caben en el contexto con los ajustes de entrenamiento estándar. Por lenguaje: si se necesita un agente especializado en Python o JavaScript, el filtrado de
Build & Ship Production AI Agents Without Boilerplate Code
Start your free 72-hour trial at Hamidun Academy (academy.hamidun.com) — interactive lessons on Claude Code & Cursor, live Tech Radar, and production agent templates.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.