Primero la infraestructura, después el modelo: cómo las empresas replantean su enfoque de la IA
PSM desarrolló su propio agente de IA y se topó con un techo de hardware. En lugar de elegir primero un modelo, la empresa preparó la infraestructura. Así surgió la idea de un módulo AI ready: una base lista que permite implantar IA sin rehacer los servidores. La lección central es sencilla: primero la infraestructura, después el modelo.
Procesado por IA desde Habr AI; editado por Hamidun News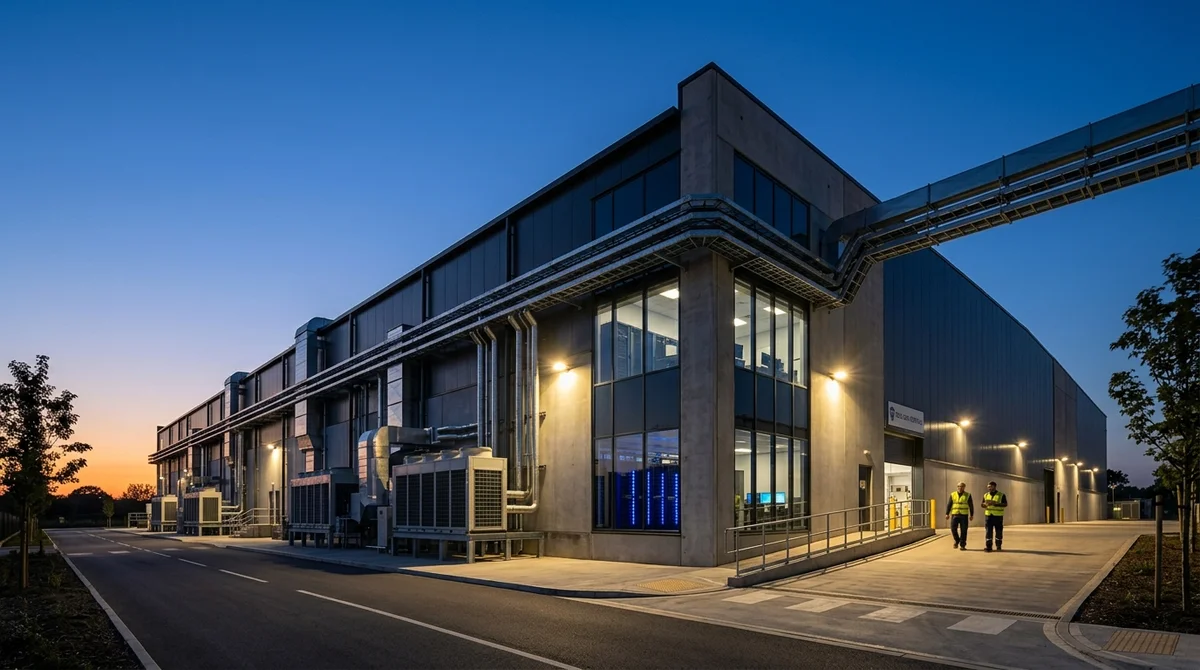
Las empresas quieren su propia IA. Todos preguntan qué modelo elegir. Pero nadie piensa en qué hardware funcionará ese modelo. PSM Unlimited se topó con este problema en carne propia. El equipo desarrolló un agente de IA corporativo, formó a su gente y estaba listo para escalar, pero chocó con un muro de límites de hardware. La solución nació de un error: primero hace falta la infraestructura y después el modelo.
Por qué el modelo es solo la mitad del trabajo
Cuando en las empresas se habla de IA, todos discuten sobre algoritmos, redes neuronales y calidad de los modelos. Es natural: el modelo se ve, se escriben artículos sobre él y se puede mostrar en una demo. Pero la IA no vive en la nube como un conjunto abstracto de pesos y parámetros. Vive en servidores, y esos servidores tienen que ser los adecuados.
En la práctica es así: implantas un agente y funciona con un conjunto de prueba. Empiezas a escalar y topas con los límites. Faltan GPU. Se acaba la memoria. La red no da abasto. Los procesadores se calientan. Hay que rehacer la infraestructura y luego volver a ajustar el modelo a las nuevas condiciones.
Qué es un módulo AI ready
AI ready significa que la infraestructura está preparada de antemano, antes de elegir qué modelo ejecutar. Los cimientos están hechos y se puede construir encima. Incluye:
- Cómputo — clústeres de GPU/TPU con potencia suficiente para el procesamiento paralelo
- Memoria — VRAM de las GPU y RAM de los servidores sin cuellos de botella
- Almacenamiento — SSD rápidos para modelos, registros y caché (no HDD)
- Red — baja latencia entre nodos y alto ancho de banda
- Refrigeración y alimentación — preparación para cargas 24/7
No es un modelo concreto, ni TensorFlow ni PyTorch. Es la casa física en la que cualquier IA puede vivir sin rehacer nada.
Qué aporta a la empresa
Primero, velocidad. No se pasan meses rehaciendo servidores. No se espera la entrega de GPU. Se toma una base lista y se lanza el modelo mañana.
Segundo, escalabilidad. Cuando llegan nuevos requisitos (más usuarios, un modelo más pesado), la infraestructura ya está preparada. No hace falta rehacer la arquitectura; basta con cambiar una configuración.
Tercero, costes. Una infraestructura adecuada ahorra electricidad (refrigeración y alimentación eficientes), recursos caros (sin sobrecompra de equipos) y tiempo de los ingenieros (sin pelear con cuellos de botella).
Qué significa esto
La IA no es magia en la nube. Es silicio, plástico y electricidad. Elegir un modelo es más fácil que preparar la infraestructura. Por eso la empresa que empieza por la infraestructura y no por el modelo gana a los competidores que descubren los problemas de hardware cuando ya han escrito el código.
Preguntas frecuentes sobre la noticia
¿Qué se sabe sobre Por qué el modelo es solo la mitad del trabajo?
Cuando en las empresas se habla de IA, todos discuten sobre algoritmos, redes neuronales y calidad de los modelos. Es natural: el modelo se ve, se escriben artículos sobre él y se puede mostrar en una demo. Pero la IA no vive en la nube como un conjunto abstracto de pesos y parámetros. Vive en servidores, y esos servidores tienen que ser los adecuados. En la práctica es así: implantas un agente y funciona con un conjunto de prueba. Empiezas a escalar y topas con los límites. Faltan GPU. Se acaba la memoria. La red no da abasto. Los procesadores se calientan. Hay que rehacer
¿Qué se sabe sobre Qué es un módulo AI ready?
AI ready significa que la infraestructura está preparada de antemano, antes de elegir qué modelo ejecutar. Los cimientos están hechos y se puede construir encima. Incluye: Cómputo — clústeres de GPU/TPU con potencia suficiente para el procesamiento paralelo Memoria — VRAM de las GPU y RAM de los servidores sin cuellos de botella Almacenamiento — SSD rápidos para modelos, registros y caché (no HDD) Red — baja latencia entre nodos y alto ancho de banda Refrigeración y alimentación — preparación para cargas 24/7 No es un modelo concreto, ni TensorFlow ni PyTorch. Es la casa fí
¿Qué se sabe sobre Qué aporta a la empresa?
Primero, velocidad. No se pasan meses rehaciendo servidores. No se espera la entrega de GPU. Se toma una base lista y se lanza el modelo mañana. Segundo, escalabilidad. Cuando llegan nuevos requisitos (más usuarios, un modelo más pesado), la infraestructura ya está preparada. No hace falta rehacer la arquitectura; basta con cambiar una configuración. Tercero, costes. Una infraestructura adecuada ahorra electricidad (refrigeración y alimentación eficientes), recursos caros (sin sobrecompra de equipos) y tiempo de los ingenieros (sin pelear con cuellos de botella).
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.