Un laboratorio de IA en casa por 200.000 rublos
Hace cinco años, una Tesla V100 costaba 8.000 dólares. Hoy se vende por 1.500. Eso ha roto la economía de las GPU en la nube: comprar el hardware propio ya es más barato que pagar un mes a un proveedor. Repasamos qué modelos aguantan en la V100, dónde tropieza la tarjeta y si la inversión de 200.000 rublos se amortiza.
Procesado por IA desde Habr AI; editado por Hamidun News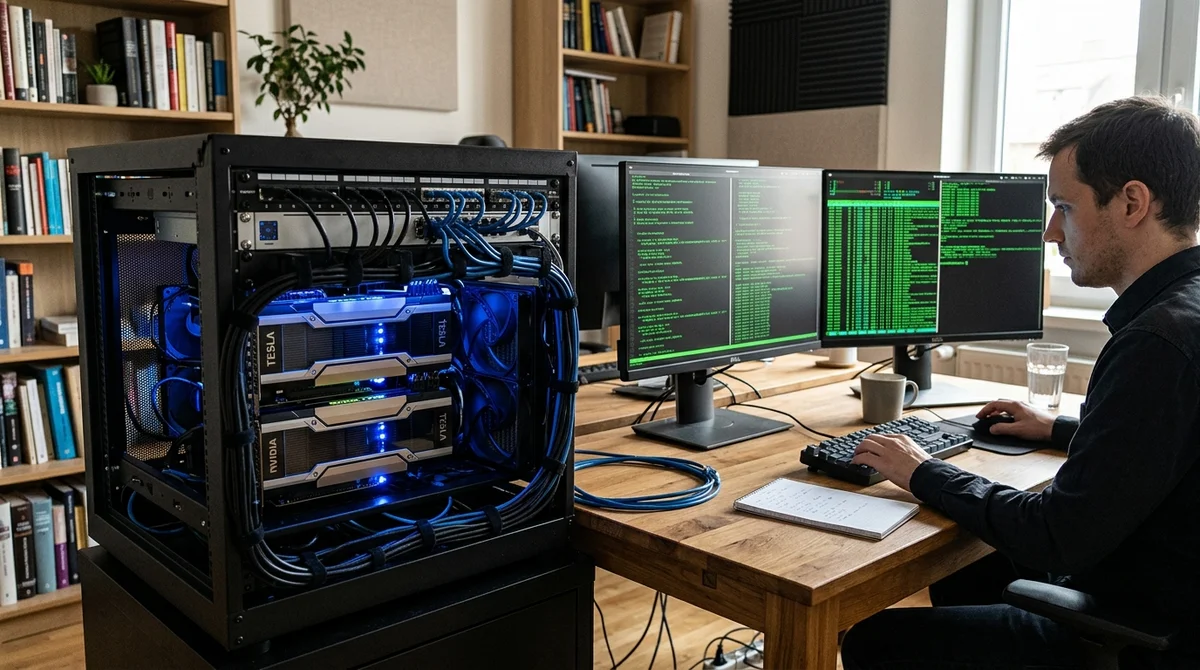
La Tesla V100 costaba 8.000 dólares en 2017. Hoy se vende en el mercado de segunda mano por 1.500. Esa cifra ha roto la economía de las GPU en la nube. En Amazon o Vast.ai, alquilar una V100 cuesta 0,40-0,80 dólares por hora, es decir, 300-600 al mes. Si compras dos V100 y montas un servidor por 200.000 rublos, se amortiza en seis meses. El autor de la prueba compró justo eso y probó 128 redes neuronales distintas, desde LLM pequeños hasta generadores de vídeo. Este es el resultado.
¿Por qué la V100 es tan barata?
La Tesla V100 es una tarjeta profesional para centros de datos, lanzada en 2017. Tiene 32 GB de memoria, 235 TFLOPS en media precisión y un TDP de 125 W. Se fabricó en cantidades enormes y después llegó la A100. Las granjas en la nube liquidaron sus V100 antiguas por casi nada. Mineros particulares y startups compraron el resto. Ahora el mercado de segunda mano está inundado de estas tarjetas y el precio ha caído aún más. El chip está anticuado en capacidad bruta, pero para inferencia es ideal.
¿Dónde tropieza la V100?
Seamos honestos: la V100 flaquea con TensorFlow (su optimización de cálculos limitados por CPU es débil). La generación de vídeo con Flux.1 tarda cinco minutos, y esperar sería desesperante. Genera texto con soltura, pero no con rapidez: Llama 2 70B produce 80 tokens por segundo en int4. A modo de comparación, una A100 en la nube ofrece más de 300. También hay matices con la memoria: 32 GB bastan para la mayoría de modelos, pero no se pueden ejecutar a la vez dos modelos de 70.000 millones de parámetros.
Benchmarks reales
- Mistral 7B: 200 tokens/s (int4)
- Llama 2 70B: 80 tokens/s (int4)
- Stable Diffusion 1.5: 0,8 segundos por imagen
- Stable Diffusion XL: 2,5 segundos
- Whisper Large: 0,3 de tiempo real (un audio de 60 minutos en 18 minutos)
- Flux.1: 300 segundos a 1024×1024
Economía: ¿nube o hardware propio?
Las GPU en la nube (Lambda, Vast.ai) cuestan 0,40-0,80 $/hora por una V100. El alquiler mensual es de 300-600 dólares. Nuestro servidor se amortiza en 4-6 meses de uso. Ventajas de lo local: la electricidad es más barata que el tráfico hacia la nube, control total y cero latencia. Inconvenientes: la responsabilidad sobre el hardware, la refrigeración y las actualizaciones recae por completo en ti.
Qué significa
Un servidor de IA local no sustituye a la nube, sino que la complementa. Si ejecutas modelos a diario, ya has probado tu idea y sabes qué redes neuronales necesitas, un servidor de 200.000 rublos ahorra decenas de miles al año y te da el control final sobre tu infraestructura.
- 1 nov 2026La capa de seguridad MoneyGate frenó las 42 peticiones fraudulentas a IA locales
- 31 oct 2026KTMS 1.0, el gateway LLM open source, conecta GPU propias a la nube y resiste fallos de dependencias
- 31 oct 2026LTX-2.5, de 22.000 millones de parámetros, funciona en una RTX 3080 de 10 GB, pero tarda 5 minutos por plano
- 29 oct 2026T-Tech desarrolla LIMe, un método que entrena modelos de lenguaje con un 15% menos de cómputo
Preguntas frecuentes sobre la noticia
¿Por qué la V100 es tan barata?
La Tesla V100 es una tarjeta profesional para centros de datos, lanzada en 2017. Tiene 32 GB de memoria, 235 TFLOPS en media precisión y un TDP de 125 W. Se fabricó en cantidades enormes y después llegó la A100. Las granjas en la nube liquidaron sus V100 antiguas por casi nada. Mineros particulares y startups compraron el resto. Ahora el mercado de segunda mano está inundado de estas tarjetas y el precio ha caído aún más. El chip está anticuado en capacidad bruta, pero para inferencia es ideal.
¿Dónde tropieza la V100?
Seamos honestos: la V100 flaquea con TensorFlow (su optimización de cálculos limitados por CPU es débil). La generación de vídeo con Flux.1 tarda cinco minutos, y esperar sería desesperante. Genera texto con soltura, pero no con rapidez: Llama 2 70B produce 80 tokens por segundo en int4. A modo de comparación, una A100 en la nube ofrece más de 300. También hay matices con la memoria: 32 GB bastan para la mayoría de modelos, pero no se pueden ejecutar a la vez dos modelos de 70.000 millones de parámetros.
Economía: ¿nube o hardware propio?
Las GPU en la nube (Lambda, Vast.ai) cuestan 0,40-0,80 $/hora por una V100. El alquiler mensual es de 300-600 dólares. Nuestro servidor se amortiza en 4-6 meses de uso. Ventajas de lo local: la electricidad es más barata que el tráfico hacia la nube, control total y cero latencia. Inconvenientes: la responsabilidad sobre el hardware, la refrigeración y las actualizaciones recae por completo en ti.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.