Cuando los datos antiguos hacen descarrilar el despliegue de IA: riesgos y soluciones
Las empresas se apresuran a usar datos antiguos al desplegar sistemas de IA. Los archivos que parecían polvo de almacén se han convertido de pronto en oro para entrenar modelos. El problema es que nadie ha revisado los riesgos de seguridad y las vulnerabilidades ocultos en ellos. El resultado: la adopción de la IA se atasca cuando los auditores encuentran problemas en los datos.
Procesado por IA desde ZDNet AI; editado por Hamidun News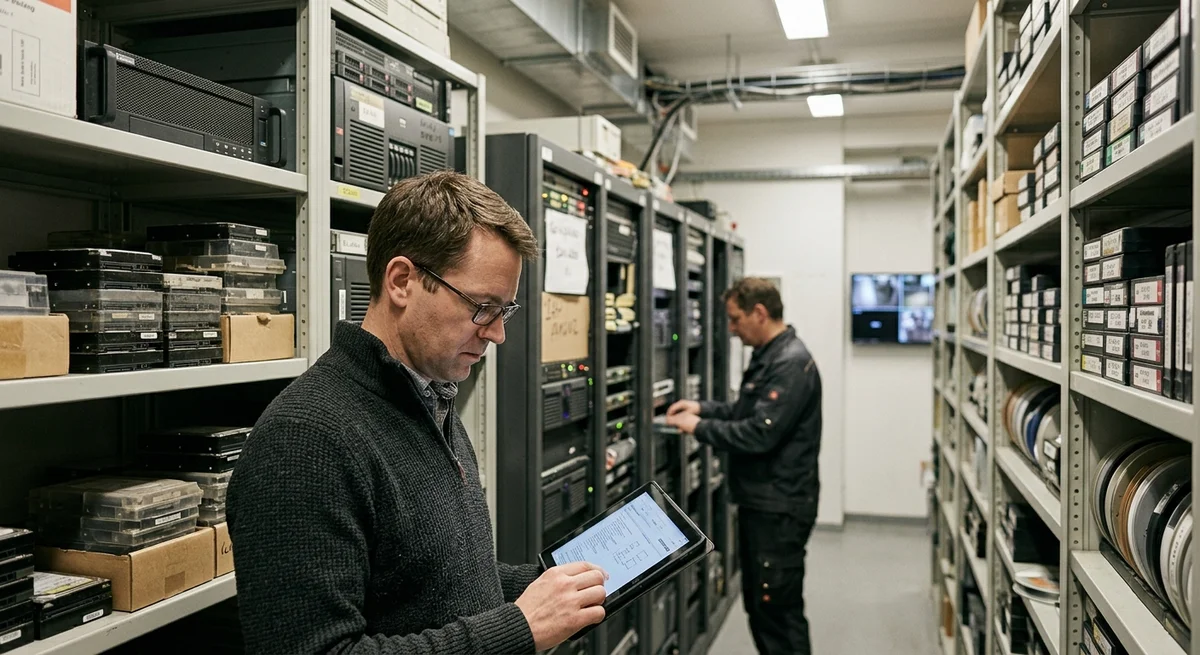
Las empresas tienen prisa por desplegar sistemas de IA y, con las prisas, cogen para entrenar sus modelos todos los datos disponibles, incluidos archivos de varios años o incluso más antiguos. Y allí les esperan muchas sorpresas desagradables que pueden hundir todo el proyecto en la recta final.
Por qué los datos antiguos se han vuelto de repente oro
Hasta hace poco, las empresas guardaban los datos históricos sin más, bajo el principio de «quizá algún día sirvan». Pero con la explosión de la IA, esos archivos se han convertido de golpe en un recurso valioso. Los modelos necesitan datos en cantidades enormes, y los archivos ya contienen millones de registros. ¿Para qué pasar años recopilando datos nuevos si la base histórica ya está lista?
Además, los datos antiguos suelen reflejar patrones a largo plazo: tendencias que se repiten año tras año y excepciones que enseñan al modelo a manejar bien los casos límite (edge cases). Eso acorta el desarrollo y reduce el coste de recopilar datos nuevos.
La lógica resulta atractiva, pero los datos archivados de hace 5–10 años nunca se han revisado con los estándares actuales de seguridad y privacidad.
Riesgos ocultos en los archivos
Cuando los auditores examinan a fondo los datos antiguos, encuentran:
- Nombres completos, números de documentos y números de seguridad social en texto plano
- Registros de empleados despedidos hace 5 años que no se borraron de la base de datos
- Contraseñas, claves de API y tokens registrados en su día en texto plano
- Datos de personas de otros países, lo que infringe el GDPR y leyes locales
- Datos mal etiquetados: transacciones clasificadas incorrectamente y errores en las etiquetas
- Registros duplicados y contradictorios que enseñan ruido al modelo en lugar de señal
Cuando se despliega un modelo así, los reguladores y los abogados detectan enseguida los problemas. Todo el trabajo se congela. Hay que rehacer la preparación de los datos, reentrenar el modelo y repetir las comprobaciones. Un proyecto que debía durar 3 meses se alarga un año.
Cómo gestionar el riesgo en la práctica
Hay un camino sencillo: pasar por tres etapas antes de usar datos antiguos.
La primera es una auditoría de seguridad completa del archivo. ¿Quién creó los datos, con qué fines y cuándo? ¿Contienen información confidencial? ¿Cumplen los estándares actuales?
La segunda etapa es la limpieza. Eliminar los registros de las personas que ya no aceptan la reutilización, retirar la información sensible y corregir los errores de etiquetado.
La tercera etapa es la documentación: de dónde salieron los datos, cuánto tiempo se tardó en recopilarlos, quién los etiquetó y qué supuestos llevan incorporados.
Las empresas suelen saltarse estos tres pasos con las prisas y lo
pagan con retrasos de meses y repetición del trabajo.
Qué significa esto
Desplegar IA no es solo una cuestión de ingeniería y algoritmos. Es gestionar los datos como un activo. Los datos antiguos exigen el mismo cuidado (o más) en seguridad y calidad que los nuevos. Las prisas en el despliegue casi siempre salen más caras que el tiempo dedicado a la preparación y la verificación.
Preguntas frecuentes sobre la noticia
¿Qué se sabe sobre Por qué los datos antiguos se han vuelto de repente oro?
Hasta hace poco, las empresas guardaban los datos históricos sin más, bajo el principio de «quizá algún día sirvan». Pero con la explosión de la IA, esos archivos se han convertido de golpe en un recurso valioso. Los modelos necesitan datos en cantidades enormes, y los archivos ya contienen millones de registros. ¿Para qué pasar años recopilando datos nuevos si la base histórica ya está lista? Además, los datos antiguos suelen reflejar patrones a largo plazo: tendencias que se repiten año tras año y excepciones que enseñan al modelo a manejar bien los casos límite (edge cas
¿Qué se sabe sobre Riesgos ocultos en los archivos?
Cuando los auditores examinan a fondo los datos antiguos, encuentran: Nombres completos, números de documentos y números de seguridad social en texto plano Registros de empleados despedidos hace 5 años que no se borraron de la base de datos Contraseñas, claves de API y tokens registrados en su día en texto plano Datos de personas de otros países, lo que infringe el GDPR y leyes locales Datos mal etiquetados: transacciones clasificadas incorrectamente y errores en las etiquetas Registros duplicados y contradictorios que enseñan ruido al modelo en lugar de señal Cuando se des
Cómo gestionar el riesgo en la práctica?
Hay un camino sencillo: pasar por tres etapas antes de usar datos antiguos. La primera es una auditoría de seguridad completa del archivo. ¿Quién creó los datos, con qué fines y cuándo? ¿Contienen información confidencial? ¿Cumplen los estándares actuales? La segunda etapa es la limpieza. Eliminar los registros de las personas que ya no aceptan la reutilización, retirar la información sensible y corregir los errores de etiquetado. La tercera etapa es la documentación: de dónde salieron los datos, cuánto tiempo se tardó en recopilarlos, quién los etiquetó y qué supuestos lle
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.