Mistral lanza Search Toolkit para la búsqueda en aplicaciones de IA
Mistral AI ha lanzado Search Toolkit, un framework para búsqueda en producción dentro de aplicaciones de IA. Reúne ingestion, retrieval y evaluation bajo una interfaz unificada. Es open source y funciona en cualquier entorno: nube, on-premises y edge. La idea de fondo es que los equipos dedican semanas a integrar herramientas en lugar de mejorar la calidad de la búsqueda.
Procesado por IA desde Mistral AI News; editado por Hamidun News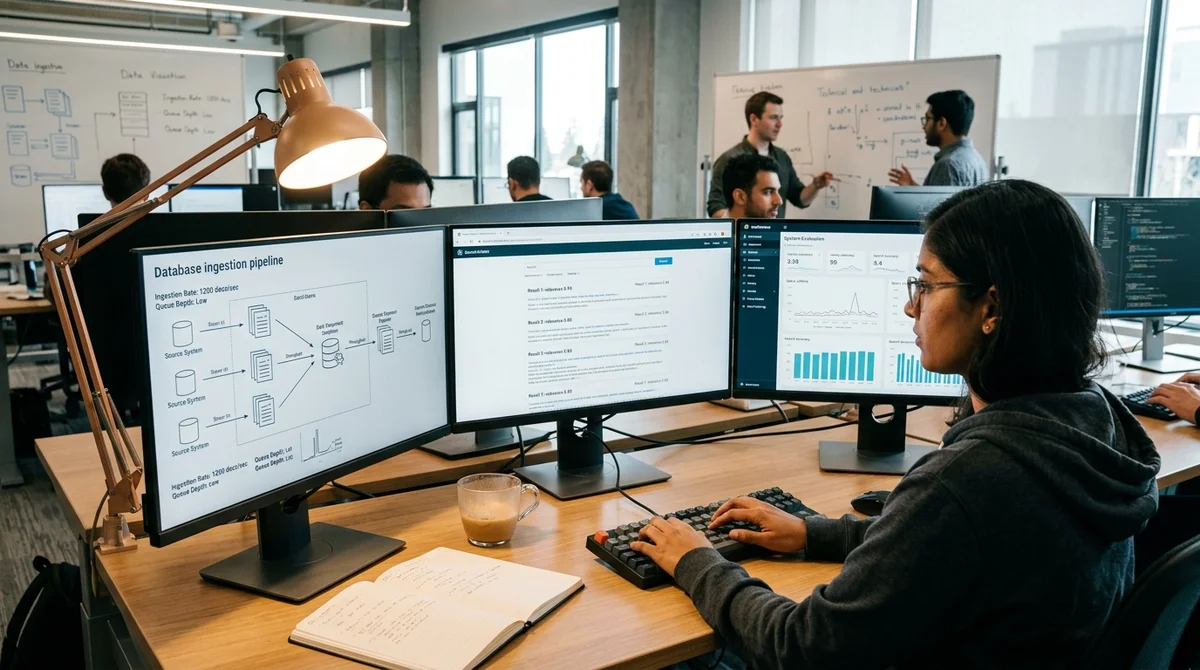
Mistral AI ha lanzado Search Toolkit, un framework abierto para construir pipelines de búsqueda en producción dentro de aplicaciones de IA. La herramienta reúne ingestion, retrieval y evaluation en una sola interfaz para que los equipos puedan centrarse en la calidad de la búsqueda en lugar de integrar servicios distintos. Funciona en cualquier entorno: en la nube, on-premises y en dispositivos edge.
El problema: integrar en lugar de mejorar
Hoy, los equipos que construyen sistemas de búsqueda pierden demasiado tiempo en la «fontanería». Necesitan una herramienta para cargar los datos (ingestion), otra para buscar (retrieval) y una tercera para evaluar los resultados (evaluation). Cada una tiene su propia interfaz y sus propias suposiciones sobre el formato de los datos. El resultado: los equipos pasan semanas montando la integración antes de lanzar siquiera la primera búsqueda sobre sus datos.
El problema se complica a nivel enterprise, cuando una corporación busca en una docena de fuentes a la vez: wikis internas, sistemas de soporte, repositorios de documentos, file storage y bases de código. Cada fuente tiene una estructura diferente y exige su propia lógica de parsing. Los equipos o bien construyen un pipeline independiente para cada fuente, o bien escriben una frágil capa de unificación que acaba siendo una pesadilla de mantener.
Search Toolkit cambia este enfoque: un único framework con una interfaz unificada para las tres etapas.
Cómo funciona en la práctica
El framework está diseñado para tres casos de uso principales:
- Enterprise search: las organizaciones pueden añadir nuevas fuentes sin reconstruir todo el pipeline. Los mismos patrones de procesamiento e indexación sirven para distintos tipos de fuentes.
- RAG y calidad del retrieval: cuando un sistema RAG devuelve malos resultados, no está claro dónde está el problema, si en el retrieval o en la generación. Los equipos suelen cambiar prompts y estrategias de chunking a ciegas. Search Toolkit incluye evaluación integrada para medir la calidad del retriever con independencia del modelo.
- Búsqueda especializada: los documentos jurídicos, los historiales médicos, los informes financieros y las bases de código requieren estrategias distintas a las del web search. Los retrievers off-the-shelf no se desenvuelven bien con la terminología especializada ni con criterios de relevancia propios. Hasta ahora, las empresas construían su infraestructura de retrieval a medida desde cero, algo caro y difícil de mantener.
Agentes y datos en vivo
Los agentes que trabajan en tareas corporativas necesitan acceso al contexto de toda la organización. Toman decisiones de búsqueda de forma autónoma y a gran escala, así que la calidad de la infraestructura de búsqueda que tienen debajo afecta a cada paso downstream.
Search Toolkit permite a los agentes hacer búsqueda semántica sobre índices para obtener resultados precisos con baja latency. Al mismo tiempo, a través de Connectors, los agentes pueden traer datos en vivo directamente desde las fuentes.
Qué significa
Search Toolkit quita de en medio buena parte del trabajo de ingeniería. En lugar de pasar semanas integrando herramientas distintas, los equipos empiezan directamente a construir sistemas de búsqueda. Para las empresas que implantan RAG y agentes de IA en sus sistemas internos (conocimiento, RR. HH., finanzas, soporte técnico), esto se traduce en un go-to-production más rápido y más tiempo para lo que de verdad importa: la calidad de los resultados de búsqueda.
- 1 nov 2026Prueba de 16 modelos en 7 buscadores: Exa obtuvo una media de 10,5 puntos de 14; SearXNG, en torno a 3
- 30 oct 2026Mistral abre los pesos de Large 4: destaca en código, pero los modelos chinos logran 32 puntos frente a 26
- 30 oct 2026Claude Enterprise estrena informes inteligentes: quién usa la IA y cuánto cuesta
- 30 oct 2026SkyRL y vLLM ajustan Mistral Large 4 con RL: AIME sube del 64% al 75%
Preguntas frecuentes sobre la noticia
¿Qué se sabe sobre El problema: integrar en lugar de mejorar?
Hoy, los equipos que construyen sistemas de búsqueda pierden demasiado tiempo en la «fontanería». Necesitan una herramienta para cargar los datos (ingestion), otra para buscar (retrieval) y una tercera para evaluar los resultados (evaluation). Cada una tiene su propia interfaz y sus propias suposiciones sobre el formato de los datos. El resultado: los equipos pasan semanas montando la integración antes de lanzar siquiera la primera búsqueda sobre sus datos. El problema se complica a nivel enterprise, cuando una corporación busca en una docena de fuentes a la vez: wikis inte
Cómo funciona en la práctica?
El framework está diseñado para tres casos de uso principales: Enterprise search: las organizaciones pueden añadir nuevas fuentes sin reconstruir todo el pipeline. Los mismos patrones de procesamiento e indexación sirven para distintos tipos de fuentes. RAG y calidad del retrieval: cuando un sistema RAG devuelve malos resultados, no está claro dónde está el problema, si en el retrieval o en la generación. Los equipos suelen cambiar prompts y estrategias de chunking a ciegas. Search Toolkit incluye evaluación integrada para medir la calidad del retriever con independencia de
¿Qué se sabe sobre Agentes y datos en vivo?
Los agentes que trabajan en tareas corporativas necesitan acceso al contexto de toda la organización. Toman decisiones de búsqueda de forma autónoma y a gran escala, así que la calidad de la infraestructura de búsqueda que tienen debajo afecta a cada paso downstream. Search Toolkit permite a los agentes hacer búsqueda semántica sobre índices para obtener resultados precisos con baja latency. Al mismo tiempo, a través de Connectors, los agentes pueden traer datos en vivo directamente desde las fuentes.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.