Machine Learning Mastery تشرح كيفية بناء RAG طويل السياق دون إهدار الرموز
نشر موقع Machine Learning Mastery تحليلاً عملياً حول RAG طويل السياق. فحتى النماذج ذات نوافذ السياق الضخمة تبقى أمامها مشكلتان: تأثير Lost in the Middle وارتفاع تكلفة المعالجة. يقترح المقال خمس تقنيات عملية، من إعادة الترتيب (reranking) والتخزين المؤقت للسياق (context caching) إلى البحث الهجين وتوسيع الاستعلام (query expansion)، بهدف رفع دقة الإجابات وجعل خط المعالجة أرخص وأسرع.
معالج بواسطة الذكاء الاصطناعي من Machine Learning Mastery؛ بتحرير Hamidun News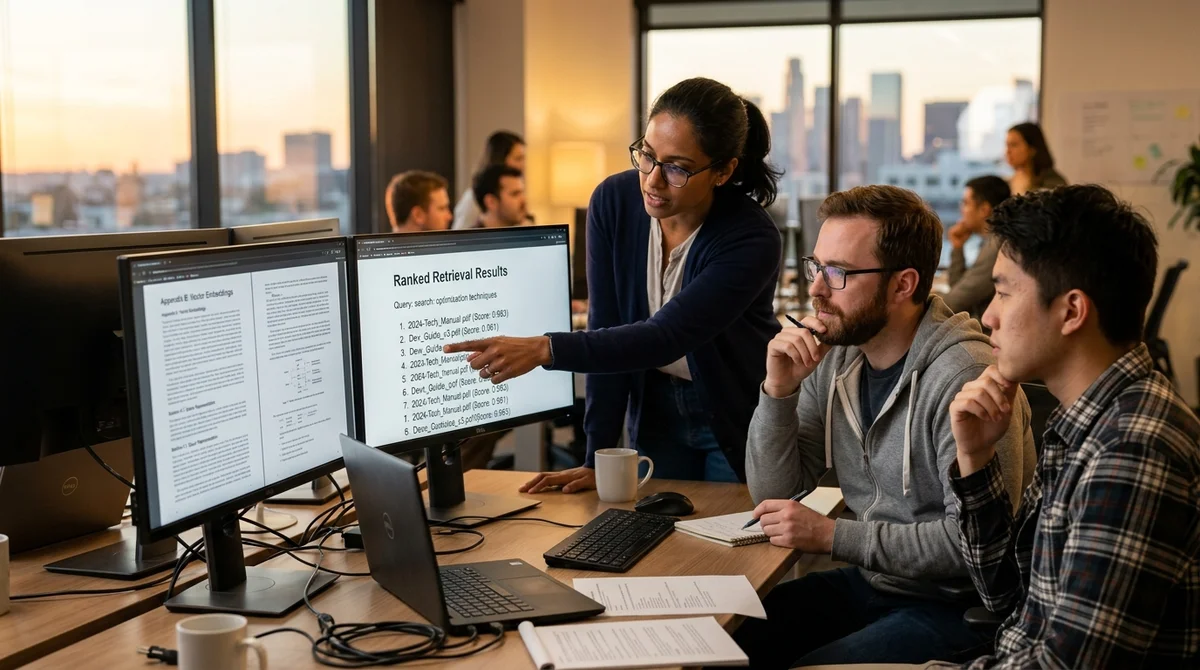
في 15 أبريل 2026 نشر موقع Machine Learning Mastery تحليلاً عملياً حول كيفية بناء RAG طويل السياق دون إهدار الرموز (tokens) ودون تراجع في جودة الإجابات. والخلاصة الرئيسية للمقال بسيطة: حتى النماذج التي تبلغ نوافذ سياقها مئات الآلاف وملايين الرموز لا تُلغي الحاجة إلى RAG، بل تفرض إعادة بناء بنيته.
لماذا لا يحل السياق الطويل المشكلة
حتى وقت قريب كانت النصيحة المعتادة لـ RAG هي تقسيم المستندات إلى مقاطع صغيرة، وتحويلها إلى تضمينات (embeddings)، ثم استخراج أكثر المقاطع صلة. وقد فرضت هذا النهج قيود النماذج اللغوية الكبيرة (LLM) نفسها: كان السياق مكلفاً وينفد بسرعة.
أما اليوم فقد توفرت للمطورين نماذج بنوافذ تصل إلى مليون رمز، والإغراء واضح: تحميل اللائحة كاملة أو جميع التعليمات أو قاعدة المعرفة بأكملها في الموجّه (prompt). لكن هذا النهج يصطدم عملياً بمشكلتين سريعاً.
الأولى هي تأثير Lost in the Middle، إذ يلاحظ النموذج المعلومات المهمة بدرجة أقل حين تكون مدفونة في منتصف سياق طويل. والثانية هي التكلفة: فتمرير مصفوفة نصية ضخمة عبر النموذج مع كل طلب عملية بطيئة ومكلفة.
ونتيجة لذلك، لا يعود RAG طويل السياق مسألة «كيف نحشر أكبر قدر من النص»، بل مسألة «كيف نمنح النموذج بالضبط السياق الذي سينتبه إليه فعلاً».
خمس تقنيات عملية
لا تقترح Machine Learning Mastery حلاً سحرياً واحداً، بل مجموعة من الأساليب العملية التي يمكن الجمع بينها في خط معالجة واحد. الفكرة ليست البحث عن المستندات فحسب، بل التحكم في ترتيب السياق وحجمه وطريقة تقديمه إلى النموذج. وهذا تحول ملحوظ عن نهج RAG القديم، حيث كانت المقاطع المسترجعة تُرسل إلى الموجّه شبه تلقائياً بعد الاسترجاع (retrieval)، دون منطق إضافي في كل خطوة ودون رقابة على الجودة.
- إعادة الترتيب بعد الاسترجاع (Reranking) — جلب مجموعة موسّعة من المرشحين أولاً، ثم إعادة ترتيبها بنموذج منفصل.
- التخزين المؤقت للسياق (Context caching) — تحميل المستند الكبير في الذاكرة المؤقتة مرة واحدة، ثم تمرير السؤال ومرجع هذا السياق فقط إلى النموذج.
- التقطيع الديناميكي مع مرشحات البيانات الوصفية (Dynamic chunking + metadata filters) — تقسيم المستندات إلى كتل ذات معنى وتصفيتها بحسب الأقسام والتواريخ والصفحات وغيرها من البيانات الوصفية.
- الاسترجاع الهجين (Hybrid retrieval) — الجمع بين البحث الدلالي والبحث الدقيق بالكلمات المفتاحية كي لا تضيع التطابقات الحرفية في الاستعلامات التقنية.
- توسيع الاستعلام (Query expansion) — إثراء السؤال الأصلي بصياغات إضافية إذا طرحه المستخدم بشكل عام جداً أو بلغة محكية.
أهم ما في المقال ليس القائمة بحد ذاتها، بل الطريقة التي ترتبط بها هذه التقنيات. فعلى سبيل المثال، يوصي المقال بجلب نحو 20 مرشحاً من قاعدة البيانات المتجهية بدلاً من أعلى 5، ثم تمريرهم عبر نموذج إعادة الترتيب (reranker)، وبعد ذلك وضع أفضل المستندات في الموجّه بشكل مدروس: الأكثر صلة في البداية، والثاني في الأهمية في النهاية، والبقية بينهما. وبهذا لا يتصارع المطور مع حدود انتباه النموذج، بل يتكيف معها.
كيف يتغير خط المعالجة
يُظهر المقال بوضوح أن RAG الحديث للسياق الطويل بات أقرب إلى هندسة البحث منه إلى نهج «استرجع وألقِ» (retrieve-and-dump) البسيط. فإذا كانت لديك قاعدة معرفة ثابتة، مثل دليل ضخم أو لائحة داخلية، فإن التخزين المؤقت للسياق يلغي إعادة معالجة مئات الآلاف من الرموز ويخفض التأخير بشكل ملحوظ. وهذا مفيد بوجه خاص لروبوتات الدعم والمساعدين الداخليين الذين يجيبون مراراً وتكراراً استناداً إلى مجموعة المستندات نفسها.
طبقة أخرى مهمة هي البيانات الوصفية والبحث الهجين. فالاسترجاع الدلالي يفهم المعنى جيداً، لكنه قد يفوّت الاسم الدقيق لمعامل ما أو رمز خطأ أو رقم قسم. أما البحث بالكلمات المفتاحية فيلتقط التطابقات الحرفية. لذلك ينصح المؤلف بدمج القناتين وتوحيد نتائجهما عبر دمج الترتيب (rank fusion). وفوق ذلك تُضاف تصفية بحسب بنية المستند: تُستبعد أولاً الأقسام أو التواريخ أو الصفحات غير اللازمة، ثم يبدأ البحث بالتشابه (similarity search). وهذا يقلل الضوضاء ويجعل السياق النهائي أنقى بوضوح.
وأخيراً، يفيد توسيع الاستعلام حين يصوغ المستخدم سؤاله بطريقة تختلف عن طريقة تدوين المعلومات في المستندات. فإذا سأل شخص «ماذا أفعل إذا انطلق إنذار الحريق»، يمكن للنظام أن يولّد صيغاً إضافية مثل «ترتيب الإخلاء» أو «نقطة التجمع» أو «مخرج الطوارئ». وبفضل ذلك لا يعثر الاسترجاع على التطابقات المباشرة فحسب، بل على التعليمات القريبة في المعنى أيضاً. وهذا ذو قيمة خاصة لمعارف الشركات ووثائق الامتثال (compliance) والوثائق التقنية.
ماذا يعني ذلك
يرصد مقال Machine Learning Mastery تحولاً مهماً: النماذج طويلة السياق لم تقضِ على RAG، بل جعلته أكثر نضجاً. فالفائز اليوم ليس الفرق التي تحمّل الموجّه بأقصى قدر من النص، بل تلك التي تُحسن ترتيب السياق وتصفيته وتخزينه مؤقتاً وإعادة استخدامه.
وبالنسبة لفرق المنتجات، يعني ذلك إنفاقاً أقل على الرموز، وتأخيراً أقل، وإجابات أكثر قابلية للتنبؤ على مجموعات المستندات الطويلة. وهذا بالضبط ما يتحول إلى المعيار الجديد لمساعدي الذكاء الاصطناعي في الشركات.
Access Frontier LLMs & Multimodal AI in One Workspace
Discover NomadNet AI (nomadnet.ai) — unified access to frontier language models, research synthesis, and multimodal workflows.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.