AWS تشرح كيفية ضبط Amazon Nova عبر «LLM قاضٍ» للمهام المؤسسية المعقدة
عرضت AWS كيفية استخدام نهج LLM-as-a-judge في الضبط الدقيق بالتعلّم المعزَّز (reinforcement fine-tuning) لنماذج Amazon Nova. فبدلًا من الترميز اليدوي، يمنح نموذج منفصل المكافآت وفق معايير الدقة والصلة بالموضوع والأمان، وتُبنى دالة المكافأة عبر Lambda وBedrock. وفي حالة توضيحية لمراجعة العقود، حقق Nova 2 Lite بعد RFT 4,33 نقطة، وتفوّق على Claude Sonnet 4.5، وحافظ على تحقق مثالي من مخطط JSON.
معالج بواسطة الذكاء الاصطناعي من AWS Machine Learning Blog؛ بتحرير Hamidun News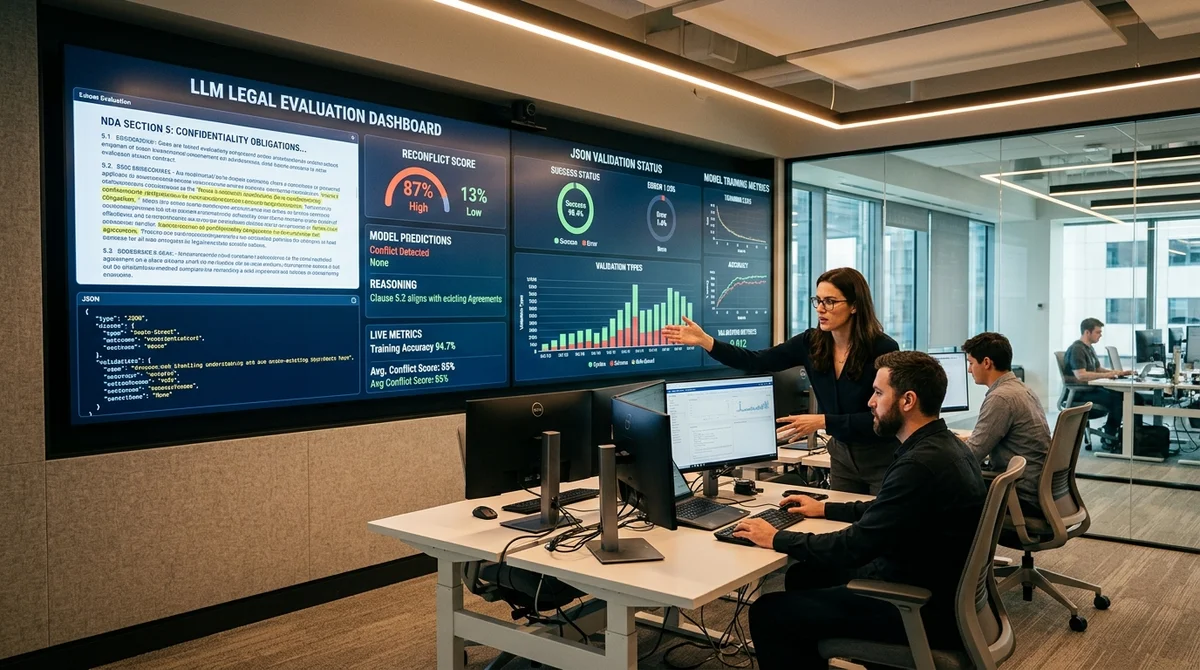
قدّمت AWS شرحًا مفصّلًا لكيفية تطبيق الضبط الدقيق بالتعلّم المعزَّز (reinforcement fine-tuning) مع نهج LLM-as-a-judge على نماذج Amazon Nova. فبدلًا من الترميز اليدوي أو مجموعة من القواعد الصارمة، يقيّم نموذج لغوي منفصل جودة الإجابة، ويتحوّل حكمه إلى إشارة مكافأة (reward) تُستخدم في التدريب.
لماذا نحتاج إلى «قاضٍ»
وفق AWS، يمكن بناء RFT التقليدي إما على قواعد قابلة للتحقق، مثل المطابقة التامة للسلسلة النصية، وإما على مخطط يقيّم فيه نموذج لغوي آخر الإجابة وفق عدة معايير في آنٍ واحد. ويلزم الخيار الثاني حيث لا يمكن اختزال الجودة في صيغة واحدة.
ففي المهام المؤسسية لا تقتصر الأهمية على الدقة الواقعية، بل تشمل النبرة والأمان والشمولية والصلة بالموضوع والالتزام بالسياسات الداخلية. وفي هذا النهج لا يكتفي نموذج القاضي بمنح درجة، بل يساعد أيضًا على فهم سبب تفوّق إجابة على أخرى.
وتؤكد AWS أن هذا المخطط يسرّع دورات التكرار: إذ يرى الفريق بدقة أين يخفق النموذج، ويستطيع تعديل دالة المكافأة بسرعة أكبر. وهذا مفيد خصوصًا في المجالات التي لا يظهر فيها الخطأ كعطل واضح، بل يتجلى في دقائق الصياغة أو في خطر مُغفَل أو في حجة ضعيفة.
ست خطوات للإعداد
تقسّم AWS تطبيق LLM-as-a-judge إلى عدة خطوات عملية. أولًا، يجب اختيار نوع التقييم: rubric-based، حيث يمنح القاضي درجة مطلقة لإجابة واحدة، أو preference-based، حيث يقارن بين نسختين ويختار الأفضل. وإذا لم تتوافر تفضيلات جاهزة، تنصح الشركة بالبدء بنهج rubric ومعايير بسيطة من نوع pass/fail بدلًا من مقياس من 1 إلى 10.
- اختيار نمط التحكيم: التقييم المطلق أو المقارنة الثنائية
- صياغة معايير الجودة بوضوح مع علامات يمكن ملاحظتها
- اختيار نموذج القاضي (judge) بما يناسب المجال والميزانية عبر Amazon Bedrock
- اشتراط إجابة JSON منظَّمة ليسهل تحليل المكافأة بموثوقية
- ربط دالة المكافأة بمقاييس بيئة الإنتاج وإضافة غلاف Lambda متين
وتركّز AWS بشكل خاص على البنية التحتية. فهي تنصح بعدم الاعتماد على القاضي وحده، وبتعزيزه بفحوص حتمية سريعة: صلاحية JSON، وطول الإجابة، وتطابق اللغة، ومرشّحات الأمان (safety). ويجب أن تتحمّل Reward Lambda نفسها آلاف التقييمات في كل خطوة تدريب، ولذلك يوصى باستخدام exponential backoff لاستدعاءات Bedrock، والتوازي عبر ThreadPoolExecutor أو أنماط async، ومهلة تصل إلى 15 دقيقة، وprovisioned concurrency بنحو 100 في الإعدادات النموذجية. وإذا تعطّل القاضي أو الـ API، فالأفضل إرجاع مكافأة محايدة بدلًا من إفشال خطوة التدريب بأكملها. كما يُنصح بالاحتفاظ بمجموعة اختبارات انحدار (regression) لمسار القاضي نفسه.
حالة العقود
وكعرض توضيحي، تصف AWS مشروعًا مع شريك من قطاع الخدمات القانونية. تتمثل المهمة في تحليل العقود الجديدة تلقائيًا، ومقارنتها بالقواعد الداخلية والعقود السابقة ومتطلبات التشريعات، ثم إنتاج JSON يتضمن التعليقات وأنواع الملاحظات والإجراءات الموصى بها.
كانت مجموعة البيانات الأصلية صغيرة وتضم عقودًا رمّزها خبراء، لذا لم يحقق الضبط الدقيق الخاضع للإشراف (supervised fine-tuning) التقليدي سوى أثر محدود. وفي RFT استُخدم نموذج قاضٍ منفصل هو GPT OSS 120B مع system prompt مخصّص. وكان القاضي يتحقق مما إذا كان التعليق يستند فعلًا إلى مقطع من العقد نفسه، وهل يتسق مع المستند المرجعي، وهل يمكن اتخاذ إجراء بناءً عليه. ثم غُلّف ذلك في دالة Lambda، وبدأ التدريب عبر Nova Forge SDK مع عدة توليدات لكل مثال وحدّ للاستدعاءات المتزامنة قدره 100.
ونتيجة لذلك، حصل Amazon Nova 2 Lite بعد RFT على درجة إجمالية 4,33 من 5 وعلى تحقق مثالي من مخطط JSON، متفوقًا على Claude Sonnet 4.5 وClaude Haiku 4.5. وتذكر AWS صراحةً أن نسخ SFT ظهرت فيها عيوب مثل التعليقات المكررة ورموز Unicode الغريبة، بينما خلت نقاط RFT (checkpoints) من ذلك. والأهم أن النموذج حافظ على نتائج جيدة حتى بعد تغيير judge prompt، أي أنه تعلّم أنماط جودة أعمّ، لا صيغة تقييم بعينها.
كما ذُكر العيب بوضوح: فقد تطلّب RFT ما بين 4 و8 rollouts لكل مثال تدريبي، وكانت كلفته الحسابية أعلى.
ماذا يعني ذلك
تروّج AWS عمليًا لـ RFT مع LLM-as-a-judge بوصفه مسارًا عمليًا لتكييف النماذج مع السيناريوهات المؤسسية الحساسة، حيث لا تكفي القواعد البسيطة ويكون الترميز اليدوي باهظ الكلفة. وإذا كان نهج Amazon Nova قابلًا فعلًا للانتقال إلى بيئة الإنتاج، فستحصل شركات القطاع القانوني والمالي والرعاية الصحية على طريقة لضبط النماذج وفق معاييرها الخاصة، مع تحكّم أفضل في صيغة الإجابة وجودتها وقابليتها للتفسير.
Access Frontier LLMs & Multimodal AI in One Workspace
Discover NomadNet AI (nomadnet.ai) — unified access to frontier language models, research synthesis, and multimodal workflows.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.