Google DeepMind تكيّف Perch 2.0: نموذج تدرّب على تغريد الطيور يتعرّف على نداءات الحيتان
اكتشفت Google DeepMind استخدامًا غير متوقع لنموذج Perch 2.0: فالنموذج الذي تدرّب على تغريد الطيور يتعرّف بثقة أيضًا على إشارات الحيتان. وفي اختبارات على ثلاث مجموعات بيانات بحرية، كفته بضعة أمثلة فقط لتحقيق نتيجة عالية. وقد يسرّع هذا النقل للتعلّم مراقبة الأعداد النادرة من الحيتان، ويدعم العلوم البحرية، ويخفّض تكاليف بناء نماذج صوتية متخصصة جدًا. وتتمثل الفكرة في الاستفادة من نموذج أساسي جاهز بدلًا من بناء نظام جديد من الصفر لكل نوع من الحيوانات.
معالج بواسطة الذكاء الاصطناعي من IEEE Spectrum AI؛ بتحرير Hamidun News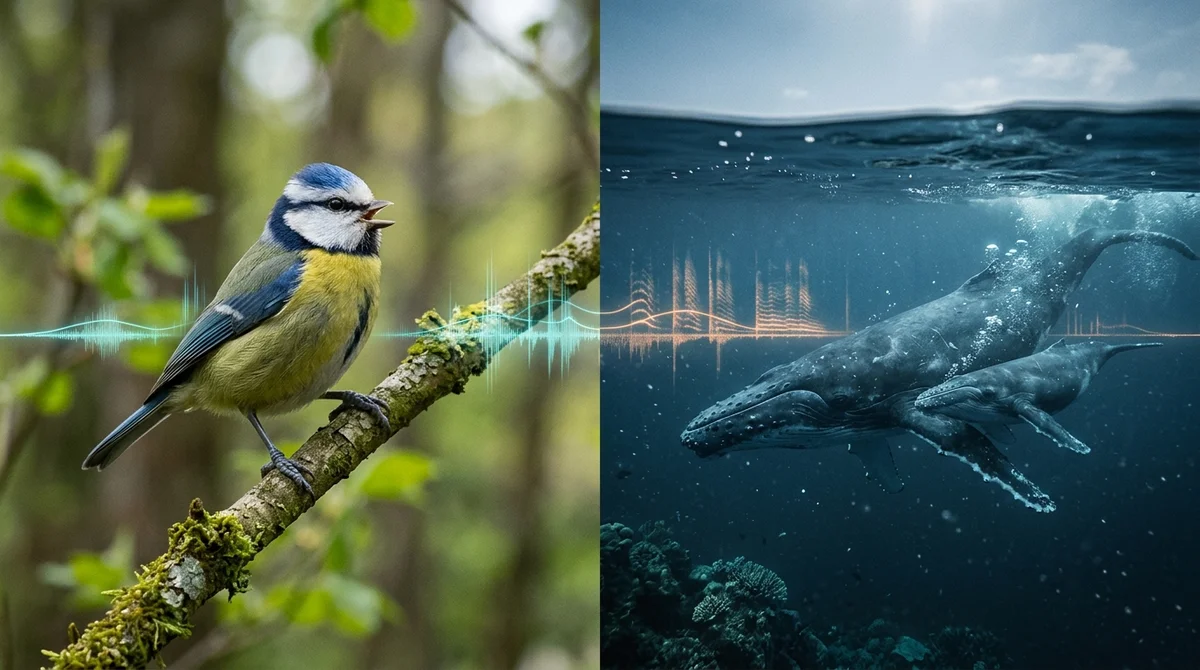
وجدت Google DeepMind طريقة غير متوقعة لدراسة المحيط: فنموذج Perch 2.0، الذي أُنشئ للتعرّف على تغريد الطيور وغيرها من الحيوانات البرية، يتعامل بثقة أيضًا مع أصوات الحيتان. وقد يختصر هذا الوقت اللازم لتطوير نماذج بحرية مستقلة، ويسرّع المراقبة الصوتية للأعداد النادرة.
كيف اختُبر النموذج
Perch 2.0 هو نموذج أساسي في الصوتيات الحيوية، تدرّب على ملايين التسجيلات للطيور والبرمائيات والحشرات والثدييات. ولم يُصمَّم في الأصل للمحيط، بل لتحليل المشاهد الصوتية البرية. لكن Google DeepMind وGoogle Research قررتا اختبار ما إذا كان بالإمكان إعادة استخدام أساس جاهز مع الحيتان، بدلًا من بناء نظام جديد من الصفر.
والمنطق بسيط: إذا كان النموذج الأساسي ينقل المعرفة بين أنواع مختلفة من الإشارات، فلن يضطر العلماء إلى إنفاق هذا القدر من الحوسبة والوقت على تطوير مستقل.
ولإجراء الاختبار، اعتمد الفريق ثلاث مجموعات بيانات صوتية بحرية تضم أصوات الحيتان وضوضاء أخرى تحت الماء. وحُوّل كل مقطع مدته خمس ثوانٍ إلى مخطط طيفي (spectrogram)، وهو خريطة مرئية لترددات الصوت وشدته عبر الزمن. ثم حوّل Perch 2.0 هذه البيانات إلى تمثيلات متجهية (embeddings)، أي مجموعات مدمجة من السمات يمكن بواسطتها التمييز، مثلًا، بين صفير الأوركا وإشارة الحوت الأحدب.
بعد ذلك درّب الباحثون مصنِّفًا لوجستيًا بسيطًا على أمثلة قليلة جدًا: من أربعة إلى 32 تمثيلًا متجهيًا لكل مجموعة بيانات. وحتى مع هذا العدد الضئيل من الأمثلة، جاءت الجودة عالية، وتحسّنت مع إضافة المزيد من البيانات.
لماذا نجح النقل
الفكرة المحورية هنا هي transfer learning، أي نقل التعلّم. يتعلّم النموذج أولًا استخلاص الأنماط الصوتية العامة من مجموعة ضخمة من بيانات معينة، ثم تُطبَّق هذه المعرفة على مهمة أخرى قريبة منها. وفي حالة Perch 2.0 يبدو النقل مفاجئًا بصفة خاصة: فالطيور تغرّد في الهواء، بينما تتبادل الحيتان الإشارات تحت الماء. غير أن النموذج، على ما يبدو، لا يلتقط وسط انتقال الصوت فحسب، بل أنماطًا أدق: شكل الصفير، وديناميكية الترددات، ومدة الإشارة وبنيتها الدقيقة.
«نحن ندرّب هذا النموذج على العثور على التفاصيل الصغيرة في المشاهد الصوتية».
ويقدّم الباحثون عدة تفسيرات في آن واحد. فقد تكون لدى الطيور والثدييات البحرية آليات متشابهة تطوريًا لإصدار الصوت. كما أن النماذج الكبيرة المدرَّبة على بيانات متنوعة تعمل غالبًا بشكل جيد خارج مجالها الأصلي. وأخيرًا، فإن التعرّف على أصوات الطيور صعب بحد ذاته، إذ يضطر النموذج إلى رصد أدق الفروق. ومن المرجح أن هذا ما يساعده تحت الماء. ووفق الفريق، تقع صفارات بعض مجموعات الأوركا حتى في نطاق مشابه من المخططات الطيفية لنطاق كثير من إشارات الطيور.
ما فائدة ذلك لعلماء الأحياء
بالنسبة لباحثي المحيطات، لا تقتصر أهمية هذه النتيجة على كونها عرضًا لافتًا. ففي الصوتيات الحيوية تُكتشف باستمرار أنواع جديدة من الإشارات، ولا تزال بعض الضوضاء تحت الماء بلا تصنيف موثوق على الإطلاق. وإذا أمكن، بدلًا من إنشاء نموذج منفصل لكل نوع، اعتماد نظام أساسي قوي وإعادة تدريب مصنِّف خفيف بسرعة، فإن دورة البحث تصبح أقصر بشكل ملحوظ. ويفيد ذلك خصوصًا في المراقبة الصوتية السلبية، حين يستمع العلماء شهورًا إلى كميات هائلة من التسجيلات الواردة من العوّامات والهيدروفونات والمحطات المستقلة.
- إطلاق أسرع لنماذج جديدة لمجموعات محددة من الحيتان
- تكاليف أقل للتدريب من الصفر ولتجريب البنى المختلفة
- العمل حتى مع عدد قليل جدًا من الأمثلة الموسومة
- بحث أكثر مرونة عن أنواع الإشارات النادرة وغير الموصوفة بعد
ومن المهم أيضًا أن Perch 2.0 لم تُقارَن بنموذج Google السابق للحيتان فحسب، بل بنماذج صوتية حيوية أخرى للطيور والحيوانات والشعاب المرجانية. وفي هذه المقارنة جاءت إما الأفضل أو الثانية من حيث الجودة. أي أن الأمر لا يتعلق باختبار ناجح بالصدفة، بل بنتيجة قوية في مواجهة بدائل متخصصة. وبالنسبة لمشاريع حماية الطبيعة، هذه إشارة جيدة: فأداة صوتية أساسية واحدة قد تعمل في عدة أنظمة بيئية في آن واحد.
ماذا يعني ذلك
تُظهر قصة Perch 2.0 أن نماذج AI الأساسية بدأت تقدّم فائدة لا لروبوتات الدردشة وتوليد المحتوى فحسب، بل للعلوم الميدانية أيضًا. فإذا كان نقل التعلّم يعمل بين الطيور والحيتان، تتاح لعلماء الأحياء فرصة لتتبّع حالة الأعداد بسرعة أكبر، ورصد التغيرات في سلوك الحيوانات، وحماية الأنواع الهشّة على نحو أفضل.
- 28 أكتوبر 2026شبكة CNN من عام 2015 تتفوق على GPT-6 Astra وClaude Fable 5.1 في تشخيص سرطان الجلد
- 28 أكتوبر 2026Google تعلّم نماذج LLM «النوم»: SLEEP يثبّت المعرفة في الأوزان، وحتى 10 ملايين توكن
- 28 أكتوبر 2026Keystone تُخرج اسم النموذج من الشيفرة: بوابة LLM مفتوحة المصدر تضيف 0.64 مللي ثانية فقط
- 28 أكتوبر 2026Wired تختبر 6 وكلاء ذكاء اصطناعي خلال يوم: Dots في الصدارة وGemini Spark يفشل في طلب الغداء
أسئلة وأجوبة حول الخبر
ما أبرز التفاصيل حول كيف اختُبر النموذج؟
Perch 2.0 هو نموذج أساسي في الصوتيات الحيوية، تدرّب على ملايين التسجيلات للطيور والبرمائيات والحشرات والثدييات. ولم يُصمَّم في الأصل للمحيط، بل لتحليل المشاهد الصوتية البرية. لكن Google DeepMind وGoogle Research قررتا اختبار ما إذا كان بالإمكان إعادة استخدام أساس جاهز مع الحيتان، بدلًا من بناء نظام جديد من الصفر. والمنطق بسيط: إذا كان النموذج الأساسي ينقل المعرفة بين أنواع مختلفة من الإشارات، فلن يضطر العلماء إلى إنفاق هذا القدر من الحوسبة والوقت على تطوير مستقل. ولإجراء الاختبار، اعتمد الفريق ثلاث مجموعات بيانات صوتية بحرية تضم أصوات الحيتان وضوضاء أخرى تحت الماء. وحُوّل ك
ما أبرز التفاصيل حول لماذا نجح النقل؟
الفكرة المحورية هنا هي transfer learning، أي نقل التعلّم. يتعلّم النموذج أولًا استخلاص الأنماط الصوتية العامة من مجموعة ضخمة من بيانات معينة، ثم تُطبَّق هذه المعرفة على مهمة أخرى قريبة منها. وفي حالة Perch 2.0 يبدو النقل مفاجئًا بصفة خاصة: فالطيور تغرّد في الهواء، بينما تتبادل الحيتان الإشارات تحت الماء. غير أن النموذج، على ما يبدو، لا يلتقط وسط انتقال الصوت فحسب، بل أنماطًا أدق: شكل الصفير، وديناميكية الترددات، ومدة الإشارة وبنيتها الدقيقة. «نحن ندرّب هذا النموذج على العثور على التفاصيل الصغيرة في المشاهد الصوتية». ويقدّم الباحثون عدة تفسيرات في آن واحد. فقد تكون لدى الطيو
ما أبرز التفاصيل حول ما فائدة ذلك لعلماء الأحياء؟
بالنسبة لباحثي المحيطات، لا تقتصر أهمية هذه النتيجة على كونها عرضًا لافتًا. ففي الصوتيات الحيوية تُكتشف باستمرار أنواع جديدة من الإشارات، ولا تزال بعض الضوضاء تحت الماء بلا تصنيف موثوق على الإطلاق. وإذا أمكن، بدلًا من إنشاء نموذج منفصل لكل نوع، اعتماد نظام أساسي قوي وإعادة تدريب مصنِّف خفيف بسرعة، فإن دورة البحث تصبح أقصر بشكل ملحوظ. ويفيد ذلك خصوصًا في المراقبة الصوتية السلبية، حين يستمع العلماء شهورًا إلى كميات هائلة من التسجيلات الواردة من العوّامات والهيدروفونات والمحطات المستقلة. إطلاق أسرع لنماذج جديدة لمجموعات محددة من الحيتان تكاليف أقل للتدريب من الصفر ولتجريب البن
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.