AWS تستعرض كيفية بناء محرك ذكاء اصطناعي لاختبارات A/B على Amazon Bedrock وDynamoDB
نشرت AWS شرحًا عمليًا لمحرك ذكاء اصطناعي لاختبارات A/B يعتمد على Amazon Bedrock وECS وDynamoDB وMCP. الفكرة هي تعيين النسخ لا عشوائيًا، بل وفق سياق المستخدم أثناء التجربة نفسها. قد يسرّع هذا النهج الوصول إلى الفرضيات الناجحة، ويرفع العائد من حركة المرور، ويقرّب الاختبارات من التخصيص. لكنه يتطلب تسجيلًا دقيقًا للبيانات (logging) ومراقبة صارمة للجانب الإحصائي.
معالج بواسطة الذكاء الاصطناعي من AWS Machine Learning Blog؛ بتحرير Hamidun News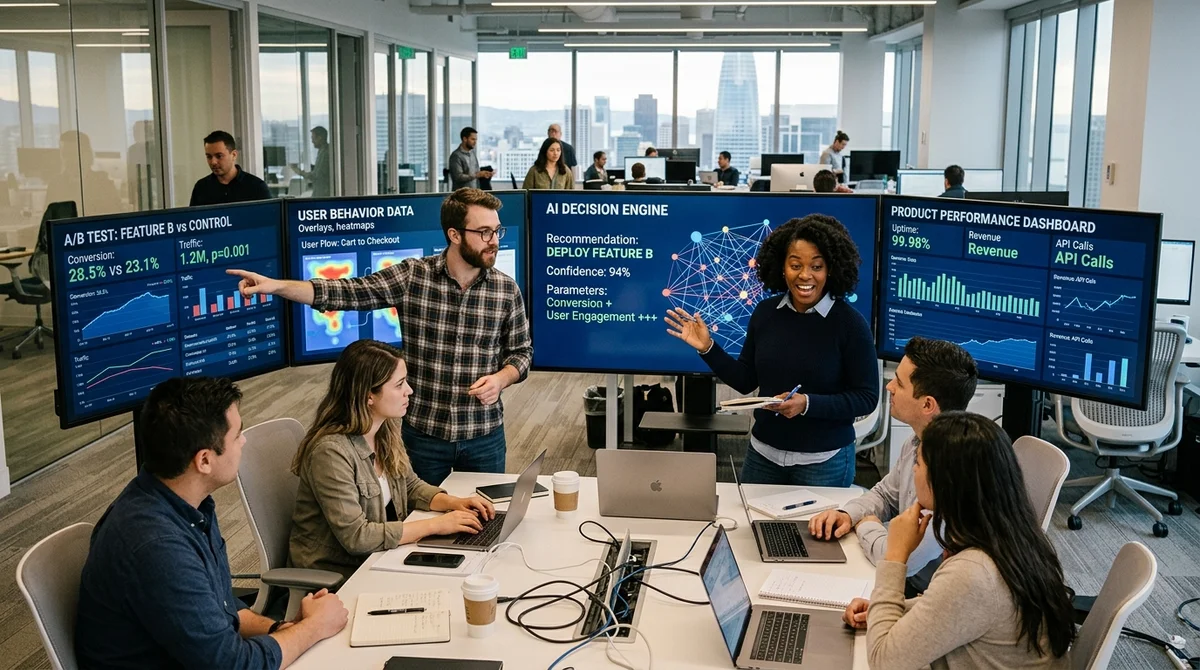
عرضت AWS كيف يمكن تحويل اختبار A/B التقليدي إلى آلية ذكاء اصطناعي سياقية. فبدلًا من التوزيع العشوائي للنسخ، يحلّل نظام قائم على Amazon Bedrock إشارات عن المستخدم ويساعد على اختيار النسخة التي ستُعرض له لحظة إجراء التجربة.
كيف يتغيّر اختبار A/B
يقسّم اختبار A/B التقليدي الجمهور عادةً بشكل عشوائي، ثم يقارن معدلات التحويل. أما النهج الذي تقترحه AWS فيحافظ على فكرة التجربة نفسها، لكنه يضيف طبقة لاتخاذ القرار أثناء عرض النسخة. يتلقى النموذج سياقًا يشمل: ما الذي يفعله المستخدم، ومن أين جاء، وعلى أي جهاز يتصفح، وكيف تتصرف الجلسة الحالية، وما النسخ المتاحة أصلًا ضمن الاختبار. وعلى هذا الأساس يستطيع النظام اختيار النسخة بدقة أعلى مما يتيحه التوزيع البسيط 50/50.
يقرّب ذلك الاختبار من السلوك الفعلي للمنتج، حيث تعمل الشاشة نفسها بشكل مختلف مع المستخدمين الجدد والعائدين، ومع حركة الجوال وحركة سطح المكتب، ومع الشرائح الغالية والرخيصة. وكلما رصد النظام إشارات مفيدة أكثر، وجد التركيبات الناجحة أسرع وقلّص عدد مرات عرض النسخة الضعيفة بوضوح. وبالنسبة لفرق النمو (growth)، لم يعد الأمر تحليلًا لاحقًا للإطلاق فحسب، بل محاولة للتأثير في النتيجة أثناء التجربة نفسها.
كيف تُبنى البنية
تقترح AWS بناء هذا المحرك على أربعة مكونات رئيسية. يتولى Amazon Bedrock منطق نماذج اللغة الكبيرة (LLM)، ويتولى Amazon ECS خدمة الحاويات التي تستقبل طلبات التطبيق، ويتولى Amazon DynamoDB تخزين حالة التجارب ونتائجها، فيما يعمل Model Context Protocol كطبقة وسيطة لتمرير الأدوات والسياق المنظّم إلى النموذج. والفكرة ليست مجرد ربط نموذج دردشة بالاختبارات، بل منحه وصولًا خاضعًا للرقابة إلى البيانات والقواعد وسجل القرارات.
- Amazon Bedrock — يحلّل السياق ويقترح النسخة التي ستُعرض
- Amazon ECS — يشغّل خدمة التنسيق وواجهة API الخاصة بالتجارب
- Amazon DynamoDB — يخزّن الإعدادات والتعيينات والمقاييس
- MCP — يصف النماذج والبيانات والإجراءات المتاحة
- التطبيق — يرسل سياق المستخدم ويتلقى القرار
في السيناريو المعتاد، يمرّر التطبيق إلى الخدمة معرّف التجربة، ومعاملات الجلسة، وقواعد العمل، والقيود الصريحة، وقائمة النسخ المتاحة. تجمع خدمة ECS الإشارات اللازمة، وتمرّرها إلى النموذج عبر Bedrock، ثم تتلقى قرار التعيين. بعد ذلك يُسجَّل الاختيار والنتائج اللاحقة في DynamoDB، ليتمكن الفريق من التحقق من كيفية اتخاذ النظام لقراره، ولا يفقد قابلية إعادة إنتاج التجربة عند التحليل اللاحق.
أين الفائدة وأين المخاطر
الميزة الرئيسية لهذا النهج ليست التخصيص وحده، بل استثمار حركة المرور بذكاء أكبر أثناء الاختبار. فإذا كانت إحدى النسخ تعمل بشكل أفضل لشريحة محددة، يستطيع النظام أخذ ذلك في الحسبان في وقت أبكر مما يتيحه المخطط الكلاسيكي ذو العشوائية الصارمة. ويفيد ذلك خصوصًا حيث يكلّف كل عرض مبالغ كبيرة: في التجارة الإلكترونية، والاشتراكات، وصفحات الهبوط الإعلانية، وتهيئة مستخدمي SaaS، وأي منتج ذي حجم محدود من حركة المرور عالية الجودة، حيث تبرز كلفة الخطأ أكثر.
غير أن لهذا التصميم ثمنًا. فكلما تدخّل النموذج أكثر في توزيع حركة المرور، صعُب الحفاظ على النقاء الإحصائي للتجربة وتفسير سبب رؤية المستخدم لهذه النسخة تحديدًا. وعمليًا، يتطلب هذا المحرك قواعد صارمة للتسجيل، وقيودًا واضحة على استخدام الإشارات، ومراقبة مستقلة للتوازن بين الاستكشاف (exploration) والاستغلال (exploitation). وإلا حصلت الشركة على طبقة ذكاء اصطناعي أنيقة، لكنها ستخسر الثقة بنتائج الاختبار نفسه.
ماذا يعني ذلك
يُظهر منشور AWS تحوّلًا من «الذكاء الاصطناعي كمولّد للنصوص» إلى الذكاء الاصطناعي كطبقة لاتخاذ القرارات المتعلقة بالمنتج. وبالنسبة لفرق النمو، فهذه إشارة إلى أن اختبارات A/B تتحوّل تدريجيًا من تحليل سلبي إلى نظام مُدار يساعد فيه النموذج على توزيع حركة المرور، لا على احتساب النتيجة بعد وقوعها فحسب.
- 31 أكتوبر 2026Worldwide Express تسلّم الفواتير المتنازع عليها لوكلاء الذكاء الاصطناعي وتخفّض الديون بنسبة 75%
- 30 أكتوبر 2026AWS تمنح وكلاء البرمجة معاينة حية للموقع مباشرة من جلسة معزولة
- 30 أكتوبر 2026MoEngage تتيح لوكلاء الذكاء الاصطناعي الوصول إلى 400 واجهة API مغلقة عبر AgentCore Gateway دون خوادم MCP خاصة بها
- 29 أكتوبر 2026NVIDIA Nemotron 3.5 Super VL: 120 مليار معامل، 12 مليارًا منها نشطة، والتشغيل على AWS
أسئلة وأجوبة حول الخبر
ما أبرز التفاصيل حول كيف يتغيّر اختبار A/B؟
يقسّم اختبار A/B التقليدي الجمهور عادةً بشكل عشوائي، ثم يقارن معدلات التحويل. أما النهج الذي تقترحه AWS فيحافظ على فكرة التجربة نفسها، لكنه يضيف طبقة لاتخاذ القرار أثناء عرض النسخة. يتلقى النموذج سياقًا يشمل: ما الذي يفعله المستخدم، ومن أين جاء، وعلى أي جهاز يتصفح، وكيف تتصرف الجلسة الحالية، وما النسخ المتاحة أصلًا ضمن الاختبار. وعلى هذا الأساس يستطيع النظام اختيار النسخة بدقة أعلى مما يتيحه التوزيع البسيط 50/50. يقرّب ذلك الاختبار من السلوك الفعلي للمنتج، حيث تعمل الشاشة نفسها بشكل مختلف مع المستخدمين الجدد والعائدين، ومع حركة الجوال وحركة سطح المكتب، ومع الشرائح الغالية و
ما أبرز التفاصيل حول كيف تُبنى البنية؟
تقترح AWS بناء هذا المحرك على أربعة مكونات رئيسية. يتولى Amazon Bedrock منطق نماذج اللغة الكبيرة (LLM)، ويتولى Amazon ECS خدمة الحاويات التي تستقبل طلبات التطبيق، ويتولى Amazon DynamoDB تخزين حالة التجارب ونتائجها، فيما يعمل Model Context Protocol كطبقة وسيطة لتمرير الأدوات والسياق المنظّم إلى النموذج. والفكرة ليست مجرد ربط نموذج دردشة بالاختبارات، بل منحه وصولًا خاضعًا للرقابة إلى البيانات والقواعد وسجل القرارات. Amazon Bedrock — يحلّل السياق ويقترح النسخة التي ستُعرض Amazon ECS — يشغّل خدمة التنسيق وواجهة API الخاصة بالتجارب Amazon DynamoDB — يخزّن الإعدادات والتعيينات وا
ما أبرز التفاصيل حول أين الفائدة وأين المخاطر؟
الميزة الرئيسية لهذا النهج ليست التخصيص وحده، بل استثمار حركة المرور بذكاء أكبر أثناء الاختبار. فإذا كانت إحدى النسخ تعمل بشكل أفضل لشريحة محددة، يستطيع النظام أخذ ذلك في الحسبان في وقت أبكر مما يتيحه المخطط الكلاسيكي ذو العشوائية الصارمة. ويفيد ذلك خصوصًا حيث يكلّف كل عرض مبالغ كبيرة: في التجارة الإلكترونية، والاشتراكات، وصفحات الهبوط الإعلانية، وتهيئة مستخدمي SaaS، وأي منتج ذي حجم محدود من حركة المرور عالية الجودة، حيث تبرز كلفة الخطأ أكثر. غير أن لهذا التصميم ثمنًا. فكلما تدخّل النموذج أكثر في توزيع حركة المرور، صعُب الحفاظ على النقاء الإحصائي للتجربة وتفسير سبب رؤية الم
Delegate Deep Research, Coding & Multi-Step Workflows to Nomad Agent
Deploy autonomous task execution with Nomad Agent (agent.nomadnet.ai) — automated web research, data synthesis, code generation, and MCP tool orchestration.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.