NVIDIA وPNY تروّجان لـ RTX PRO 6000 Blackwell لتحليل البيانات وتطوير الذكاء الاصطناعي
تروّج PNY لمحطات عمل مزوّدة بـ NVIDIA RTX PRO 6000 Blackwell بوصفها بديلًا لأنظمة المعالجات المركزية (CPU) في مهام علم البيانات. وأبرز حججها: سرعة تفوق pandas بما يصل إلى 50 ضعفًا عبر cuDF دون إعادة كتابة الشيفرة، وتقليص زمن تدريب XGBoost، وإمكانية تركيب ما يصل إلى أربع وحدات GPU في جهاز واحد. يقوم الطرح على المعالجة المحلية للبيانات، وتقليل الاعتماد على السحابة، والتحكم في النفقات.
معالج بواسطة الذكاء الاصطناعي من IEEE Spectrum AI؛ بتحرير Hamidun News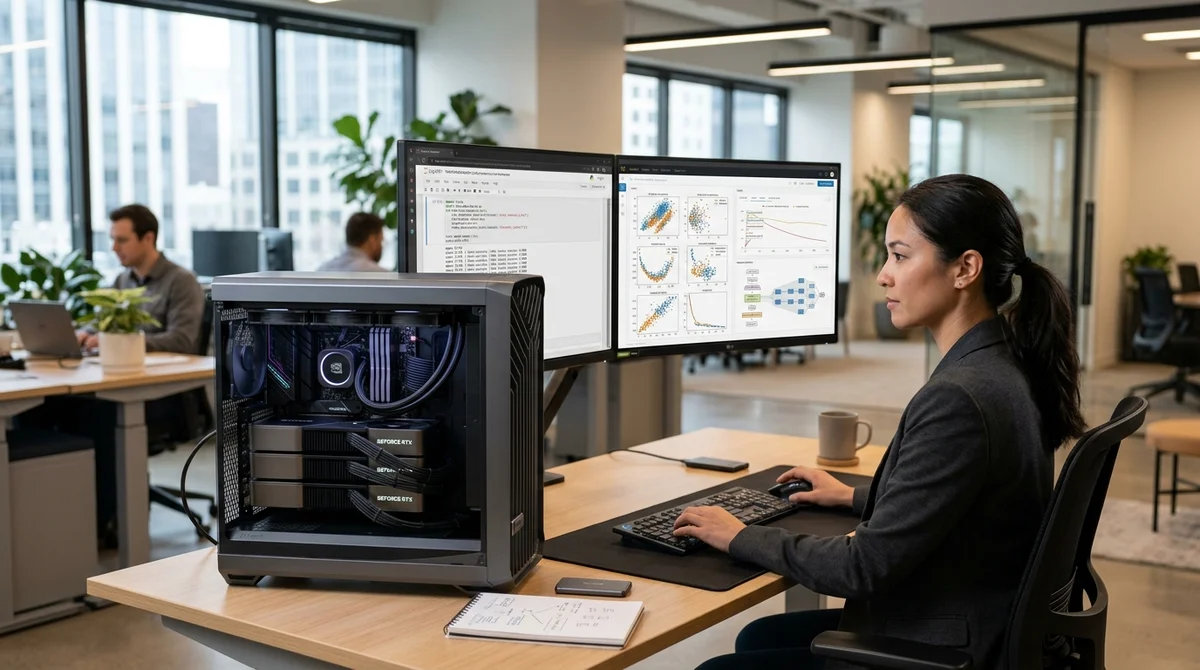
تروّج PNY، في مادة برعاية تجارية نُشرت في IEEE Spectrum، لمحطة العمل NVIDIA RTX PRO 6000 Blackwell Workstation Edition بوصفها بديلًا محليًّا للسحابة ومراكز البيانات في مهام علم البيانات. والفكرة المحورية أن جزءًا من خطوط الأنابيب الثقيلة في الذكاء الاصطناعي والتحليلات يمكن تسريعه عشرات المرات مباشرةً في مكان العمل.
لماذا لا يكفي المعالج المركزي؟
تدور المادة حول ثلاث نقاط اختناق مألوفة لمعظم فرق علم البيانات. الأولى إعداد البيانات: فالتنظيف ودمج الجداول وملء القيم المفقودة وإنشاء الخصائص تستهلك غالبًا الجزء الأكبر من الوقت قبل تدريب النموذج. الثانية الحجم: فالبيانات تنمو أسرع مما تستطيع أنظمة CPU المكتبية استيعابه، ولذلك تضطر الفرق أحيانًا إلى اقتطاع العيّنات، فتخسر جودة النتائج. الثالثة العتاد: فالوصول إلى المسرّعات في السحابة ومراكز البيانات مكلف، وفي بعض الحالات محدود أيضًا.
في هذا السياق، تقترح NVIDIA وPNY إعادة جزء من الحمل إلى محطات العمل المحلية. والفكرة بسيطة: إذا حصل المحلل أو مهندس تعلّم الآلة على جهاز بعدة وحدات GPU تحت مكتبه، قلّ اعتماده على طوابير البنية التحتية المشتركة، وأصبح اختبار الفرضيات أسرع، ولم تعد البيانات الحساسة تغادر مقر العمل. وتُقدَّم هذه الصيغة للفرق المؤسسية كحلّ وسط بين السرعة والخصوصية والتحكم في النفقات.
ماذا تَعِد به Blackwell؟
ينصبّ التركيز الأساسي على تسريع خط المعالجة كاملًا، من عمليات pandas إلى تدريب النماذج. ووفق ما تذكره NVIDIA، تستطيع مكتبة cuDF ضمن حزمة CUDA-X تسريع خطوط أنابيب Python دون إعادة كتابة الشيفرة، ويُفترض أن يقلّص الربط مع PyData وXGBoost زمن التحليل الاستكشافي والتدريب بشكل ملحوظ. كما صُمّمت المنصة لسيناريوهات تعدد المستخدمين، والتصوير البصري المتقدم، والعمل المشترك عبر NVIDIA AI Workbench، بحيث يمكن إدارة المشروع نفسه على جهاز محلي وفي السحابة وفي مركز البيانات.
- ما يصل إلى أربع وحدات GPU من طراز RTX PRO 6000 Blackwell Max-Q في محطة عمل واحدة
- تسريع pandas عبر cuDF دون تغيير الشيفرة، بحسب الشركة، يصل إلى 50 ضعفًا
- عملية join: قرابة 5 دقائق على CPU مقابل 14 ثانية على GPU
- عملية group by: قرابة 4 دقائق على CPU مقابل 4 ثوانٍ على GPU
- تدريب XGBoost الذي كان يستغرق أسابيع، تَعِد الشركة بتقليصه إلى دقائق
«أقوى وحدة GPU مكتبية صُنعت على الإطلاق»
نبرة المادة التسويقية مباشرة: هكذا تصف PNY بطاقة RTX PRO 6000 Blackwell في الفيديو المصاحب. إنه ادعاء قوي، لكن المادة نفسها لا تتضمن اختبارات مستقلة ولا مقارنة مع بدائل بالتهيئة ذاتها. لذلك ينبغي التعامل مع الأرقام كمؤشر من الشركة المصنِّعة: فهي تُظهر فئة المهام التي تمنح فيها وحدات GPU مكسبًا فعليًّا، لكنها لا تغني عن اختبار معياري كامل على حزمتك البرمجية وبياناتك.
الرهان على المعالجة المحلية
ثمة حجة مستقلة تتعلق بالاقتصاد والأمان. فحين ينتقل جزء من خط المعالجة من السحابة إلى محطة العمل، تدفع الشركة أقل مقابل استئجار القدرة الحاسوبية والتخزين، وتبقى مجموعات البيانات الحساسة داخل محيطها. وبالنسبة إلى القطاعات التي تفرض متطلبات المعالجة داخل المنشأة (on-premise)، فهذا أهم من الأداء الخالص. كما أن الجهاز المحلي يقلّل الاعتماد على شحّ وحدات GPU في مراكز البيانات، فلا يضطر الفريق إلى انتظار موعد لتدريب نموذج أو استحصال ميزانية منفصلة إلا في حالات أقل.
وتؤكد PNY كذلك الجانب المؤسسي: التكامل مع البنية التحتية القائمة لتقنية المعلومات، وحلول الشبكات NVIDIA ConnectX، وأدوات النشر، ووقت التشغيل العالي. والرسالة واضحة: لا يُسوَّق RTX PRO 6000 Blackwell بوصفه «بطاقة للهواة»، بل كلبنة أساسية لتطوير الذكاء الاصطناعي في المؤسسات. وخصوصًا للفرق التي تحتاج إلى تكرارات سريعة على مجموعات بيانات كبيرة، لكنها غير مستعدة للانتقال الكامل إلى السحابة أو للتنافس المستمر على موارد عنقود مشترك.
ما معنى ذلك؟
يتجه سوق عتاد الذكاء الاصطناعي بصورة متزايدة من الوعود العامة إلى سيناريو محدد: منح فريق علم البيانات أداءً بمستوى مراكز البيانات مباشرةً في مكان العمل. وإذا تأكدت التسريعات المعلنة على أحمال عمل حقيقية، فقد تصبح هذه المحطات طبقة وسيطة بين حاسوب المحلل المحمول والعنقود المكلف المبني على وحدات GPU. لكن شراءها ينبغي أن يأتي بعد التحقق على خطوط الأنابيب الخاصة بك، لا استنادًا إلى اختبار معياري إعلاني.
Access Frontier LLMs & Multimodal AI in One Workspace
Discover NomadNet AI (nomadnet.ai) — unified access to frontier language models, research synthesis, and multimodal workflows.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.