MIT تطوّر ذكاءً اصطناعيًا «متواضعًا» للتشخيص يُظهر شكوكه بصدق
يقترح MIT أن يكون الذكاء الاصطناعي الطبي «متواضعًا» لا عليمًا بكل شيء: على النموذج أن يُظهر بنفسه متى تنقصه البيانات اللازمة للتشخيص. وبدلًا من إجابة واثقة لكنها قد تكون خاطئة، يمكن للنظام أن يطلب فحوصات إضافية أو تفاصيل من السيرة المرضية أو استشارة أخصائي. ويعمل الفريق حاليًا على دمج هذا النهج في أدوات مبنية على MIMIC، ويختبره مع أطباء سريريين.
معالج بواسطة الذكاء الاصطناعي من MIT News؛ بتحرير Hamidun News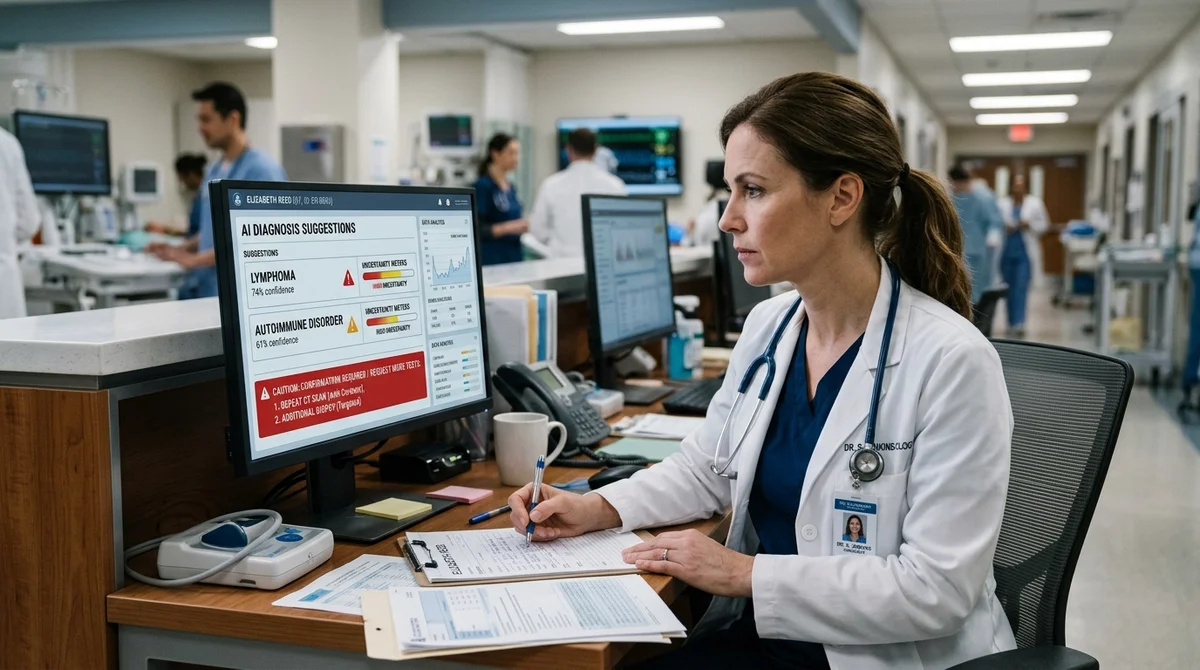
اقترح باحثو MIT نهجًا جديدًا للذكاء الاصطناعي الطبي: ينبغي لنظام التشخيص السريري ألّا يتظاهر بأنه يعرف كل شيء، بل أن يُظهر صراحةً متى تنقصه البيانات. وبدلًا من نموذج «عرّاف»، يريد الفريق أن يجعل النموذج شريكًا للطبيب، يساعده على جمع المعلومات الناقصة ولا يضغط عليه بإجابة تبدو قاطعة.
لماذا الحاجة إلى ذلك
تَعِد أنظمة الذكاء الاصطناعي منذ وقت طويل بتسريع التشخيص والمساعدة في اختيار العلاج، لكن لديها في الميدان السريري نقطة ضعف خطيرة: فهي كثيرًا ما تبدو واثقة أكثر من اللازم حتى حين تخطئ. ويستند فريق MIT إلى دراسات سابقة أظهرت أن أطباء العناية المركزة مالوا إلى الأخذ بنصيحة الخوارزمية إذا اعتبروها موثوقة، حتى حين كان حدسهم الشخصي يدفعهم إلى عكس ذلك. والمنطق نفسه ينطبق على المرضى: فالنبرة الواثقة ترفع الثقة حتى بتوصية خاطئة.
ولا تكمن المشكلة في دقة النماذج وحدها، بل في طريقة عرضها للإجابة أيضًا. فإذا قدّم النظام التشخيص كحقيقة نهائية في ظل سياق ناقص، يحصل الطبيب على إحساس زائف باليقين. وهذا خطر بوجه خاص في أقسام الطوارئ والعناية المركزة، حيث يُتخذ القرار غالبًا بسرعة وتكون كلفة الخطأ مرتفعة. لذلك يقترح الباحثون تدريب النموذج على ألّا يكتفي بالإجابة، بل أن ينبّه صراحةً إلى حدود ثقته.
كيف يعمل النهج
يصف الفريق إطارًا يمكن دمجه في أنظمة دعم القرار السريري القائمة. تُلزِم الوحدة الأولى فيه النموذج بتقييم ثقته بنفسه قبل إصدار التنبؤ التشخيصي. ولهذا يستخدم الباحثون مقياس Epistemic Virtue Score الذي طوّروه بالتعاون مع علماء من جامعة ملبورن. وهو في جوهره اختبار للوعي الذاتي: يجب أن تتناسب ثقة النموذج مع تعقيد الحالة وحجم البيانات المتاحة. وإذا رأى النظام أن ثقته أعلى مما تسمح به الأدلة، فعليه ألّا يُصرّ على استنتاجه، بل أن يغيّر سلوكه:
- الإشارة إلى التفاوت بين مستوى الثقة وجودة البيانات
- طلب فحوصات محددة أو تفاصيل من السيرة المرضية أو علامات ناقصة
- اقتراح استشارة أخصائي في المجال
- توضيح المعلومات التي من شأنها أن تقلّل حالة عدم اليقين
- التحذير من أن الإجابة الحالية تتطلب تفسيرًا حذرًا
«نستخدم الذكاء الاصطناعي اليوم كعرّاف، لكن يمكن تحويله إلى مدرّب وإلى
مساعد طيار حقيقي»، يقول ليو أنتوني سيلي.
شارك فريق سيلي سابقًا في إنشاء مجموعات بيانات كبيرة للذكاء الاصطناعي الطبي، من بينها قاعدة MIMIC. ويحاول الباحثون الآن دمج النهج الجديد في الأنظمة التي تعمل على هذه البيانات، وعرضه على الأطباء السريريين في شبكة Beth Israel Lahey Health. ووفق قولهم، يمكن تطبيق النهج نفسه لا في مساعدي التشخيص النصيين فحسب، بل أيضًا في أنظمة تحليل صور الأشعة السينية أو اختيار خطة العلاج في قسم الاستقبال.
مشكلة البيانات
يأتي العمل على الذكاء الاصطناعي «المتواضع» ضمن برنامج أوسع في MIT لبناء نماذج طبية تُصمَّم لا من أجل البشر فحسب، بل معهم أيضًا. ويؤكد الباحثون بصورة منفصلة خطر الانحيازات في البيانات: فكثير من النماذج الشائعة تتدرب على مجموعات بيانات عامة من الولايات المتحدة، وترث حتمًا نظرة معينة إلى الأمراض والعلاج وتنظيم الرعاية. وما هو موصوف جيدًا في نظام صحي واحد قد يعمل بصورة أسوأ في نظام آخر، أو قد يستبعد دون أن يلاحظ أحد فئات كاملة من المرضى.
وثمة مشكلة أكثر واقعية: فالسجلات الطبية الإلكترونية لم تُنشأ في الأصل لتكون مصدرًا مثاليًا لتدريب نماذج التشخيص. فكثيرًا ما ينقصها السياق الذي يحصل عليه الطبيب من المحادثة أو الملاحظة أو الخبرة. وإضافة إلى ذلك، لا يظهر بعض المرضى أصلًا في مجموعات البيانات هذه بسبب محدودية وصولهم إلى الرعاية الطبية، مثل سكان المناطق الريفية. وفي ورشات MIT Critical Data، يتحقق الباحثون والأطباء وعلماء الاجتماع والمرضى أنفسهم معًا من الفئات الغائبة عن مجموعة البيانات، ومن الانحيازات البنيوية التي قد يرسّخها النموذج.
ماذا يعني ذلك
لا تقتصر المرحلة التالية من تطور الذكاء الاصطناعي الطبي على التنافس على نقطتين مئويتين إضافيتين من الدقة في الاختبارات المعيارية، بل تشمل القدرة على الشك في الوقت المناسب. وإذا وصل هذا النهج إلى العيادات الفعلية، فلن تكمن قيمة النموذج في استبدال الطبيب، بل في عمل أكثر شفافية وحذرًا وتشاركًا معه.
أسئلة وأجوبة حول الخبر
ما أبرز التفاصيل حول لماذا الحاجة إلى ذلك؟
تَعِد أنظمة الذكاء الاصطناعي منذ وقت طويل بتسريع التشخيص والمساعدة في اختيار العلاج، لكن لديها في الميدان السريري نقطة ضعف خطيرة: فهي كثيرًا ما تبدو واثقة أكثر من اللازم حتى حين تخطئ. ويستند فريق MIT إلى دراسات سابقة أظهرت أن أطباء العناية المركزة مالوا إلى الأخذ بنصيحة الخوارزمية إذا اعتبروها موثوقة، حتى حين كان حدسهم الشخصي يدفعهم إلى عكس ذلك. والمنطق نفسه ينطبق على المرضى: فالنبرة الواثقة ترفع الثقة حتى بتوصية خاطئة. ولا تكمن المشكلة في دقة النماذج وحدها، بل في طريقة عرضها للإجابة أيضًا. فإذا قدّم النظام التشخيص كحقيقة نهائية في ظل سياق ناقص، يحصل الطبيب على إحساس زائف ب
ما أبرز التفاصيل حول كيف يعمل النهج؟
يصف الفريق إطارًا يمكن دمجه في أنظمة دعم القرار السريري القائمة. تُلزِم الوحدة الأولى فيه النموذج بتقييم ثقته بنفسه قبل إصدار التنبؤ التشخيصي. ولهذا يستخدم الباحثون مقياس Epistemic Virtue Score الذي طوّروه بالتعاون مع علماء من جامعة ملبورن. وهو في جوهره اختبار للوعي الذاتي: يجب أن تتناسب ثقة النموذج مع تعقيد الحالة وحجم البيانات المتاحة. وإذا رأى النظام أن ثقته أعلى مما تسمح به الأدلة، فعليه ألّا يُصرّ على استنتاجه، بل أن يغيّر سلوكه: الإشارة إلى التفاوت بين مستوى الثقة وجودة البيانات طلب فحوصات محددة أو تفاصيل من السيرة المرضية أو علامات ناقصة اقتراح استشارة أخصائي في المج
ما أبرز التفاصيل حول مشكلة البيانات؟
يأتي العمل على الذكاء الاصطناعي «المتواضع» ضمن برنامج أوسع في MIT لبناء نماذج طبية تُصمَّم لا من أجل البشر فحسب، بل معهم أيضًا. ويؤكد الباحثون بصورة منفصلة خطر الانحيازات في البيانات: فكثير من النماذج الشائعة تتدرب على مجموعات بيانات عامة من الولايات المتحدة، وترث حتمًا نظرة معينة إلى الأمراض والعلاج وتنظيم الرعاية. وما هو موصوف جيدًا في نظام صحي واحد قد يعمل بصورة أسوأ في نظام آخر، أو قد يستبعد دون أن يلاحظ أحد فئات كاملة من المرضى. وثمة مشكلة أكثر واقعية: فالسجلات الطبية الإلكترونية لم تُنشأ في الأصل لتكون مصدرًا مثاليًا لتدريب نماذج التشخيص. فكثيرًا ما ينقصها السياق الذي
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.