Machine Learning Mastery: لماذا لا يكفي مخزن متجهات واحد لتطبيقات الذكاء الاصطناعي
ذكّر Machine Learning Mastery بحقيقة بسيطة: مخزن المتجهات (vector store) ممتاز للبحث بالمعنى، لكنه لا يحل محل قاعدة البيانات الكاملة لمنتج الذكاء الاصطناعي. ففي بيئة الإنتاج تلزم دائمًا تقريبًا قاعدة SQL إلى جانب embeddings، لإدارة الصلاحيات والبيانات الوصفية والفوترة وحالة التطبيق. وبالنسبة إلى كثير من الفرق، قد تكون نقطة البداية المثلى هي PostgreSQL مع pgvector، على أن يُضاف مخزن متجهات مستقل لاحقًا عندما يكبر حجم البيانات.
معالج بواسطة الذكاء الاصطناعي من Machine Learning Mastery؛ بتحرير Hamidun News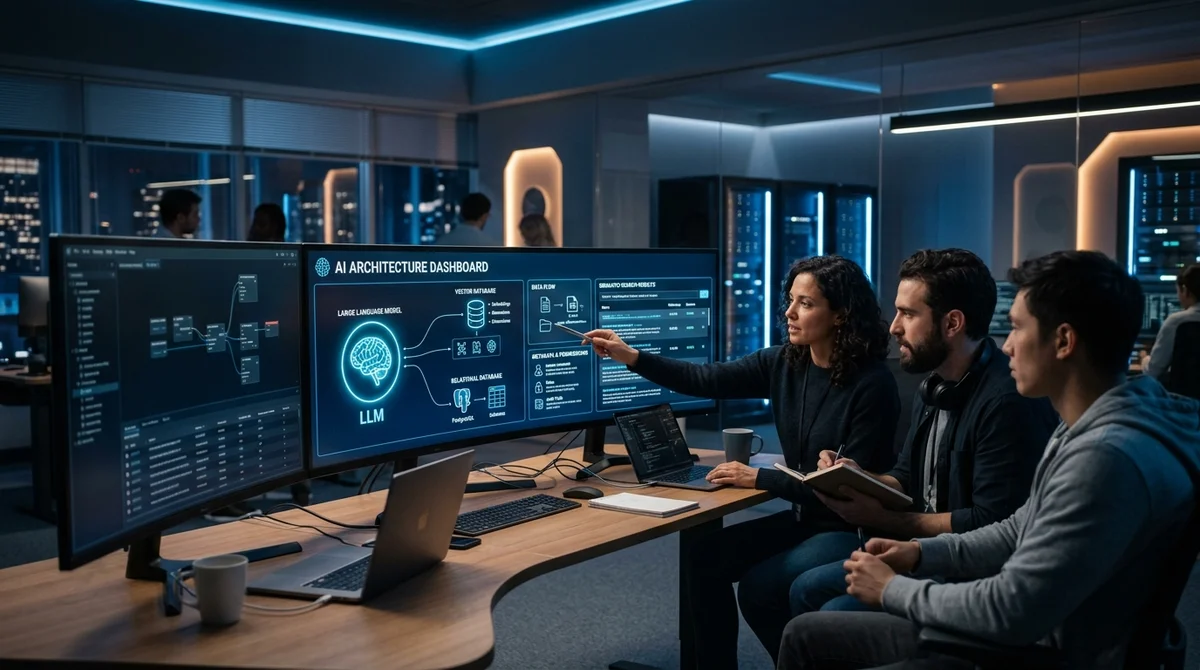
تناول Machine Learning Mastery خطأً شائعًا في بنية تطبيقات الذكاء الاصطناعي، وهو اعتبار مخزن المتجهات (vector store) قاعدة بيانات متكاملة للمنتج بأكمله. في مرحلة العرض التجريبي يكفي ذلك غالبًا، لكن في بيئة الإنتاج تلزم دائمًا تقريبًا طبقة علائقية كلاسيكية إلى جانب البحث المتجهي.
أين يتفوق مخزن المتجهات
أصبحت قواعد البيانات المتجهية عنصرًا قياسيًا في أنظمة RAG، لأنها تحل مهمة يعجز SQL التقليدي عن أدائها جيدًا: البحث بالمعنى لا بالتطابق الحرفي للكلمات. فحين يطرح المستخدم سؤالًا، يحوّله النظام إلى embedding ويبحث عن مقاطع المستندات الأقرب إليه في المعنى. وبهذا يستطيع الذكاء الاصطناعي العثور على نصوص ذات صلة حتى لو لم ترد فيها الصياغات نفسها الواردة في الاستعلام.
وتزداد فائدة ذلك مع البيانات غير المهيكلة، مثل المستندات الداخلية والمراسلات وملفات PDF وقواعد المعرفة. فإذا سأل شخص عن حقوق المستأجر عند ظهور العفن في الشقة، سيعثر البحث المتجهي على أقسام تتناول معايير صلاحية السكن أو التزامات المؤجّر، حتى لو لم تَرِد عبارة «ظروف المعيشة الخطرة» في المستند. ويتحمل هذا النهج الأخطاء الإملائية وإعادة الصياغة والسياق الضمني بصورة أفضل. ولهذا أصبح مخزن المتجهات مكوّنًا أساسيًا في البحث المعتمد على الذكاء الاصطناعي، حيث لا تتطابق الصياغات تقريبًا كلمةً بكلمة.
أين تلزم SQL
المشكلة أن المرونة التي يتمتع بها البحث المتجهي تجعله أداة غير دقيقة للمهام التشغيلية. فهو يجيب جيدًا عن سؤال «ما الأقرب في المعنى»، لكنه لا يناسب الحالات التي تتطلب إجابة قاطعة بلا احتمالات أو هوامش تسامح. وما إن يضم المنتج مستخدمين وحدود استخدام ومدفوعات وحالات للكائنات، حتى يصبح البحث التقريبي عائقًا لا عونًا.
لهذا تبقى القاعدة العلائقية في أنظمة الإنتاج هي المكان الذي تقيم فيه كل «الحقائق الصلبة»:
- الصلاحيات وحدود المستأجرين (tenant)، حيث يتحول الخطأ إلى تسرّب للبيانات؛
- البيانات الوصفية للمستندات: المؤلف، وURL، وتاريخ الرفع، وتجزئة الملف (hash)، وحالة النشر؛
- الفوترة والتدقيق والسجلات وأي سجلات يجب أن تظل متسقة؛
- حالة التطبيق: هل أُرشفت المحادثة، وهل الخاصية (flag) مفعّلة، وما الباقة التي يشترك بها المستخدم.
وثمة نقطة عملية أخرى: الفلترة الدقيقة عبر SQL تقلل هلوسات النموذج. فإذا كان على الذكاء الاصطناعي أن يلخّص فقط التذاكر عالية الأولوية التي أغلقها فريق الواجهة الأمامية خلال آخر 7 أيام، فيجب أولًا انتقاء هذه السجلات بدقة صارمة، ثم تمرير نصوصها إلى النموذج. وهذا أرخص وأسرع وأكثر أمانًا من الرهان على أن يُرجع البحث المتجهي وحده، بالمصادفة، مجموعة بيانات محددة بدقة مثالية. فدور SQL هنا ليس منافسة LLM، بل تهيئة مساحة عمل صحيحة له.
المخطط الهجين
يقترح الكاتب ألا نختار بين النهجين، بل أن نجمعهما في طبقة بيانات واحدة. والسيناريو المعتاد كالتالي: تتحقق القاعدة العلائقية أولًا من المستخدم ودوره وقائمة المستندات المتاحة له، ثم يبحث مخزن المتجهات عن التطابقات الدلالية داخل هذه المجموعة الآمنة فقط. وفي المساعدات الذكية للمؤسسات، لا يُعد هذا تحسينًا للأداء بل حدًّا أمنيًا. فمن دون هذا الفلتر المسبق، يخاطر النظام بعرض بيانات فريق آخر، أو حتى عميل آخر، على المستخدم.
ويعمل النمط المعاكس أيضًا. فبعد أن يُرجع البحث المتجهي المقاطع ذات الصلة، يستطيع التطبيق جلب البيانات الوصفية من SQL: من مؤلف المستند، ومتى حُدّث، وما مستوى الثقة المرتبط به. عندها لا يجيب النموذج بشكل مجرد، بل بسياق، مثل الإشارة إلى حداثة المستند أو القسم الذي أصدره. وفي قواعد المعرفة الداخلية ووكلاء الدعم، يرفع ذلك الثقة بالإجابة بشكل ملحوظ، ويساعد المستخدم على التحقق السريع من مصدرها.
وللفرق التي لا ترغب في الاحتفاظ بقاعدتي بيانات مختلفتين، يخصّ Machine Learning Mastery بالذكر pgvector، وهو امتداد لـ PostgreSQL للبحث بالتشابه (similarity search). وفي هذا الخيار تُخزَّن embeddings إلى جانب الحقول المهيكلة، ويستطيع استعلام واحد أن يتحقق من الصلاحيات، ويصفّي السجلات بحسب التاريخ والحالة، ثم يرتّبها بحسب القرب الدلالي. والمفاضلة بسيطة: على نطاق متوسط، يبسّط هذا النهج البنية التحتية بوضوح، أما عند مليارات المتجهات فلا تزال الأنظمة المتخصصة مثل Pinecone أو Milvus أسرع. لكن مع مئات الآلاف أو بضعة ملايين من المتجهات، يكون هذا النهج غالبًا نقطة البداية الأكثر واقعية.
ماذا يعني ذلك
الخلاصة الأساسية بسيطة: مخزن المتجهات جزء مهم من حزمة الذكاء الاصطناعي، لكنه ليس بديلًا عنها كلها. فإذا كان المنتج يتعامل مع مستخدمين وصلاحيات وأموال وحالة النظام، فلا غنى عن قاعدة بيانات علائقية. وبالنسبة إلى معظم الفرق، تتمثل نقطة البداية المعقولة في PostgreSQL مع pgvector، أو في الجمع بين SQL وقاعدة متجهات مستقلة، بحيث تتولى كل تقنية فئة المهام التي تجيدها أكثر. وكلما ظهر هذا الفصل مبكرًا في البنية، قلّ احتمال انهيار النسخة التجريبية عند أول نمو حقيقي.
أسئلة وأجوبة حول الخبر
ما أبرز التفاصيل حول أين يتفوق مخزن المتجهات؟
أصبحت قواعد البيانات المتجهية عنصرًا قياسيًا في أنظمة RAG، لأنها تحل مهمة يعجز SQL التقليدي عن أدائها جيدًا: البحث بالمعنى لا بالتطابق الحرفي للكلمات. فحين يطرح المستخدم سؤالًا، يحوّله النظام إلى embedding ويبحث عن مقاطع المستندات الأقرب إليه في المعنى. وبهذا يستطيع الذكاء الاصطناعي العثور على نصوص ذات صلة حتى لو لم ترد فيها الصياغات نفسها الواردة في الاستعلام. وتزداد فائدة ذلك مع البيانات غير المهيكلة، مثل المستندات الداخلية والمراسلات وملفات PDF وقواعد المعرفة. فإذا سأل شخص عن حقوق المستأجر عند ظهور العفن في الشقة، سيعثر البحث المتجهي على أقسام تتناول معايير صلاحية السكن
ما أبرز التفاصيل حول أين تلزم SQL؟
المشكلة أن المرونة التي يتمتع بها البحث المتجهي تجعله أداة غير دقيقة للمهام التشغيلية. فهو يجيب جيدًا عن سؤال «ما الأقرب في المعنى»، لكنه لا يناسب الحالات التي تتطلب إجابة قاطعة بلا احتمالات أو هوامش تسامح. وما إن يضم المنتج مستخدمين وحدود استخدام ومدفوعات وحالات للكائنات، حتى يصبح البحث التقريبي عائقًا لا عونًا. لهذا تبقى القاعدة العلائقية في أنظمة الإنتاج هي المكان الذي تقيم فيه كل «الحقائق الصلبة»: الصلاحيات وحدود المستأجرين (tenant)، حيث يتحول الخطأ إلى تسرّب للبيانات؛ البيانات الوصفية للمستندات: المؤلف، وURL، وتاريخ الرفع، وتجزئة الملف (hash)، وحالة النشر؛ الفوترة والت
ما أبرز التفاصيل حول المخطط الهجين؟
يقترح الكاتب ألا نختار بين النهجين، بل أن نجمعهما في طبقة بيانات واحدة. والسيناريو المعتاد كالتالي: تتحقق القاعدة العلائقية أولًا من المستخدم ودوره وقائمة المستندات المتاحة له، ثم يبحث مخزن المتجهات عن التطابقات الدلالية داخل هذه المجموعة الآمنة فقط. وفي المساعدات الذكية للمؤسسات، لا يُعد هذا تحسينًا للأداء بل حدًّا أمنيًا. فمن دون هذا الفلتر المسبق، يخاطر النظام بعرض بيانات فريق آخر، أو حتى عميل آخر، على المستخدم. ويعمل النمط المعاكس أيضًا. فبعد أن يُرجع البحث المتجهي المقاطع ذات الصلة، يستطيع التطبيق جلب البيانات الوصفية من SQL: من مؤلف المستند، ومتى حُدّث، وما مستوى الثق
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.