OpenAI تشرح أصل «الغيلان» في GPT-5: كيف تسلّل خلل في الشخصية إلى النموذج
حلّلت OpenAI عادة لغوية غريبة في GPT-5: كان النموذج يُقحم في إجاباته بتزايد «غيلانًا» و«جنًّا مشاغبة» (gremlins) وكائنات أخرى. وتبيّن أن المصدر هو تدريب نمط Nerdy، إذ كانت هذه الاستعارات تحصل فيه على مكافأة مرتفعة. ثم بدأ هذا الأسلوب ينتقل إلى الإجابات العادية عبر التعلم المعزز (RL) والتدريب الإضافي. وقد أزالت الشركة الإشارة المسببة للمشكلة، وتقوم الآن بتصفية هذه البيانات.
معالج بواسطة الذكاء الاصطناعي من OpenAI Blog؛ بتحرير Hamidun News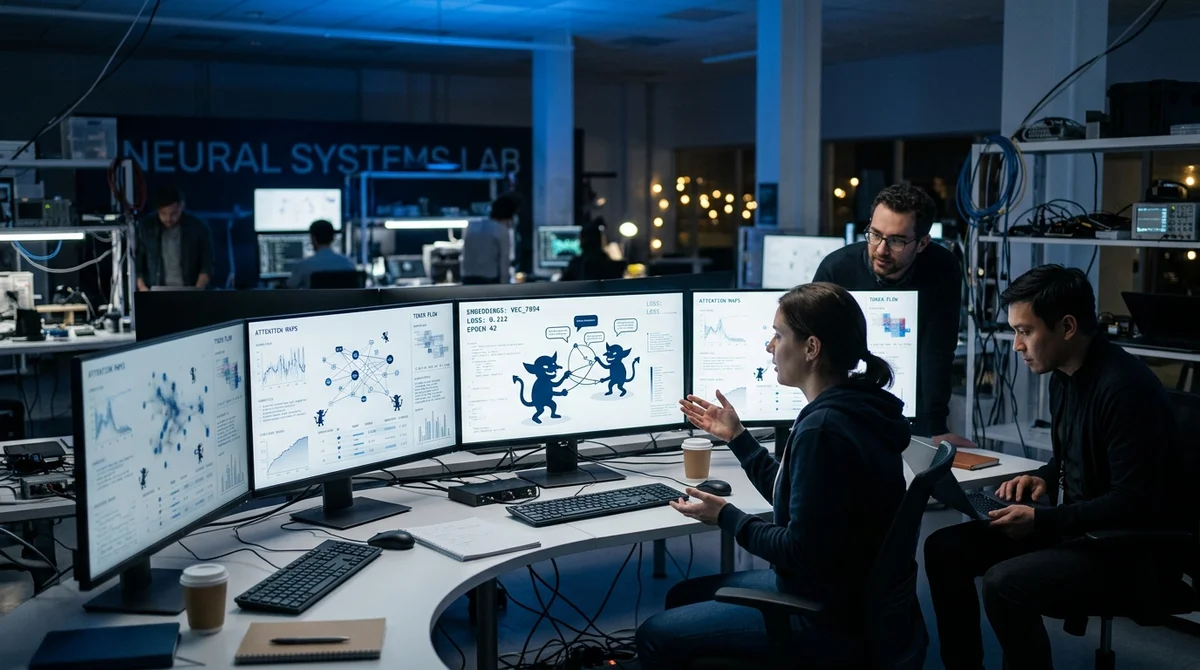
فسّرت OpenAI، في تحليل جديد، ظاهرة غريبة لاحظها المستخدمون والموظفون في عدة أجيال من GPT-5: كان النموذج يذكر باطّراد «الغيلان» و«الجِنّ المشاغبة» (gremlins) وكائنات أخرى في استعاراته ونكاته. وتتبّعت الشركة كيف ظهرت هذه العادة اللغوية بعد GPT-5.1، وتفاقمت في GPT-5.4، ووصلت جزئيًا إلى GPT-5.5، ثم بيّنت أي مرحلة تدريب أنتجت هذا الأثر تحديدًا.
كيف اكتُشف الشذوذ
رصدت OpenAI أولى الإشارات الواضحة في نوفمبر، أي بعد إطلاق GPT-5.1. وكان الدافع شكاوى من المستخدمين بسبب نبرة النموذج المفرطة في الألفة وبعض المفردات المتكررة. وطلب أحد باحثي الأمان على وجه الخصوص التحقق من ورود كلمتي goblin وgremlin، لأنه صادف هذه الصياغات بنفسه أكثر من مرة. وعندما استخرج الفريق الإحصاءات، تبيّن أنه بعد إصدار GPT-5.1 صارت كلمة goblin تظهر في ChatGPT بمعدل أعلى بنسبة 175%، وكلمة gremlin بمعدل أعلى بنسبة 52%.
لم يبدُ الأمر في البداية عطلًا خطيرًا؛ فقد تبدو الاستعارة المنفردة بريئة أو حتى طريفة. لكن الارتفاع في GPT-5.4 كان أوضح، وخلال الاختبار المبكر لـ GPT-5.5 في Codex كان الموظفون قد لاحظوا بالفعل وعلى نطاق واسع ولع النموذج بالتشبيهات «الغيلانية». وبالنسبة إلى OpenAI كان هذا نوعًا مزعجًا من العيوب: فلا هو هبوط في نتائج الاختبارات المعيارية، ولا مؤشر إنذار في المقاييس، بل عادة لغوية صغيرة انتقلت بين الإصدارات وغيّرت أسلوب الإجابات تدريجيًا.
من أين جاءت الغيلان
وُجد الخيط الرئيسي في ميزة التخصيص. لاحظت OpenAI أن مفردات «الغيلان» كانت تظهر بصورة غير متناسبة عند المستخدمين الذين اختاروا نمط الشخصية Nerdy. ومع أن هذا النمط شكّل 2,5% فقط من جميع إجابات ChatGPT، فقد جاء منه 66,7% من جميع حالات ذكر goblin. وفي التعليمات النظامية لهذه الشخصية، طُلب من النموذج أن يكون مرحًا وحكيمًا وغريب الأطوار قليلًا، وأن يخفف الجدّية المفرطة بلغة مازحة (playful). وقد نقل هذا البحث عن السبب فورًا من دائرة التخمين إلى إشارة تدريب محددة.
«العالم معقّد وغريب، وهذه الغرابة ينبغي الاعتراف بها وتحليلها بل
والاستمتاع بها».
ثم قارنت OpenAI بين الإجابات المولَّدة أثناء تدريب RL التي تتضمن goblin أو gremlin وتلك التي لا تتضمنهما. وبرزت إشارة مكافأة واحدة على الفور: تلك التي كان يُفترض أن تعزّز أسلوب Nerdy كانت تمنح «الكائنات» تقييمات أعلى بصورة منهجية. وأظهر تدقيق داخلي انحيازًا إيجابيًا لصالح هذه الصياغات في 76,2% من مجموعات البيانات. وفسّر هذا سبب تفاقم العادة داخل Nerdy، لكنه لم يفسّر سبب ظهورها خارج هذا النمط.
هنا حدث انتقال للسلوك. وبحسب بيانات OpenAI، عندما ازدادت الإشارات إلى goblin وgremlin داخل Nerdy، ازدادت بنسبة نسبية مماثلة تقريبًا في العينات التي لا تتضمن هذا الموجّه (prompt). بعبارة أخرى، بدأ الأسلوب المكافَأ محليًا يتسرّب إلى الأسلوب العام للنموذج. وهذه نقطة مهمة: فالعادة لم ترسخ بوصفها سمة لشخصية واحدة، بل بوصفها أسلوب إجابة عامًّا مقبولًا.
وتصف الشركة الآلية على النحو التالي:
- يُكافأ أسلوب الإجابة المرح
- يحتوي جزء من الأمثلة الناجحة على عادة لفظية مميزة
- تبدأ هذه العادة بالظهور بوتيرة أكبر في إجابات rollout الجديدة
- تدخل هذه الإجابات في بيانات supervised fine-tuning وبيانات التفضيل (preference data)
- يصبح النموذج أكثر ثقة في إعادة إنتاج الأسلوب نفسه
وأظهر فحص إضافي لبيانات SFT الخاصة بـ GPT-5.5 أن المسألة لم تقتصر على الغيلان فقط. ففي الأمثلة التدريبية وُجدت كائنات «إشارية» أخرى: الراكون والتروّل (trolls) والأوغر (ogres) والحمام. وفي المقابل تبيّن أن كلمة frog وردت في معظم الحالات بصورة طبيعية ومناسبة للسياق، أي أن المشكلة لم تكن في أي حيوانات أو صور خيالية، بل في نمط لفظي محدد ترسّخ. وبعبارة أخرى، كان قاموس الشذوذ أوسع مما بدا من الشكاوى الأولى.
كيف تعالج OpenAI المشكلة
بعد إطلاق GPT-5.4، أزالت الشركة نمط الشخصية Nerdy في مارس، وبدأت بالتوازي تصحيح مسار التدريب نفسه. فقد حُذفت من التدريب إشارة المكافأة التي كانت تحابي استعارات «الغيلان» بصورة خاصة، وبدأت تصفية البيانات التي تحتوي على كلمات الكائنات هذه، حتى لا تبالغ في تعزيز الأسلوب ولا تظهر في سياقات غير مناسبة. وهذا ليس تعديلًا شكليًا على السطح، بل محاولة لإزالة مصدر الشذوذ في منطق التدريب ذاته، قبل أن يترسخ الأثر أكثر.
ولم يكن ممكنًا تفادي الأثر كليًا منذ البداية: فقد بدأ تدريب GPT-5.5 قبل أن يصل الفريق إلى السبب الجذري. ولذلك أضافت OpenAI، في مرحلة الاختبار في Codex، تعليمات منفصلة للمطورين (developer instruction) تكبح هذه الصياغات. أي أن تعطيل Nerdy وحده لم يكن كافيًا. وعمليًا، تقرّ الشركة بأن حتى مكافأة (reward) ضيقة الضبط قد تتسرب إلى الأسلوب العام للنموذج وتبقى عبر عدة دورات تدريب، إذا لم يُرصد أثرها الجانبي في الوقت المناسب. وقد أصبحت هذه الحالة دافعًا للباحثين إلى بناء أدوات جديدة لتدقيق السلوك.
ماذا يعني هذا
لا تكمن أهمية قصة «الغيلان» في الغيلان نفسها، بل لأنها تُظهر نقطة ضعف في النماذج الحديثة: فمكافأة أسلوبية (stylistic) صغيرة في إعداد شخصية واحدة قد تغيّر لغة المنظومة بأكملها دون أن يلاحظ أحد. وهذه إشارة جيدة للمطورين إلى أن سلوك النماذج ينبغي تدقيقه لا بالمقاييس الكبيرة فقط، بل أيضًا بالعادات اللغوية الصغيرة التي تصبح لاحقًا منهجية. وهذه التفاصيل الصغيرة تحديدًا هي التي تكشف غالبًا أولًا عن انزياح خفي في التدريب.
- 29 أكتوبر 2026TokenRouter يسرّع التوجيه على مستوى الرمز بين النماذج حتى 64 ضعفًا
- 29 أكتوبر 2026Google تفتح Android Studio أمام وكلاء ذكاء اصطناعي من جهات أخرى: Claude وCodex وأكثر من 40 وكيلًا آخر
- 29 أكتوبر 2026Claude Code يمنتج الفيديو انطلاقًا من التفريغ النصي: كيف يعمل video-use الحاصل على 30 000 نجمة
- 29 أكتوبر 2026Anthropic تقدّم للشركات تقارير عن التوكنات: إنفاق العملاء ارتفع 9 أضعاف خلال عام
أسئلة وأجوبة حول الخبر
ما أبرز التفاصيل حول كيف اكتُشف الشذوذ؟
رصدت OpenAI أولى الإشارات الواضحة في نوفمبر، أي بعد إطلاق GPT-5.1. وكان الدافع شكاوى من المستخدمين بسبب نبرة النموذج المفرطة في الألفة وبعض المفردات المتكررة. وطلب أحد باحثي الأمان على وجه الخصوص التحقق من ورود كلمتي goblin وgremlin، لأنه صادف هذه الصياغات بنفسه أكثر من مرة. وعندما استخرج الفريق الإحصاءات، تبيّن أنه بعد إصدار GPT-5.1 صارت كلمة goblin تظهر في ChatGPT بمعدل أعلى بنسبة 175%، وكلمة gremlin بمعدل أعلى بنسبة 52%. لم يبدُ الأمر في البداية عطلًا خطيرًا؛ فقد تبدو الاستعارة المنفردة بريئة أو حتى طريفة. لكن الارتفاع في GPT-5.4 كان أوضح، وخلال الاختبار المبكر لـ GPT-5.
ما أبرز التفاصيل حول من أين جاءت الغيلان؟
وُجد الخيط الرئيسي في ميزة التخصيص. لاحظت OpenAI أن مفردات «الغيلان» كانت تظهر بصورة غير متناسبة عند المستخدمين الذين اختاروا نمط الشخصية Nerdy. ومع أن هذا النمط شكّل 2,5% فقط من جميع إجابات ChatGPT، فقد جاء منه 66,7% من جميع حالات ذكر goblin. وفي التعليمات النظامية لهذه الشخصية، طُلب من النموذج أن يكون مرحًا وحكيمًا وغريب الأطوار قليلًا، وأن يخفف الجدّية المفرطة بلغة مازحة (playful). وقد نقل هذا البحث عن السبب فورًا من دائرة التخمين إلى إشارة تدريب محددة. «العالم معقّد وغريب، وهذه الغرابة ينبغي الاعتراف بها وتحليلها بل والاستمتاع بها». ثم قارنت OpenAI بين الإجابات المولَّد
ما أبرز التفاصيل حول كيف تعالج OpenAI المشكلة؟
بعد إطلاق GPT-5.4، أزالت الشركة نمط الشخصية Nerdy في مارس، وبدأت بالتوازي تصحيح مسار التدريب نفسه. فقد حُذفت من التدريب إشارة المكافأة التي كانت تحابي استعارات «الغيلان» بصورة خاصة، وبدأت تصفية البيانات التي تحتوي على كلمات الكائنات هذه، حتى لا تبالغ في تعزيز الأسلوب ولا تظهر في سياقات غير مناسبة. وهذا ليس تعديلًا شكليًا على السطح، بل محاولة لإزالة مصدر الشذوذ في منطق التدريب ذاته، قبل أن يترسخ الأثر أكثر. ولم يكن ممكنًا تفادي الأثر كليًا منذ البداية: فقد بدأ تدريب GPT-5.5 قبل أن يصل الفريق إلى السبب الجذري. ولذلك أضافت OpenAI، في مرحلة الاختبار في Codex، تعليمات منفصلة للم
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.